Ресурсы: техническое описание TLS, LaTeX - в картинки (img), криптографическая библиотека Arduino, шифр "Кузнечик" на ассемблере AMD64/AVX и ARM64
Какую статистику могут собирать системы Let’s Encrypt, как крупнейшего, по количеству оконечных TLS-сертификатов, удостоверяющего центра (УЦ) в Интернете? Вроде, часть статистики очевидна – имена доменов, IP-адреса, которые вносятся в сертификаты, и т.д. Но можно “загадать” и неочевидные элементы.
Начнём, впрочем, с очевидных. Понятно, что любые имена, которые УЦ вносит в сертификаты, это предмет внутренней статистики: общее количество, количество сертификатов на имя, разбивка по дереву DNS. Тут, при разбивке, не только по доменам верхнего уровня нужно делить: куча сертификатов Let’s Encrypt выпускается для технических доменов четвёртого, пятого уровня, и даже ниже (максимум – десятый, это ограничение УЦ). Сюда же относится и срок действия выпущенного сертификата: сколько коротких, сколько – обычных, как это проецируется на имена.
Менее очевидные показатели. Прежде всего, проверка права управления ресурсом (именем). Тут напрашивается подсчёт вариантов: DNS, HTTP, ALPN и т.д. Всё с разбиением по типам сертификатов, по открытым ключам. Узлы, с которых запрашиваются ACME-проверки, обозначат IP-адреса источников ACME-запросов. В рамках проверки можно обнаружить, где размещаются проверяемые ресурсы: хостинг DNS, хостинг веб, распределение IP-адресов. Причём, можно построить соответствие адресов, на которых используется сертификат (см. ниже), с адресами, которые “засветились” в процессе проверки права управления.
Важна статистика по результатам проверки: успешно, не успешно, причины отказа. Данные по CAA-записям – какие имена, где размещены сами записи (не обязательно совпадает с DNS-DCV, потому что CAA-запись может быть выше уровнем).
И, конечно, всё с разбивкой по ACME-аккаунтам. Потому что каждый ACME-аккаунт имеет собственный набор идентификаторов (ключ, номер и т.д.).
Откуда тут вообще возьмутся IP-адреса, отличные от тех, которые, – возможно, – указаны в сертификатах? Прежде всего, ACME-клиент приходит с какого-то IP-адреса. Это можно зафиксировать и привязать к ACME-аккаунту. Когда DCV-подсистема проверяет право управления, эта подсистема осуществляет опрос DNS (во всех случаях, кроме, возможно, проверки управления конкретным IP-адресом) – IP-адреса авторитативных серверов DNS разных уровней тоже можно записывать. При проверке HTTP – запросы к веб-серверу отправляются по конкретным IP-адресам; если процесс связан с DNS-проверкой, то IP-адрес берётся из DNS, если с проверкой IP-адреса, то этот адрес указывается в заказе, отправленном по ACME. Соответственно, получаем ещё адреса, пригодные для включения в статистику. И эти адреса можно привязать к сертификатам, ключам, доменным именам.
Откуда взять IP-адреса узлов, на которых используется сертификат? Для сертификата, который выпущен для IP-адреса – очевидно: из самого сертификата. Для DNS-имён – чуть менее очевидно: заказ и получение сертификата не обязаны выполняться с тех же серверов, где сертификат будет использоваться. Однако всякий уважающий себя УЦ выполняет, при помощи специального бота, обход узлов, имена которых указаны в выпущенных сертификатах, как раз для того, чтобы вести статистику использования. Из этого процесса и возьмутся IP-адреса носителей. Если, конечно, соответствующие узлы доступны для бота.
Некоторую статистику можно было бы видеть по OCSP-респондерам, но их в Let’s Encrypt больше нет. Из действующих схем проверки статуса сертификата остаются списки отзыва (CRL). Соответственно, можно строить статистику запросов к точкам раздачи этих списков – с каких IP-адресов и какие именно CRL-файлы запрашивают. Ещё есть точки раздачи промежуточных и корневых сертификатов УЦ. Опять же, запросы к ним – дополнительный источник статистики.
Комментировать »
Как известно, буква S в аббревиатуре IoT означает Security (бзеопасность). Свежая публикация от Anthropic (компания из области AI/LLM, Claude) рассказывает о том, что “ИИ/LLM” смогут “самореплицироваться” и распространяться по IoT-системам. То есть, рассказывают, что вот теперь LLM будут свои наборы коэффициентов загружать на устройства типа “умных” пылесосов. Буквально, основная идея большой публикации по ссылке выше (с картинками!) в том, что, мол, LLM-агент взломает управляющую систему пылесоса, – или, может, даже холодильника, – перенесёт туда гигабайты своих коэффициентов, и запустит “инференс” на этом вновь захваченном устройстве, чтобы взламывать следующее. И это вызывает воспоминания о полиморфных вирусах для ПК под MS-DOS, появившихся в начале 90-х годов прошлого века, более тридцати лет назад.
Полиморфные вирусы “запаковывали” и зашифровывали основную свою программу, а распаковщик – генерировали разный, по шаблону, обычно. То есть, на новой системе у запакованного вируса не было статических сигнатур, за которые могла бы зацепиться антивирусная программа, осуществлявшая поиск. Ещё раз: после того, как вирус выбирал путь распространения на новую систему (через исполняемый файл-носитель, обычно), этот вирус генерировал собственный распаковщик, прикреплял к нему зашифрованное тело вируса, и записывал этот код на носитель, для распространения дальше. На новой системе вирус распаковывался, исследовал окружение, закреплялся в системе разными способами (их было где-то с десяток, некоторые – довольно изящные), и начинал собственное распространение.
“Полиморфность” – только одна из особенностей. Продвинутые компьютерные вирусы уже тридцать лет назад имели довольно сложную встроенную логику, позволявшую обнаруживать другие вирусы и блокировать конкурентов, обнаруживать и отключать/блокировать антивирусы, выбирать способ закрепления в системе согласно имеющейся конфигурации и т.д., и т.п. Были вирусы, которые могли переходить между разными типами систем. И никаких многогигабайтных LLM для этого не требовалось. Требовалось хорошее знание ассемблера и аппаратуры от разработчика (что и сейчас не помешает).
Естественно, в новости про саморасползающиеся через захват пылесосов LLM указано важное отличие: якобы, такой LLM-агент сможет атаковывать и заражать аппаратные архитектуры, с которыми раньше не сталкивался (но в качестве примера приводят Android почему-то). Не ясно, только, откуда же такой агент возьмёт описание этой новой аппаратной архитектуры и как сможет определить, что за архитектура в очередном пылесосе используется. Мог ли древний компьютерный вирус, разработанный под MS-DOS на x86 заразить SPARCstation под SunOS? Почему нет? Тут даже не нужен полноценный кросс-ассемблер – достаточно одного из аспектов реализации “полиморфности”: этот аспект сможет переводить машинный код с одной платформы на другую. Такие решения даже существовали, но, понятно, массовыми они быть не могли по другим причинам.
Комментировать »
Почему-то свежую (относительно) уязвимость в ядре FreeBSD (CVE-2026-101302), которая требует TLS 1.3 и находится в функциях KTLS (то есть, “выгрузки” обработки TLS-данных на сторону ядра), во внешних описаниях регулярно называют “сетевой уязвимостью”, просто позволяющей “обвалить ядро FreeBSD при помощи специального сетевого пакета, отправленного по TCP”. Это не совсем верно, и тут требуется небольшое поясение. Как сейчас модно говорить: “важен контекст”. И здесь “контекст” – в самом техническом смысле, а именно – TLS-контекст в ядре.
Данная уязвимость касается обработки именно TLS-записей в версии TLS 1.3, да ещё и после аутентификации и расшифрования полезной нагрузки. Другими словами, чтобы “проэксплуатировать” ветку кода с ошибкой (а там некорректная расчётная длина дополнения), атакующему требуется установленный в ядре TLS-контекст соединения и общие с атакуемым TLS-стеком секретные ключи. То есть, успешная атака требует, чтобы прошла аутентификация принятой TLS-записи. В TLS 1.3 здесь сначала проверяется целостность, а только потом данные расшифровываются.
Таким образом, штатная схема подразумевает, что стороны установили соединение и получили общий секрет, а потом можно отправлять “панические пакеты”. Просто так “налить панических пакетов” – не получится. Но это штатная схема. Естественно, для успешной атаки требуется подходящий TLS-контекст в атакуемом ядре, а не сам процесс установления соединения. Это понятно, забывать про это нельзя тоже. Да, подходящий TLS-контекст в ядре может быть установлен со стороны приложения без фактического выполнения полноценного TLS-соединения и отправки пакетов вообще, и вот тогда, да, специальный пакет с подходящей TLS-записью уже вызовет “панику” ядра. Что, конечно, тоже немало.
Комментировать »
В Let’s Encrypt обещают с 10 февраля 2027 года начать выпускать TLS-сертификаты на 64 дня, вместо 90-дневных. Это как раз через четыре месяца (плюс-минус), то есть, как раз закончат действовать 90-дневные сертификаты, выпущенные в первой трети ноября 2026. Процесс сокращения должен быть незаметным, но нужно заранее озаботиться автоматизацией мониторинга, проверив, что он настроен (не)правильно.
Замечу, что dxdt.blog я некоторое время назад перевёл на “сверхкороткие” сертификаты со сроком действия 160 часов, так что dxdt.blog сокращение с 90 к 64 дням не коснётся: тут и так уже меньше недели. Естественно, заказ, получение и вывод сертификата на веб-сервер dxdt.blog – полностью автоматические. И за эти несколько месяцев заметная проблема была только один раз: очередной сертификат не выпустился потому, что, из-за неполадок с измерением времени на виртуальной машине, отвалился и не сработал корректно скрипт по таймеру Systemd; ну а тот момент, что сертификат не выпустился, был, к сожалению, “пойман” лишь спустя пару часов после того, как текущий сертификат завершился. Это, конечно, проблема коротких сертификатов: времени на реагирование очень мало, dxdt.blog я администрирую сам, мне вот времени и не хватило (ну и, опять же, как только УЦ перестанет выпускать сертификаты для каких-то доменов, соответствующие сайты очень быстро “потухнут” для браузеров – тут уж ничего не поделать, система выстраивается так, что сертификат будет токеном доступа). Но, в целом, пока что всё работает.
Комментарии (2) »
Всегда удивляет, когда оценивают доступ к некоторому ресурсу по HTTP(S) – как доступ “только на чтение” (или “только на запись”). Речь про HTTP-клиента, который что-то загружает с “целевого” сервера. Удивительно, насколько сильно представление о “передаче данных” может абстрагироваться от реальных протоколов. Тот же HTTP – очень сложный протокол (и это даже без указания HTTP/2, HTTP/3), и там не бывает “только чтения”/”только записи”. Причём, в обе стороны. А ведь для того, чтобы получился HTTP, нужно ещё несколько слоёв пройти. И везде – сессии. А сессия – исключает “только чтение” или “только запись”.
Рассмотрим HTTPS-соединение в некоторых деталях. С этим соединением связан базовый набор транспортов. Он слоистый. У нас, – в этом примере, – HTTP работает через TLS, который работает через TCP.
Идём привычным образом справа налево. TCP – здесь есть установление соединения с подтверждением, это не “только чтение”, да ещё и каждый этап несёт потенциальные проблемы: отправка начального пакета клиентом (SYN) может вызвать проблемы в реализации TCP-стека на сервере (но, хотя бы, тут воздействие одностороннее, в привычном направлении: клиент что-то отправил на сервер – сервер сломался); первичный ответ сервера (SYN-ACK) – может привести уже к проблемам на клиенте, и это получается воздействие в обратном направлении, когда клиент пытался подключиться, но получил проблему в ответ; подтверждение от клиента (ACK) – опять отправляет что-то на сервер, но уже в привязке к состоянию сервера, то есть, увеличивается поверхность атаки (но направление – опять привычное, от клиента к серверу).
Да, TCP-стеки обычно довольно устойчивые. Но не всегда. Главное, уже на уровне TCP клиент не просто что-то отправляет на сервер, но и получает, так что не возможны ни схема “только чтение”, ни схема “только запись”. Обе стороны пишут/читают. Обе стороны обрабатывают внешние данные, присланные другой стороной. Обе стороны вынуждены работать в некотором контексте: клиент, когда получает SYN-ACK; сервер – когда получает ACK. И это ещё только на этапе установления соединения. Но в TCP есть ещё кадры, флаги, потеря пакетов и повторная отправка. И, заметьте, дело не дошло даже до начала TLS-сессии.
Если с TCP всё прошоло успешно, то TLS – следующий шаг. Опять есть процесс установления соединения. Клиент отправляет на сервер сложное сообщение (ClientHello и расширения), которое приводит к вызову криптографических библиотек на сервере; сервер отвечает ещё более сложным сообщением (ServerHello и расширения), обработка которого потребует сохранения состояния на стороне клиента. А ведь сообщения TLS разбиты по так называемым записям, которые тоже нужно корректно “распарсить”. То есть, сервер, справившись с TCP, начинает читать сложные структуры ClientHello, собрав их по TLS-записям. А клиент должен проделать то же самое, но со специально подготовленными внешними данным в контексте открываемой TLS-сессии. И опять неважно, что это клиент “что-то отправляет”: нет, чтобы что-то отправить, клиенту придётся обработать хитрое ServerHello, собрав его по записям и успешно “распарсив” структуры, которые могут логически указывать друг на друга, имеют отдельные вложенные заголовки и так далее. Тут уже немало возможностей сломать “отправляющий HTTP-запрос” клиент ещё до того, как HTTP даже начнёт работать и у клиента возникнет шанс на отправку HTTP-запроса.
И только если с TLS всё прошло успешно, появляется возможность отправлять HTTP-запросы и читать ответы. Естественно, внутри HTTP всё тоже не так уж просто: здесь есть редиректы, есть поля, задающие длину внешнего сообщения, при том что значения этих полей – тоже внешние данные, есть статусы, имена и заголовки. Тут тоже нет ни “только чтения”, ни “только записи”. Клиент, отправивший запрос, получит произвольный ответ и должен корректно “распарсить” его формат. А сервер, получив запрос, должен суметь не сломаться, если запрос имеет неожиданный формат. Но, хотя бы, это уже HTTP, с которого всё начиналось.
Комментировать »
На фото ниже – антикварная шведская шкатулка, явно предполагавшая использование двух замков.
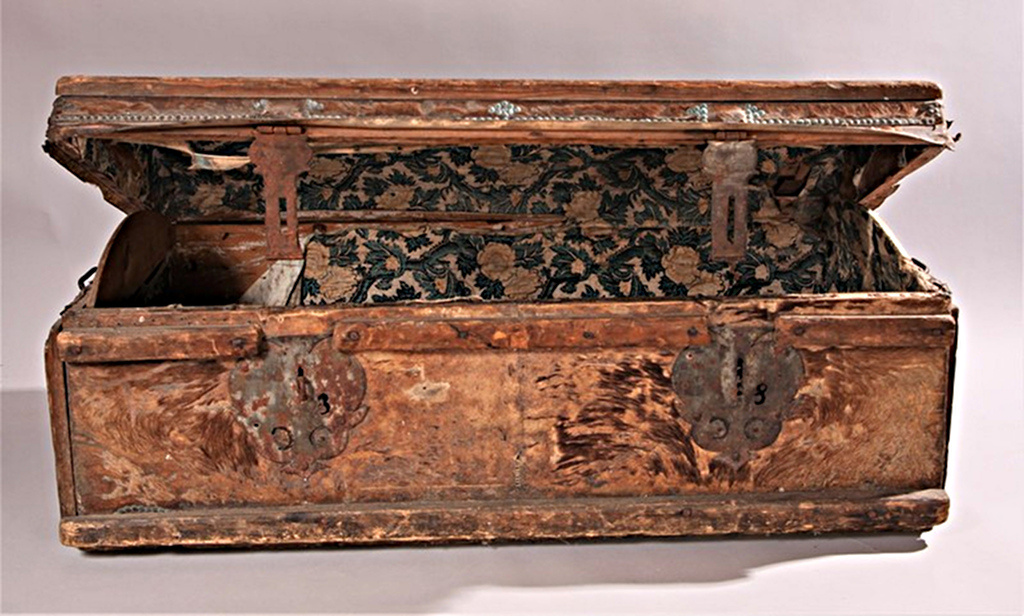
(Tomas Näslund/Vindelns hembygdsförening, источник; датировка не ясна, но, судя по всему, позже 18 века.)
Эта шкатулка явно не древняя, хоть и старинная, однако прочные сундуки и секретные коробки с двумя замками использовались ещё в древнем Риме. Сценарии использования могли быть разными.
Здесь эта фотография послужит иллюстрацией к схеме “протокриптографии”, которую я иногда привожу как пример древнего способа обмена секретными сведениями по открытому каналу без предварительного распределения ключей. И ключи здесь – это именно физические ключи. Сама схема, в принципе, известная. Но хорошо иллюстрирует особенности именнно инженерно-технической защиты информации в древности. То есть, сейчас принято считать контринтуитивной саму идею о том, что можно передать некие сведения между двумя сторонами, которые не имеют общего ключа, по открытому каналу так, что третья сторона не сможет простым способом получить доступ. Идея, может, и контринтуитивная, но, вообще говоря, подобную схему можно придумать, если посмотреть на шкатулки с двумя навесными замками.
Итак, сама схема. Есть две стороны, A и B. Сторона A хочет отправить стороне B секретную записку с недоверенным курьером. Общего механического ключа, – чтобы на стороне A запереть шкатулку, а отпереть на стороне B другой копией ключа, – нет. Как поступить?
Вот как: сторона A пишет записку и кладёт её в шкатулку, подобную той, что на фотографии, то есть с двумя местами для навесных замков. Закрыв шкатулку, A навешивает свой замок и оставляет у себя ключ. Запертая шкатулка отправляется “по открытому каналу” – то есть, с курьером стороне B. Сторона B шкатулку открыть не может – нет ключа, – но навешивает свой замок, от которого ключ есть, и отправляет шкатулку с двумя замками обратно. Сторона A, получив шкатулку, снимает свой замок, и снова отправляет запертую шкатулку стороне B. Теперь сторона B может снять свой замок и открыть шкатулку. Получилась схема обмена секретной запиской по открытому каналу без предварительного распределения ключей.
Что тут было бы предварительным распределением ключей? Да самое простое решение: сторона А и сторона B могли бы просто иметь копию ключа к одному замку, которым запирается шкатулка. Это простейший вариант. Если нужна схема посложнее, с разными ключами, то можно взять шкатулку со специальным замком: такой замок позволяет открыть шкатулку любым ключом из двух разных (этого несложно добиться: например, засов внутреннего замка на два ключа имеет два направления для открывания, каждое направление запирается “личинкой” под свой ключ). Понятно, что эти схемы сильно отличаются от исходной: один замок – два ключа. Ключ как-то нужно отправить второй стороне, если нет доверенного канала передачи ключа, то схема теряет секретность: ключ могут скопировать “на транзите”, и потом незаметно открыть шкатулку.
Какие есть особенности у схемы с двумя замками? Первая, самая главная: ключи не покидают пределы доверенного периметра. За периметр уходит только запертая шкатулка. Вторая особенность: заперев внутри шкатулки записку, сторона А уже не может поменять содержание записки, если шкатулка попала к стороне B. Третья особенность: сторона B – получит ту же самую записку, которая размещена в шкатулке изначально, но с двойным подтверждением, так как сторона-отправитель (сторона A) и поставила замок, и сняла его (подтверив, что есть ключ). Например, все эти особенности используются в статье “Покер в уме” (“Ментальный покер”, Shamir, Rivest, Adleman, MIT-LCS-TM-125, 1979), где и описана исходная схема (авторы указывают, что её предложил М. Рабин), но со многими шкатулками и для игральных карт.
К сожалению, схема работает только в том случае, если стороны обмена шкатулкой аутентифицированы! Описанная схема с двумя замками и шкатулкой подвержена классической атаке типа “человек посередине”. И в этом её основная техническая проблема. Но этот же момент сильно повышает дидактическую ценность схемы. До сих пор, говоря о том, что между сторонами существует открытый канал, мы подразумевали, что атакующий, просматривающий данный канал, пассивный – то есть, доставка шкатулки гарантируется: курьер не сможет удержаться от того, чтобы заглянуть в незапертую шкатулку и прочитать записку, но не станет менять процесс доставки. Активный же атакующий просто перехватывает шкатулку, навешивает свой замок, отправляет шкатулку обратно, получает снятый замок стороны A, открывает свой замок, читает записку, навешивает свой замок обратно и отправляет шкатулку стороне B, получателю. Естественно, с той лишь целью, чтобы потом выступить в роли стороны A, сняв по запросу свой замок.
Это, вообще говоря, неустранимая особенность подобных схем. Как ни странно, проявляется и в современной криптографии: например, такой же атаке подвержена схема Диффи-Хеллмана.
Каждая из сторон должна как-то убедиться, что обменивается шкатулкой именно с тем, с кем планировалось. Добиться этого при помощи лишь ключей и замков на шкатулке – не получится. Да, стороны могли бы знать и узнавать замки друг друга, но для этого стороны должны замки увидеть раньше. То есть, для первого обмена – не сработает. Зато сработает для повторных обменов: именно так, как сейчас действует механизм запоминания отпечатка ключа при первом контакте. Естественно, вариант со шкатулкой и двумя замками совсем теряет смысл, если использовать его повторно: если предполагается повторный обмен, то в первой итерации шкатулка должна содержать общий “секретный ключ”, который потом будет использован для другой шкатулки, с одним замком. Это сильно уменьшит трафик шкатулок (ср., например, с TLS и симметричными шифрами сейчас).
Естественно, помимо отметок на шкатулке и на самих замках, которые привязывают замок к шкатулке, стороны, обменивающиеся шкатулкой, могут приложить к ней письмо, в открытом виде, где подтвердят, что это именно они направляют шкатулку с конкретным замком. “Конкретность” замка тут, понятно, имеет исключительное, определяющее значение – иначе атакующий может просто подставить свой замок, сохранив сопроводительное письмо. Как узнать, что письмо подлинное? Например, по почерку. А почерк, предположим, может узнать человек, знакомый с каждым из участников. Получается система с доверенной третьей стороной (ср. например, с TLS-сертификатами и иерархией удостоверяющих центров).
В истории математической криптографии аналогичная схема известна как “трёхэтапный протокол Шамира”, который работает полностью аналогично шкатулке с замками, но шаг со снятием исходного замка возможен благодаря коммутативности используемой криптосистемы (см. Mental Poker по ссылке выше). В общем, очень полезная иллюстрация.
Комментировать »
В свежем Chrome 155 включена поддержка подписей ML-DSA в TLS-сертификатах (в том числе). Но не для корневых ключей, входящих в общую глобальную иерархию доверенных ключей, которая “коробочная” – то есть, не для WebPKI, а только для внутренних систем, с добавлением корневых ключей вручную: на сайтах и “из коробки” отдельные TLS-сертификаты с ML-DSA пока не планируются, а планируется, что будет добавлена сразу схема на хеш-деревьях.
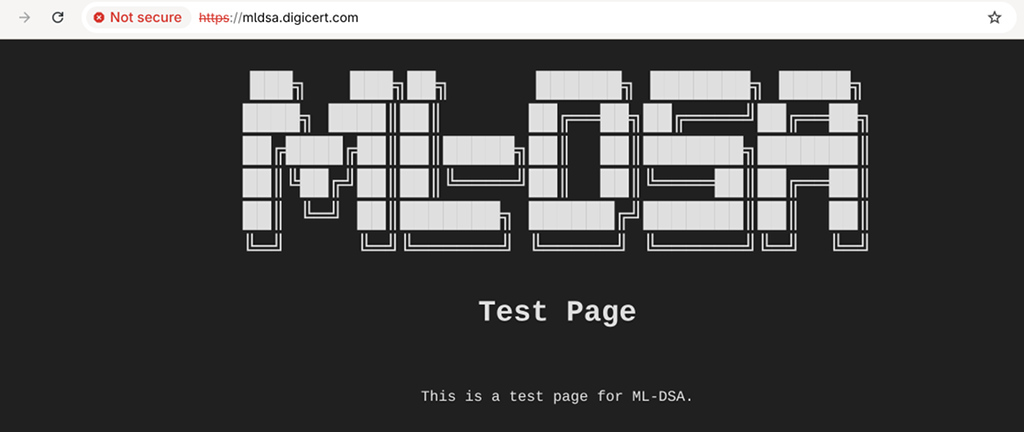
ML-DSA – это постквантовая криптосистема цифровой подписи. У DigiCert есть тестовый веб-сайт, где используется цепочка сертификатов с ML-DSA-подписями. Так что посмотреть на такие сертификаты можно даже браузером. Но без автоматической валидации. К сожалению, оконечный сертификат на веб-узле по ссылке не содержит SAN: вообще говоря, по современным спецификациям, да с точки зрения браузера, такой сертификат не валиден для веб-узла в TLS, безотносительно ML-DSA, поскольку строго требуется указание имени именно в SAN, а Subject/CN – давно не используется для проверки DNS-имени (но можно добавить исключение, конечно).
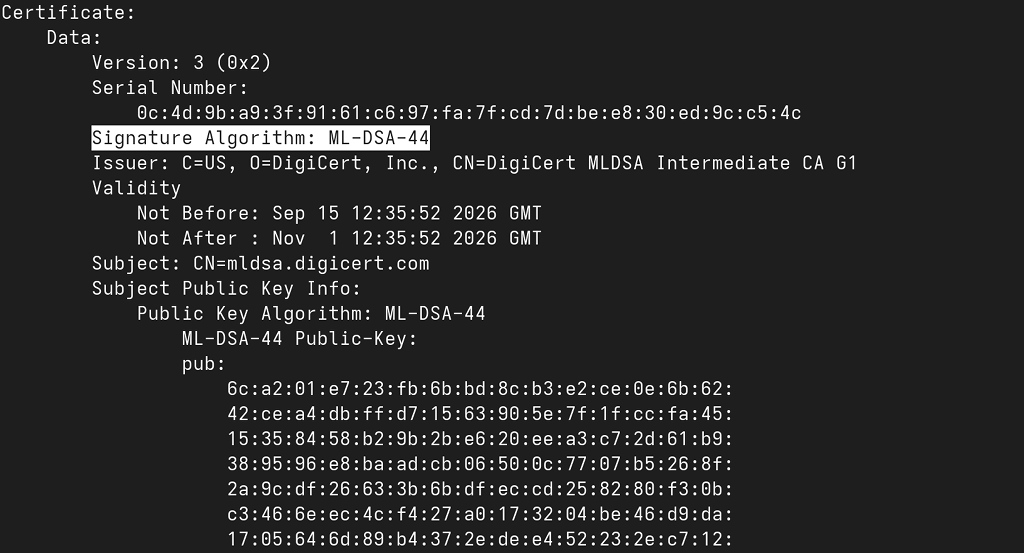
Другими словами: автоматически перейти на подобные сертификаты для веб-сайта пока что не получится, и не только потому, что никакой хорошо известный УЦ ещё их не поддерживает, но и потому, что не поддерживают браузеры. Но сделать собственную цепочку TLS-сертификатов с ML-DSA (и, кстати, CRL тоже), а потом попробовать, что произойдёт в Chrome свежей версии – уже можно: средства и спецификации есть.
И, ещё раз, не забывайте, что внедрение именно такого варианта в “общем вебе” даже не планируется. Доверенные УЦ сразу перейдут на MTC – сертификаты на хеш-деревьях. Там тоже используется ML-DSA, но схема совсем другая, и она позволяет вовсе не указывать подписи в самих оконечных (серверных) сертификатах.
Комментировать »
Пробное расшифрование – это хоть и вычислительно затратный, но типовой метод обнаружения подлинных попыток соединения на скрытом сервисе. При этом, если сервис правильно спроектирован, то и вычислительные затраты можно свести к весьма разумному уровню – процессоры сейчас мощные, тот же шифр AES – практически всегда на серверной стороне доступен в аппаратной реализации.
Основной принцип пробного расширования следующий: на сервер приходит внешний пакет, который может содержать данные для начального соединения от подлинного клиента – то есть, такое клиентское приветствие, позволяющее установить сетевое соединение и туннель, полностью зашифрованный. Сервер отвечает только на подлинные приветствия, а в ответ на поддельные – молчит. Здесь предполагается, что клиент и сервер уже знают общие симметричные секреты: обычно, это секретные ключи, настроенные в конфигурации и сервера, и клиента.
Содержание начального пакета данных должно быть вычислительно неотличимо от случайных данных (от шума) для внешнего наблюдателя. Это как раз и достигается тем, что данные зашифрованы. Но зашифрованы должны быть буквально все данные. То есть, тут не может быть некоторой структуры приветствия, как, например, в TLS: если пакет содержит некоторые заданные спецификацией поля (версию, идентификатор, таймстемп и пр.), то пассивный наблюдатель легко узнает протокол, к которому такой пакет относится. Поэтому видимой структуры быть не должно, но она может быть скрыта в зашифрованном блоке. (Тут еще есть транспортный аспект, типа TCP, об этом отдельно рассказано ниже.)
Но если пакет выглядит как шум, то что делать серверу? Тут как раз и начинается пробное расшифрование. Сервер пытается расшифровать полученные данные всеми известными ему клиентскими симметричными ключами. Внутри зашифрованного блока данных, – то есть, в открытом тексте, – уже содержится структура, которая и позволяет серверу понять, что расшифровано правильно – то есть, ключ найден верный. Это довольно хорошо отработанный подход, поэтому есть типовое решение: начальная часть открытого текста должна содержать достаточно длинный идентификатор клиента (например, 128 бит), этот же идентификатор сохраняется в таблице на стороне сервера, вместе с соотвествующими секретными ключами. Сервер перебирает эти ключи, расшифровывая пакет каждым.
Как только сервер, в результате расшифрования, получил идентификатор, совпавший с данными в таблице – сервер считает, что это начальное сообщение именно от того клиента, который указан в таблице. Это пока что предварительное решение, по схеме “в лоб”. С сетевой точки зрения, у данного решения есть сразу несколько больших недостатков, прежде всего – повторная отправка записанных пакетов. Мы недостатки сейчас рассмотрим и исправим. Но прежде всего важно заметить, что найден способ определить, что это за клиент стучится, приняв пакет, содержание которого выглядит для третьей стороны как поток байтов со случайными значениями.
Вероятность, что какой-то подставной пакет расшифруется так, что совпадёт и ключ, и идентификатор – настолько мала, что её можно не рассматривать. Тем более, что если так получится, то, для добротного шифра, это будет означать, что подставной клиент угадал ключ. Если же после всех вариантов расшифрования идентификатор клиента не найден, сервер отбрасывает пакет и не отвечает ничего. Да, обработка каждого входящего пакета требует выполнения многих операций расшифрования на сервере. Это неустранимая особенность: серверу придётся проверить данные по каждому клиенту. Если клиентов тысячи, то “невалидный” пакет сервер будет расшифровывать тысячи раз. Но, как отмечено выше, шифр AES нынче быстрый, а отправка наружу ответа о том, что пакет неверный – не требуется.
Теперь о других недостатках. Прежде всего, наивная схема зашифрования означает, что один и тот же клиент будет присылать одинаковый начальный пакет, потому что у клиента зафиксированы и значение ключа, и содержание пакета-приветствия. Это очень плохо, но легко исправляется, да ещё и сразу несколькими способами: например, в начало пакета в открытом виде записывается случайный вектор инициализации, который сервер использует при расшифровании (а клиент – при зашифровании). Этот вектор имеет фиксированную длину, но, поскольку значение вектора инициализации случайное, это не даёт никакой дополнительной различительной информации: к случайным данным прицепили случайные данные. Естественно, можно дописать изменяемый счётчик или слйчайный вектор внутри зашифрованных данных (см. ниже про таймстемп).
Следующий момент: если пакет имеет фиксированную длину, то при пассивном анализе можно зацепиться за эту длину. Решается тоже просто: к данным дописывается некий хвост-дополнение из случайных байтов, длина которого варьируется. Тогда у пакета образуется минимальная допустимая длина (поскольку должны войти данные приветствия), а практическая длина – изменяется от пакета к пакету. (Тут есть тонкий момент с контролем длины дополнения и дуплексным режимом для успешного соединения: дополнение нужно отбрасывать корректно, потому что иначе оно может попасть в начало следующего клиентского пакета. Но, опять же, оставим этот момент за пределами записки.)
Сервер знает длину полей в расшифрованных данных, знает, что поля идут одно за другим, может знать длину дополнения, поэтому просто отбрасывает это дополнение (где, после расшифрования, образуется некий мусор). Это всё самые простые способы, без аутентификации данных. Раз нет аутентификации, то кто-то может взять валидный пакет и дописать к нему что угодно в качестве дополнения, сделав некоторую метку. Сервер это “что угодно” вынужден будет расшифровать и если прочие данные сойдутся к валидным, то пакет будет принят в качестве приветствия. Это, на самом деле, не такая большая проблема: подобное тегирование мало что даёт, потому что для эффективного использования потребуется повторная отправка пакетов. И, опять же, есть несложное решение: используем код аутентификации сообщения, построенный на другом секретном ключе, а значение кода аутентификации дописываем в пакет. Сам код аутентификации тоже вычислительно неотличим от случайного (у нас случайный вектор инициализации), поэтому новых меток в пакете не появляется. Если аутентификация не сошлась для всех ключей, то пакет отбрасывается без дальнейшей обработки. В общем, это дополнительный затратный шаг на стороне сервера, который, в принципе, не требуется (внутри должна быть отдельная аутентификация – это другой аспект, там требуются асимметричные криптосистемы).
Только что была упомянута проблема повторной отправки валидных записанных приветствий. Третья сторона записывает трафик, выделяет валидные приветствия (это те, на которые сервер отправил ответ), а потом проигрывает эти приветствия в сторону сервера. В наивной схеме, действительно, такое сработает: сервер ответит. Однако, так как третья сторона не знает секретов, то она даже не сможет расшифровать ответ сервера. Впрочем, повторное проигрывание пакетов даёт некоторые новые направления для атак: во-первых, можно устроить зонд (connection probe), выявляющий действующие серверы – отправляем валидный пакет-приветствие на IP-адрес, если есть ответ, то там есть работающий по данному протоколу сервер; во-вторых, так как сервер вынужден на своей стороне открыть сессию, можно исчерпать доступные сессии на сервере; в-третьих, повторная отправка чужого приветствия может приводить к тому, что будет разорвано легитимное соединение того же клиента – а это уже неприятно, поскольку позволяет просто блокировать возможность использования протокола: фиксируем успешный обмен по ответу сервера – тут же отправляем ранее записанный пакет-приветствие в сторону сервера (это вообще один из хитрых моментов, который, впрочем, за пределами данной записки, посвящённой пробному расшифрованию).
Как бороться с вмешательством, котрое реализуется повторной отправкой начальных пакетов? К сожалению, эффективное противодействие – потребует некоторых дополнительных ресурсов: нужно на сервере вести таблицу состояний, – некий буфер, если точнее, – и отбрасывать все повторные пакеты по их значению (можно брать только начальные байты). А внутрь пакета-приветствия, в зашифрованную часть, нужно встроить таймстемп, и потребовать синхронного времени на клиенте и сервере. Тогда сервер ведёт запись о поступлении и успешной обработке недавних приветствий, прямые быстрые повторы – сразу отбрасывает (игнорирует), а если получено старое приветствие, то его придётся расшифровать, чтобы обнаружить, что оно устарело (по таймстемпу – тут речь о том, что допускается только расхождение на сколько-то секунд с сервером). Таким образом, проблема повторной отправки решается тоже.
Итак, в добротной реализации сервер ведёт себя тихо, с сетевой точки зрения, пока не получит валидный свежий пакет-приветствие, на который уже отвечает своим приветствием и далее может начаться сессия. Тут необходимо оговорить траспортный момент. Предположим, используется TCP. А в TCP есть собственная сессия. Соответственно, невозможно отказаться от установления TCP-сессии для того, чтобы получить начальный пакет на сервере. Это означает, что зонд может проверить доступность TCP-соединения. Конечно, само по себе TCP-соединение ещё не означает, что на сервере установлен искомый сервис, но, всё же, “наводит на мысли”. В принципе, если третья сторона анализирует трафик, то она так или иначе увидит, что к сервису кто-то подключается, поэтому само по себе TCP-зондирование ничего нового о работающем сервисе не расскажет, но вот найти подозрительный сервер-кандидат, который пока не работает, позволит. К сожалению, этот момент довольно трудно устранить. Есть способы типа port knocking (“секретный стук”), кроме того, можно ограничить доступ на уровне ядра ОС по IP-адресам источника. При этом TCP вообще позволяет несколько более эффективно ограничивать попытки повторных ложных подключений с одного IP-адреса. Но это всё полумеры.
Есть вариант с UDP. Поскольку этот протокол без сессий, то ложный зондирующий пакет будет оставлен сервером без ответа, а зонд вряд ли сможет отличить эту ситуацию от отсутствия сервиса (конечно, и тут есть свои оговорки, но от TCP – ситуация точно отличается очень существенно). UDP быстрее TCP, но могут быть проблемы с преодолением пограничных узлов, транслирующих адреса, и с тем, что в каких-то сетях UDP просто зафильтрован.
Комментировать »
Обычный вариант атаки MITM для TLS подразумевает, что у перехватывающего узла (прокси) есть секретный ключ от валидного серверного сертификата (ну и сам сертификат, естественно). Тогда перехватывающий узел выдаёт себя за настоящий TLS-сервер в сторону клиента, и за клиента – в сторону настоящего TLS-сервера.
В IP-сети всякий промежуточный узел может ответить вместо настоящего, так что в сетевом смысле атака не самая трудная. Получается, что TLS-сессия установлена не между клиентом и сервером, а превратилась в две TLS-сессии: одна – от клиента до перехватывающего узла, вторая – от перехватывающего узла до настоящего сервера. Промежуточный узел принимает трафик в обе стороны и видит его в открытом виде, так как TLS-соединение между клиентом и настоящим сервером не установлено, трафик никто не защищает.
На что тут влияет клиентская аутентификация в TLS? Вот на что: штатный способ аутентификации TLS-клиента сервером, – на этапе установления соединения, – подразумевает, что клиент подписывает все TLS-сообщения, которые были переданы до настоящего момента, а это означает, что перехватывающий узел не сможет получить корректную подпись для своей сессии в сторону подлинного сервера. Чтобы это сработало, сервер должен поддерживать клиентскую аутентификацию, конечно.
То есть, буквально, TLS-клиент при помощи секретного ключа подтверждает, что получил некоторые TLS-сообщения с конкретным содержанием (там побайтово все сообщения подаются на вход хеш-функции). В случае MITM, клиент подпишет те сообщения, которыми обменивался с перехватывающим узлом, с прокси. Но состав этих сообщений отличается от сообщений, которыми перехватывающий узел обменялся с подлинным сервером (см. ниже объяснения). Подлинный сервер же – видит лишь сообщения от перехватывающего узла (и свои собственные), соответственно, проверять клиентскую подпись он будет по этим сообщениям. Подпись, присланную клиентом, перехватывающий узел передаёт без изменений. Так как сообщения различаются, подпись не сойдётся. Перехватывающему узлу не известен секретный ключ клиента, поэтому перехватывающий узел не может подписать за клиента сообщения сессии в сторону подлинного сервера. Если же сообщения прокси передавал без изменений, то это означает, что перехвата TLS не случилось, а случилось обычное TLS-соединение и прокси не сможет раскрыть трафик.
Важная оговорка: это всё верно, но лишь без учёта возможности принудительного понижения стойкости – в принципе, перехватывающий узел, активно вмешиваясь в соединение, может вынудить стороны TLS согласовать заведомо нестойкие ключи и параметры протокола. Это позволит расшифровать трафик в пассивном режиме. Однако это совсем другая схема перехвата, она гораздо сложнее, клиенты типа современного браузера лучше защищены от применения подобных атак, а в TLS давно есть дополнительные индикаторы, помогающие такую атаку обнаружить, и т.д. В общем, в записке речь идёт о максимально простой схеме перехвата – с полной подменой узла.
А что если у перехватывающего узла есть подходящий секретный ключ и дверенный клиентский сертификат? Тогда – да, перехватывающий узел сможет выдать себя за аутентифицированного клиента в сторону подлинного сервера и продолжить прозрачный перехват, просто пригнорировав аутентификационный ответ прослушиваемого клиента.
Тут есть тонкий момент: нельзя забывать, что в TLS проверить корректность подписи и валидность клиентского сертификата должен подлинный сервер. Если сервер реально использует результат аутентификации клиента, то сессия с MITM – развалится (если у перехватывающего прокси нет клиентского секретного ключа). Но это именно особенность TLS. То есть, сервер должен всё проверять, но может и не проверить. Если сервер реально не проверяет значение клиентской подписи, то перехватывающий прокси может прислать что угодно похожее на подпись и TLS-соединение продолжит работать как обычно. Ну и тем более так будет, если сервер вообще не использует клиентской аутентификации в TLS (обычное дело).
И это приводит к следующим особенностям трансляции доверия через TLS. Предположим, что есть дополнительный прикладной протокол аутентификации, работающий через TLS, но не использующий встроенную в TLS клиентскую аутентификацию. Простейший вариант: клиент вводит пароль. Понятно, что тут MITM-прокси просто пересылает запрос на пароль клиенту, а пароль от клиента – пересылает серверу. Всё прозрачно работает, прокси узанёт пароль.
Более сложный вариант: у клиента есть секретный ключ для цифровой подписи, сервер верит в открытый ключ, соответствующий этому секретному. Сервер присылает запрос на подпись некоторых данных – клиент подписывает – сервер проверяет и убеждается, что у клиента есть секретный ключ, если всё сошлось – клиент аутентифицирован. Помешает ли это MITM-прокси? Нет, не помешает. Прокси, в рамках штатного перехвата трафика, просто копирует запрос сервера, пересылает его клиенту, получает от клиента подпись, передаёт её серверу – сработало, сервер аутентифицировал клиента и незаметил вмешательство прокси. Почему это работает? Потому, что тут аутентификация не привязана к транспортной сессии: сервер проверяет, что запросы поступают от стороны, имеющей доступ к секретному ключу, парному к доверенному открытому, но не проверяет, что транспортная сессия установлена с той же самой стороной.
Что это всё означает? Вот что: представьте, что клиент авторизуется через тот или иной механизм, использующий цифровую подпись, выполняемую на стороне клиента; эта схема, с точки зрения простого MITM-перехвата TLS, не даёт дополнительной защиты сессии. То есть, всё происходит на пару уровней выше TLS: клиент что-то подписал, сервер выдал клиенту авторизационный токен, этот токен виден на стороне MITM-прокси, теперь сторона с прокси может выдать себя за аутентифицированного клиента, подпись не требуется. Если подпись потребуется, то прокси перенаправит запрос клиенту. Да, по сравнению с паролем, тут есть некоторое преимущество: секретный ключ подписи не утекает наружу. Но, с другой стороны, выгода в плане защиты информации не так уж велика: ведь MITM-прокси может попросить клиента подписать что угодно, прикинувшись подлинным TLS-сервером при помощи перехватывающего TLS-сертификата.
Комментировать »
IANA уже выделила для ML-DSA-44 номер 18 в индексе криптосистем DNSSEC. ML-DSA – это постквантовая криптосистема подписи, родственная ML-KEM, а цифры 4 в обозначении – это идентификатор используемого набора параметров, самого “короткого”. Применение данной квантовостойкой криптосистемы в DNSSEC описано в свежем черновике RFC (Westerbaan/Schmieg), и проверка ML-DSA-подписей уже есть в DNS-сервисе 1.1.1.1. Пример DNS-зоны с ML-DSA-подписью: only.alg18.westerbaan.name. (Большая редкость, понятно.)
Конкретно с этим алгоритмом основная проблема в том, что пусть 44-й вариант и самый “короткий”, но подпись всё равно занимает 2420 байта, а открытый ключ – 1312 байтов. То есть, для передачи данных всё равно потребуется TCP. Естественно, поддержка TCP необходима для работы DNS, но UDP всё ещё остаётся основным транспортом для простых DNS-ответов. Впрочем, возможно, что внедрение посткантовых криптосистем окончательно UDP вытеснит (конечно, UDP – быстрый протокол, но и для TCP есть Fast Open).
Тут можно заметить, что если у вас используется сервис DNS (рекурсивного резолвера) типа 1.1.1.1, то, скорее всего, к нему ваш системный резолвер уже и так подключается по TCP. И действительно, нынче сетевые реалии таковы, что DNS over TLS становится необходимостью, из-за подмены DNS-трафика. Ну а где TLS – там всё равно TCP. Однако не забывайте, что здесь речь-то идёт не о подключении клиента к рекурсивному резолверу, не о “последней миле”, а о том, как резолвер подключается к авторитативным серверам, о “внешем плече”. И вот там, чтобы получить ответ с ключами (DNSKEY) и подписями (RRSIG) ML-DSA, потребуется получить от авторитативных серверов по несколько килобайт данных. Если сравнить с ECDSA, то и трафик увеличивается в десятки раз, и TCP приобретает дополнительный вес. Ну и в типичной конфигурации валидацию DNSSEC-записей выполняет внешний резолвер, не системный.
Занятно, что внедрение ML-DSA в DNSSEC для зон ниже корневой, при том, что в корневой зоне используется не постквантовая криптосистема, – смысла имеет не так много, как можно подумать. Конечно, можно наладить собственную валидацию и проверять конкретные подписи, а ключам верить по значению. Но это не совсем то, чего ожидают от глобального дерева DNSSEC. А в корневой зоне сейчас RSA, а переходить – планируют на ECDSA.
Комментировать »
Вот уже два с половиной месяца на dxdt.blog используются короткоживущие TLS-сертификаты от Let’s Encrypt – серверный сертификат валиден 160 часов, новый сертификат, при штатной работе, выпускается каждые двое суток, а старый – отзывается со статусом Superseded. Поделюсь некоторым опытом.
Для короткоживущих сертификатов мониторинг необходим даже больше, чем для “обычных”. Потому что отслеживать нужно событие замены сертификата через каждые два дня: если сертификат не заменился, то “что-то пошло не так” и нужно срочно смотреть, что именно, ведь срок действия сертификата совсем небольшой. Многие типовые решения для мониторинга не приспособлены для короткоживущих сертификатов.
Серверные TLS-сертификаты данного УЦ и данного типа более не содержат имени в поле Subject. Это необходимо учитывать в мониторинге. (Обратите, кстати, внимание на этот момент – как ни странно, но мне до сих пор приходится сталкиваться со скриптами и схемами мониторинга, которые по старинке полагаются на значение Subject серверного сертификата при определении имени. Если в сертификате поле Subject пустое, такие скрипты не просто не работают, но часто вообще начинают действовать неверно – потому что пустое значение даёт интересные эффекты при попытках его обработки. Как переделать shell-скрипты, использующие OpenSSL, описано в одной из записок по теме.)
В остальном – работает неплохо. Кроме dxdt.blog, я нашёл применение для шестидневных сертификатов там, где нужен TLS-сертификат для IP-адреса. Так, у меня есть демонстрационный сайт под IP-адресом: https://185.39.19.199/ – там TLS-сертификат обновляется certbot со штатными настройками. Также я использую TLS-сертификаты для IP-адресов на некотором DNS-стенде, где такие сертификаты очень хорошо подходят для авторитативных серверов DNS (DNS over TLS: см., например, тестовый сервис для резолверов dns.1d.pw).
Комментировать »
 Новый
