Ресурсы: техническое описание TLS, LaTeX - в картинки (img), криптографическая библиотека Arduino, шифр "Кузнечик" на ассемблере AMD64/AVX и ARM64
У меня на сайте используется открытый ключ, который начинается с 0xDEADC0DE. Но вообще-то TLS-сертификат может служить и носителем целого текстового сообщения-декларации. Получается что-то вроде документа, который протестует против инфраструктуры УЦ, сложившейся в вебе. Создание такого сертификата описано на сайте Maurycyz.com. Текст сообщения виден в Base64, то есть, чтобы его прочитать – нужно вывести серверный сертификат в PEM (PEM представляет собой Base64-запись DER-представления, помещённую между текстовыми строками вида “BEGIN/END”). Выглядит это так:
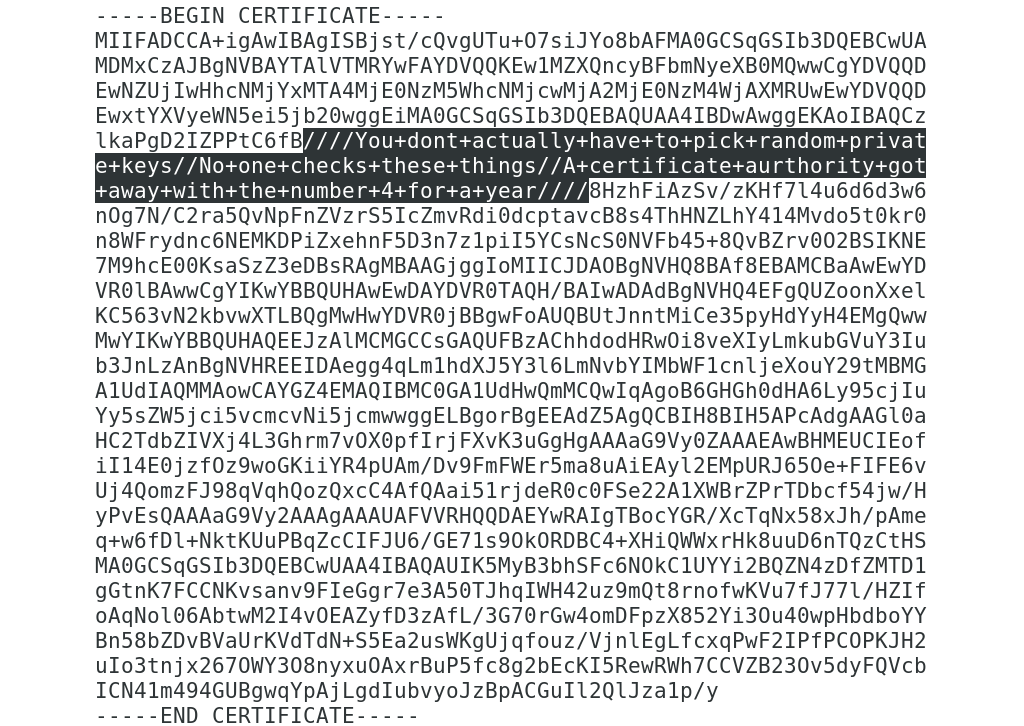
Работает это вот почему: опубликованная строка текста является корректным Base64-кодом; сертификат использует RSA, значение модуля ключа RSA можно подобрать под нужный код Base64 обратным преобразованием, вычислив подходящий простой делитель, это вычислительно быстро, так как исходная факторизация известна (детали есть по ссылке выше).
Комментировать »
Смотрел код библиотеки Go crypto/x509 на предмет того, как там разбираются конкретные поля сертификата. Сразу наткнулся в parser.go на опечатку в стиле copy-paste: текст ошибки при некорректном Subject взят из блока, где так же обрабатывается Issuer; соответственно, текст сообщения об ошибке вводит в заблуждение – при некорректном поле Subject будет выведено, что “x509: malformed issuer”, а должно быть: “x509: malformed subject”.
Ну, думаю, исправление одной строчки – отправлю коммит через социальную сеть GitHub, потому что у меня там есть аккаунт всё равно (что поделать). Внёс исправление, подготовил pull request (черновик). Однако в черновик pull request (PR) сразу бот от Go написал, что, мол, для рассмотрения PR мне нужно какую-то дополнительную лицензию Google CLA подтвердить (забавно, да – уже для рассмотрения). Закрыл PR тут же. Может, кто ещё исправит.
Комментарии (6) »
Кстати, что касается выгруженной OpenAI огромной пачки (больше 700 статей!) сгенерированных ИИ/LLM “решений важных математических задач”, которую уже называют “математическим” “помойкалипсисом” (Slopocalypse). В. И. Арнольд в статье “Что такое математика”, – которая выходила в виде книги, например, в 2002 году, – в подразделе, который называется “Математическое мракобесие против Абеля и Пуанкаре”, пересказывает определение математики “по Ю. И. Манину” (и Арнольд, и Манин – среди крупнейших математиков 20-го века). Пара цитат из статьи Арнольда:
“Математика, согласно Манину, – это отрасль лингвистики или филологии, занимающаяся преобразованием конечных цепочек символов некоторого конечного алфавита в другие такие цепочки при помощи конечного числа “грамматических” правил. Отличие от естественных языков, вроде китайского, английского или русского, состоит лишь в том, что в грамматике этого специального языка есть отсутствующие в живых языках правила (например, набор символов “1+2” можно заменить на символ “3”).”
“[…]ведь если в результате игры с символами и получается что-либо полезное, то это просто означает, что оно содержалось уже в исходных предпосылках”.
Дальше там речь про искусство “претендовать на открытия, которых не совершал” и т.д. Понятно, в этом есть существенная доля специального юмора и сарказма. И, понятно, в той статье и речи не идёт про ИИ-генерирование. Но всё же – удивительно, как хорошо подходит к текущей ситуации, заведённой OpenAI. Многие надеялись использовать новый мощный инструмент для того, чтобы с его помощью выпускать пачки собственных статей. Но сейчас всё выглядит так, что беспилотный бульдозер OpenAI запустили в самостоятельное приключение, и вот он уже едет сносить домики в университетских кампусах.
Комментировать »
Монета в один доллар с изображением президента Трампа (действующего, между прочим) называется Semiquincentennial Dollar.
Здесь занимательно слово semiquincentennial – то есть, это полу- (semi) пяти- (quin) вековой (centennial) – “полупятивековой” доллар (не только с Трампом, не только доллар, хотя доллар с Трампом – максимально странный).
“Полупятивековой” – это половина от 500 лет. Довольно забавный способ именования, конечно. На горизонте пяти сотен лет – довольно странно отмечать половину отдельным словом, тем более, когда это история независимости от Англии. Независимость от королевства, заметьте, но на юбилейной монете изображение действующего президента, что не совсем типично для США (а в Англии – на монетах король).
И ведь можно было бы назвать “четвертьтысячелетний” – quartamillenium, а ещё лучше – quartamilliarum (тут даже немного повеяло игровой вселенной Warhammer, которая про Великобританию, впрочем).
Понятно, что латинская классическая форма, конечно, это никакой не “миллениум”, а просто ducenti quinquaginta anni – двести пятьдесят лет.
Комментировать »
Traffic Control. Имеется в виду трафик на дорогах. Механическая интерактивная детская игра. 1959 год. За 24 года до Интернета. Сделано из жести, с жестяными же автомобильчиками и автобусом, всё качественно раскрашено. (Не моё, ссылка на исходное видео с обзором – ниже.)
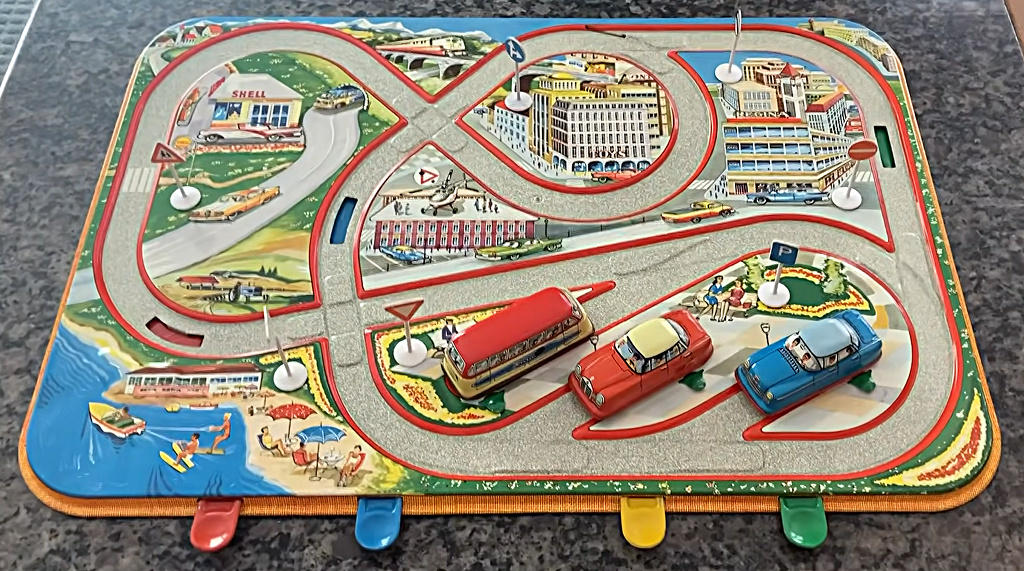
(Скриншот из видео, joe martella, Youtube.)
Автобус и автомобили – заводные, запускаются с парковки и едут по дорогам. Движением транспортных средств нужно управлять при помощи цветных кнопок (или клавиш), которые видны снизу. Подробное видео работы игрушки есть в обзоре (англ., Youtube). Довольно занимательное решение, между прочим. Немалая игровая ценность образуется из одного единственного приёма – это поворот наверху, позволяющий перенаправлять траспортное средство на разные петли: движение прямо или правый поворот.
Комментировать »
Ещё из серии “Забавные истории с LLM”. Снова Claude. Так как на пути программного кода возводятся неожиданные “кибербезопасные препоны” (cybersecurity guardrails), я тут на днях решил попробовать задачи из области теоретической математики: там есть Lean (это инструмент описания и проверки “компьютерных доказательств”), но не должно быть “кибербезопасных препон для безопасной безопасности”. На роль примера я наобум выбрал задачу 11.115 из “Коуровской тетради” (этот широко известный в узких кругах канонический список я упоминал ранее; как оказалось, не зря упоминал). Я набросал общее описание контрпримера к задаче, в меру собственного понимания, и попросил Claude найти конкретный контрпример и подготовить соответствующее доказательство на Lean.
Система Claude существует в нескольких LLM-воплощениях, доступны мне не все, но основные, как я понимаю, доступны. Сперва я задал запрос в Fable 5. Оно почему-то зациклилось и кружилось внутри себя, наступая периодически на “лимит вызова команд”, очень долго. Наверное, часа два. Никакого результата не выдало, но “кредиты” съело (неплохая “бизнес-модель”, кстати: показываем “юзеру” какие-то меняющиеся текстовые строки в браузере через Javascript и списываем за это “кредиты” в огромных количествах). Но не будем торопиться с выводами.
Потом я решил запустить в той же ветке Opus 5 Max. Как ни странно, Opus 5 Max довольно быстро нашло контрпример (да! и очень даже похожий на правду – см. ниже), но совсем не осилило Lean. Код Lean содержал какие-то вымышленные имена теорем, которых нет в библиотеках (я не очень хорошо понимаю Lean, но, думаю, тут всё именно так). Claude Opus 5 Max – объяснило, что на своей стороне не может компилировать Lean-код: нет среды и не хватает места, чтобы развернуть из пакетов. Но без машинного доказательства все рассуждения LLM, даже такой сверхмощной, о контрпримере, даже для такой простой задачи, – мне, к сожалению, не очень-то полезны (мой план-то был другим: попытаться вручную из корректного Lean-кода восстановить привычное математическое описание контрпримера).
Казалось бы, всё опять застопорилось.
Но нет. Внезапно Anthropic выпустили Fable 5.1. Буквально, вчера. Якобы, Fable 5.1 “сильно лучше в исследовательских задачах”, чем предыдущая Fable 5. Без особой надежды на успех, попробовал я в том же чате, со сломанным Lean, запустить Fable 5.1. Как ни странно, но оно бодро заявило, что сейчас в коде Lean оставит только те библиотеки (import), которые реально нужны для этого доказательства. Это логично. И, – возможно, – среда Lean c этими библиотеками влезет в доступные гигабайты контейнера на стороне Claude, так предположило Fable 5.1. После чего, как ни странно, действительно “урезало библиотеки” и действительно исправило ошибки в Lean-коде, так что стало понятно, что имеется в виду. В итоге, выдан файл с Lean-кодом, который уже компилируется и корректен со всех точек зрения, кроме того, что там могут быть неверные исходные допущения, но это я планирую проверить позже. Так вот.
(На всякий случай: если код и контрпример окажутся правильными, то, да, это будет решение для 11.115, которая пока что отмечена в тетради как открытая. Задачу я выбрал случайно, а критерием было то, что я сам смогу быстро написать условия на контрпример – поэтому-то и задача выбрана очень простая по формулировке и составу используемых объектов. Да, LLM-системы развиваются. Но тут и контрпример – какой-то подозрительно очевидный; если кому-то интересны супертехнические подробности, то вот: построим подгруппу на словах с чётными и нечётными степенями (это отображение в Z/2Z), и подгруппу на соотношениях с a^2. Код Lean я пока не публикую, поскольку не проверил, да и это всё может оказаться “подтягиванием” другого результата, который просто забыли упомянуть составители сборника.)
Комментировать »
Самое длинное задокументированное слово на древнегреческом, как считается, это вымышленное название кулинарного блюда из комедии Аристофана (название которой должно бы звучать на русском как “Экклезиастки”, но это другая тема). Слово содержит около 170 букв. Почему – “около”? Потому что количество букв зависит от прочтения и трактовок. Это слово полностью искусственное, даже если его выдумал Аристофан, но оно достаточно популярно, чтобы войти в словари. Вот я сфотографировал соответствующую статью на странице подлинного словаря Дворецкого:
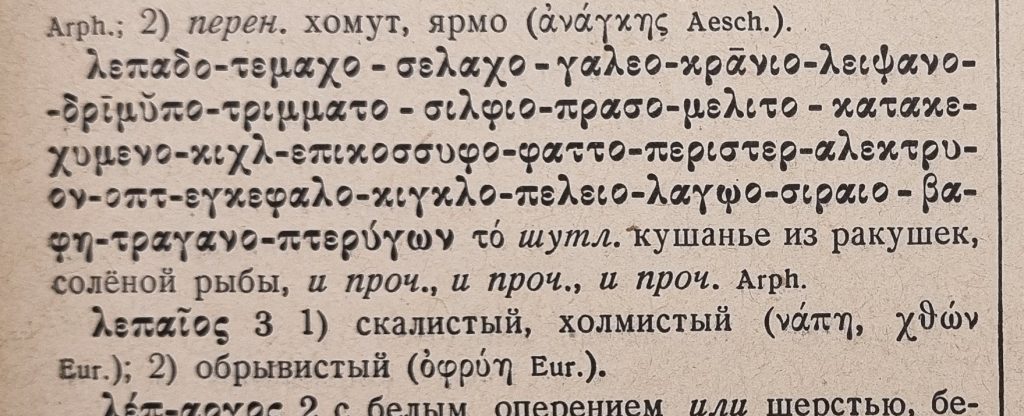
Как говорится: “и прочая, и прочая, и прочая”. В буквах эта версия выглядит, примерно, так:
λεπαδο-τεμαχο-σελαχο-γαλεο-κρᾱνιο-λειψανο-δρῑμ-ῠπο-τριμματο-σιλφιο-πρασο-μελιτο-κατακεχυ-μενο-κιχλ-επι-κοσσυφο-φαττο-περιστερ-αλεκτρυον-οπτ-εγκεφαλο-κιγκλο-πελειο-λαγῳο-σιραιο-βαφη-τραγανο-πτερύγων. (Но записывается без дефисов. Дефисы тут для упрощения отображения.)
Что это вообще такое? Строго говоря, это и не слово никакое, это некоторое составное существительное, которое древнегреческий позволяет сделать, в стиле “моллюсково-рыбо-цыплёночно-плавниковое-желе” ну и прочая, и прочие “запечён(н)ые мозги”. Некоторые составляющие этого слова в разные годы и в разных источниках читали по-разному, откуда, например, λεπαδο- против λοπαδο- в самом начале, и καραβο- против πρασο- (странно, конечно, но можно представить) в середине.
Вообще, это название иногда переводят в виде самостоятельного стиха, иногда – в виде такого же многобуквенного составного существительного, как и оригинал. Но, понятно, в сложном переводе тут смысла просто нет – данное лингвистическое построение ценно само по себе. А скан исходного манускрипта, чтобы был старше девяти веков хотя бы, да включал это слово, найти пока не удалось, поэтому перевод я тут и не привожу – не ясно, что там в исходнике.
Комментировать »
Вновь пишут про успехи ИИ/LLM-систем “олимпиадного уровня”, на этот раз – про набор из задач Международной лингвистической олимпиады (IOL), где LLM-система Claude Opus 4.8 показывает “результат уровня золотой медали”.
Странно всё это.
Я некоторое время использую Claude Opus 5 Max, которая, вроде как, должна быть получше. Cправедливости ради, необходимо отметить, что вот программный код, – при компактной задаче и наличии подробнейшего пошагового описания того, что и как должна делать программа, – оно генерирует неплохой (пусть и не всегда, но – почти всегда неплохой; возможно, если доступ не отберут, я как-нибудь поделюсь впечатлениями). Однако вот языковая логика (не языка программирования, а естественная) – нередко хромает. На все три ноги из двух.
Так, недавно эта система выдала мне заведомую “дихотомию”, но с третьим вариантом. Да. Буквально:
если вы знаете пароль – тогда, [blah blah blah, текст про этот вариант];
если вы не знаете пароль – тогда, [blah blah blah, текст про вариант, когда пароль не знаем];
если ни то, ни другое (neither) – [blah blah blah, произвольный текст, который, понятно, не может относиться к поставленной задаче, где мы либо знаем пароль, либо не знаем пароль].
Но, оказывается, уровень “золотой медали” по языковым задачам был у прошлой модели. Как говорится: “что-то тут не так”. Продолжаем наблюдение.
Комментарии (2) »
Кстати, в доменной зоне google.com есть TXT-запись со значением “Z29vZ2xl”. Проверьте:
$ dig -t TXT google.com +short | grep 'Z29'
"Z29vZ2xl"
“Z29vZ2xl” это ASCII-представление строки “google” в Base64.
$ echo -n "google" | base64
Z29vZ2xl
Комментировать »
Довелось тут получить доступ к LLM-ИИ Fable 5 от Anthropic. Это та самая модель, которую усиленно продвигают в рамках хайпа под условным названием “Находит все уязвимости, вырывается из песочниц, это так опасно, что нельзя открывать”. Сейчас доступ там, как бы, “открыт” (в кавычках, да; см. ниже). Но всё равно требуется отдельная оплата за токены для Fable 5 (помимо других моделей), так как маркетинг там не спит. И не спит он хорошо – в оба глаза: потому что ещё и реальный-то доступ, в канве “так опасно и уязвимости”, – отсутствует до сих пор.
А именно: я, – предполгая, что вот это ж последний писк моды перед наступлением “сверхразумного ИИ”, – быстро сочинил криптографическую схему разделения секрета, “два из трёх”, базирующуюся на сложности задач факторизации и обращения хеш-функций (нормальная схема, подходит профильным студентам), набросал довольно подробное описание (англ.) и направил результат в Fable 5 “на максималках” (это что в веб-интерфейсе называется Fable 5 Max). Запрос я сопроводил предложением найти дефекты и предложить улучшения (опять же – типовая задача для студентов старших курсов). В схеме была, как минимум, одна “особенность”, которую легко обнаружить (и устранить), пара менее очевидных “моментов” и, вероятно, ещё какие-нибудь существенные недостатки. “Вот как их сейчас все выявит эта супермощная ИИ-система! Ух!”
К сожалению, это было долгое вступление к быстрому и банальному финалу: разрекламированная Fable 5, в ответ на запрос, выдала сообщение, что, мол, сей запрос был отмечен их “ограничениями для безопасности” (“safeguards flagged this message”), поэтому, для получения возможности продолжить, нужно мне, как пользователю, подать заявку в какую-то там очередную программу (Cyber Verification Program), а для этого – заполнить анкету. Так-то. Не сказать, что ловкий, но вполне себе типовой маркетинговый заход “на хайпе”.
Занятно, кстати, что Opus 5, предыдущая модель той же системы Anthropic, похоже, выдаёт результаты не хуже (как минимум, оно уже знает множественную форму слова “дно”), но дополнительных “токенов” при этом не потребляет, хоть и работает заметно медленнее (но это может быть искусственная задержка на стороне сервиса).
Маркетинг хайпа.
Комментировать »
Вот ещё какой интересный аспект внедрения ИИ/LLM. Бывает, приходится описывать какие-то варианты как следует что-то сделать правильно, в плане серверной/сервисной архитектуры и информационной безопасности, но реализовывать описанное – не спешат: мол, это непонятно, это сложно, нет инженерных ресурсов и т.д. До топ-менеджмента данные вопросы и описания не добираются (что, конечно, правильно, потому что вопрос достаточно специальный, достаточно “локальный” и может решаться горизонтальными связями).
А потом кто-то из топ-менеджмента берёт LLM/ИИ, как это сейчас модно, и задаёт этому ИИ/LLM те же вопросы. А результаты, сгенерированные LLM, мягко и без навязывания присылает “на посмотреть”: мол, мало ли – вдруг там что дельное. И вот выдача ИИ, конечно, содержит и вполне себе бредовые фрагменты, куда ж без этого. Однако немало что сгенерировано, примерно, по делу, слова правильные. Опять же – кто бы сомневался: база, использованная для “обучения” LLM, содержала ведь и разумные вещи тоже. И вот эта часть, которая по делу, практически повторяет то, что уже было и так много раз говорено раньше, без всякого ИИ, но не реализовывалось (“непонятно, не нужно, устарело, нет ресурсов”).
И если вы вдруг сейчас подумали, что выдача ИИ тут же придаёт дополнительный вес уже озвученным идеям, то, к сожалению, вы ошиблись: всё хуже – теперь тем, кто против, можно сослаться, что, мол, да это ж вообще “механический болван” (ИИ/LLM) написал, слово в слово, и, мол, “говорили же, что не нужно, а механического болвана использовать следует с большой осторожностью” (да; тут и не поспорить). Но вот выдача-то “ИИ-болвана” оказалась правильной – такое может быть.
“Трудно стало работать. Развелось много идиотов, говорящих правильные слова” (Штирлиц, цитата по фильму “Семнадцать мгновений весны”).
Комментировать »
 Новый
