Ресурсы: техническое описание TLS, LaTeX - в картинки (img), криптографическая библиотека Arduino, шифр "Кузнечик" на ассемблере AMD64/AVX и ARM64
В свежем Chrome 155 включена поддержка подписей ML-DSA в TLS-сертификатах (в том числе). Но не для корневых ключей, входящих в общую глобальную иерархию доверенных ключей, которая “коробочная” – то есть, не для WebPKI, а только для внутренних систем, с добавлением корневых ключей вручную: на сайтах и “из коробки” отдельные TLS-сертификаты с ML-DSA пока не планируются, а планируется, что будет добавлена сразу схема на хеш-деревьях.
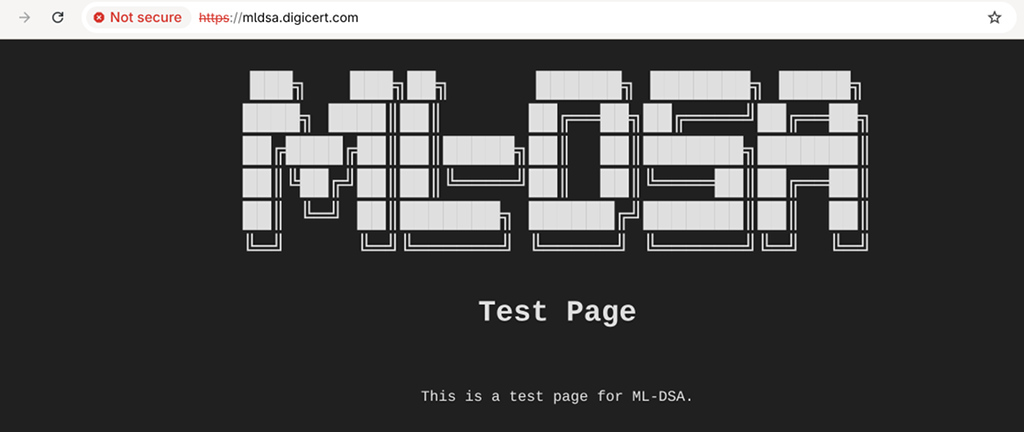
ML-DSA – это постквантовая криптосистема цифровой подписи. У DigiCert есть тестовый веб-сайт, где используется цепочка сертификатов с ML-DSA-подписями. Так что посмотреть на такие сертификаты можно даже браузером. Но без автоматической валидации. К сожалению, оконечный сертификат на веб-узле по ссылке не содержит SAN: вообще говоря, по современным спецификациям, да с точки зрения браузера, такой сертификат не валиден для веб-узла в TLS, безотносительно ML-DSA, поскольку строго требуется указание имени именно в SAN, а Subject/CN – давно не используется для проверки DNS-имени (но можно добавить исключение, конечно).
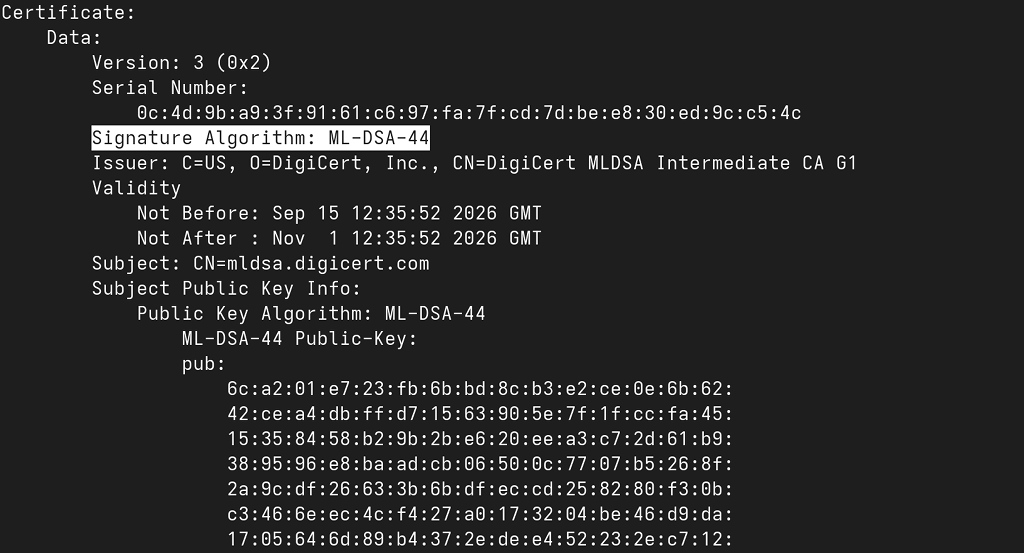
Другими словами: автоматически перейти на подобные сертификаты для веб-сайта пока что не получится, и не только потому, что никакой хорошо известный УЦ ещё их не поддерживает, но и потому, что не поддерживают браузеры. Но сделать собственную цепочку TLS-сертификатов с ML-DSA (и, кстати, CRL тоже), а потом попробовать, что произойдёт в Chrome свежей версии – уже можно: средства и спецификации есть.
И, ещё раз, не забывайте, что внедрение именно такого варианта в “общем вебе” даже не планируется. Доверенные УЦ сразу перейдут на MTC – сертификаты на хеш-деревьях. Там тоже используется ML-DSA, но схема совсем другая, и она позволяет вовсе не указывать подписи в самих оконечных (серверных) сертификатах.
Комментировать »
Небольшой оффтопик. Почитал тут отзывы про консультативную группу “про ИИ в математике”, которую упоминал вчера. В OpenAI, несомненно, сильный маркетинг (и особенно сильно направление, которое принято называть GR/PR – можно отделять от “чистого маркетинга”, можно не отделять, это просто оговорка, тут не важно). Поэтому и данная свежая история про консультативную группу по ИИ в математике – это же чисто маркетинговый ход, по лучшим учебникам, просто хрестоматийный. Странно, что не все это понимают. Смотрите сами: у OpenAI есть риск получить негативный эффект на почве отношения сообщества к тому, что OpenAI ломает складывавшиеся десятилетиями правила публикации “решения задач”. Это далеко не репутационный ущерб, ещё только риск. Но риск есть? Есть. Не проблема, сделаем всё по учебникам: заранее блокируем риск – покажем ответственное отношение к вопросу, сформируем и продвинем консультативную группу!
Теперь заметьте главное: чёткий положительный маркетинговый эффект от создания такой группы – мгновенный. Ещё сильнее он работает в положительную сторону, блокируя риски, в актуальном контексте одобрения “решения ещё сотни задач”. А что же группа будет делать для математики? А это уже вопрос будущего – очевидно, что сам принцип одобрения публикаций такая группа только подкрепляет, поэтому, пока участники группы пытаются как-то оправдать и объяснить своё участие (тоже – “хотим как лучше”), станем пользоваться немедленным положительным маркетинговым эффектом. Мудрый, грамотный ход. Но маркетинговый.
Комментировать »
В 2025 году я писал (в том числе, на “Хабр”), что “суперинтеллект” будет определяться по сообщениям газет. Если точнее, то ИИ станет “сверхразумом”, как только газеты про это напишут. Буквально:
Если только не считать, что степень сверхразумности будет определяться по сообщениям газет: может же так быть, что какую‑то новую систему просто объявят сверхразумной? Вполне.
Что ж, ждать потребовалось не долго: сегодня, в 2026 году, президент США Трамп, как пишут, постановил называть “искусственный интеллект” – “сверхинтеллектом” или “сверхразумом”: Super Intelligence, SI. Такой термин теперь рекомендовано использовать в штатовских официальных правительственных документах. Вот.
Комментировать »
Из OpenAI пишут, что решили ещё “более сотни” давних математических задач (интересно, есть ли там 11.115 из “Коуровской тетради” – ну, а вдруг?) и сформировали, ни много ни мало, а консультативную группу (advisory group) по математике и искусственному интеллекту. Группа, получается, будет определять, что и как публиковать. В общем, что называется, “история получила занимательное продолжение”. Продолжаем наблюдение.
Комментировать »
Пробное расшифрование – это хоть и вычислительно затратный, но типовой метод обнаружения подлинных попыток соединения на скрытом сервисе. При этом, если сервис правильно спроектирован, то и вычислительные затраты можно свести к весьма разумному уровню – процессоры сейчас мощные, тот же шифр AES – практически всегда на серверной стороне доступен в аппаратной реализации.
Основной принцип пробного расширования следующий: на сервер приходит внешний пакет, который может содержать данные для начального соединения от подлинного клиента – то есть, такое клиентское приветствие, позволяющее установить сетевое соединение и туннель, полностью зашифрованный. Сервер отвечает только на подлинные приветствия, а в ответ на поддельные – молчит. Здесь предполагается, что клиент и сервер уже знают общие симметричные секреты: обычно, это секретные ключи, настроенные в конфигурации и сервера, и клиента.
Содержание начального пакета данных должно быть вычислительно неотличимо от случайных данных (от шума) для внешнего наблюдателя. Это как раз и достигается тем, что данные зашифрованы. Но зашифрованы должны быть буквально все данные. То есть, тут не может быть некоторой структуры приветствия, как, например, в TLS: если пакет содержит некоторые заданные спецификацией поля (версию, идентификатор, таймстемп и пр.), то пассивный наблюдатель легко узнает протокол, к которому такой пакет относится. Поэтому видимой структуры быть не должно, но она может быть скрыта в зашифрованном блоке. (Тут еще есть транспортный аспект, типа TCP, об этом отдельно рассказано ниже.)
Но если пакет выглядит как шум, то что делать серверу? Тут как раз и начинается пробное расшифрование. Сервер пытается расшифровать полученные данные всеми известными ему клиентскими симметричными ключами. Внутри зашифрованного блока данных, – то есть, в открытом тексте, – уже содержится структура, которая и позволяет серверу понять, что расшифровано правильно – то есть, ключ найден верный. Это довольно хорошо отработанный подход, поэтому есть типовое решение: начальная часть открытого текста должна содержать достаточно длинный идентификатор клиента (например, 128 бит), этот же идентификатор сохраняется в таблице на стороне сервера, вместе с соотвествующими секретными ключами. Сервер перебирает эти ключи, расшифровывая пакет каждым.
Как только сервер, в результате расшифрования, получил идентификатор, совпавший с данными в таблице – сервер считает, что это начальное сообщение именно от того клиента, который указан в таблице. Это пока что предварительное решение, по схеме “в лоб”. С сетевой точки зрения, у данного решения есть сразу несколько больших недостатков, прежде всего – повторная отправка записанных пакетов. Мы недостатки сейчас рассмотрим и исправим. Но прежде всего важно заметить, что найден способ определить, что это за клиент стучится, приняв пакет, содержание которого выглядит для третьей стороны как поток байтов со случайными значениями.
Вероятность, что какой-то подставной пакет расшифруется так, что совпадёт и ключ, и идентификатор – настолько мала, что её можно не рассматривать. Тем более, что если так получится, то, для добротного шифра, это будет означать, что подставной клиент угадал ключ. Если же после всех вариантов расшифрования идентификатор клиента не найден, сервер отбрасывает пакет и не отвечает ничего. Да, обработка каждого входящего пакета требует выполнения многих операций расшифрования на сервере. Это неустранимая особенность: серверу придётся проверить данные по каждому клиенту. Если клиентов тысячи, то “невалидный” пакет сервер будет расшифровывать тысячи раз. Но, как отмечено выше, шифр AES нынче быстрый, а отправка наружу ответа о том, что пакет неверный – не требуется.
Теперь о других недостатках. Прежде всего, наивная схема зашифрования означает, что один и тот же клиент будет присылать одинаковый начальный пакет, потому что у клиента зафиксированы и значение ключа, и содержание пакета-приветствия. Это очень плохо, но легко исправляется, да ещё и сразу несколькими способами: например, в начало пакета в открытом виде записывается случайный вектор инициализации, который сервер использует при расшифровании (а клиент – при зашифровании). Этот вектор имеет фиксированную длину, но, поскольку значение вектора инициализации случайное, это не даёт никакой дополнительной различительной информации: к случайным данным прицепили случайные данные. Естественно, можно дописать изменяемый счётчик или слйчайный вектор внутри зашифрованных данных (см. ниже про таймстемп).
Следующий момент: если пакет имеет фиксированную длину, то при пассивном анализе можно зацепиться за эту длину. Решается тоже просто: к данным дописывается некий хвост-дополнение из случайных байтов, длина которого варьируется. Тогда у пакета образуется минимальная допустимая длина (поскольку должны войти данные приветствия), а практическая длина – изменяется от пакета к пакету. (Тут есть тонкий момент с контролем длины дополнения и дуплексным режимом для успешного соединения: дополнение нужно отбрасывать корректно, потому что иначе оно может попасть в начало следующего клиентского пакета. Но, опять же, оставим этот момент за пределами записки.)
Сервер знает длину полей в расшифрованных данных, знает, что поля идут одно за другим, может знать длину дополнения, поэтому просто отбрасывает это дополнение (где, после расшифрования, образуется некий мусор). Это всё самые простые способы, без аутентификации данных. Раз нет аутентификации, то кто-то может взять валидный пакет и дописать к нему что угодно в качестве дополнения, сделав некоторую метку. Сервер это “что угодно” вынужден будет расшифровать и если прочие данные сойдутся к валидным, то пакет будет принят в качестве приветствия. Это, на самом деле, не такая большая проблема: подобное тегирование мало что даёт, потому что для эффективного использования потребуется повторная отправка пакетов. И, опять же, есть несложное решение: используем код аутентификации сообщения, построенный на другом секретном ключе, а значение кода аутентификации дописываем в пакет. Сам код аутентификации тоже вычислительно неотличим от случайного (у нас случайный вектор инициализации), поэтому новых меток в пакете не появляется. Если аутентификация не сошлась для всех ключей, то пакет отбрасывается без дальнейшей обработки. В общем, это дополнительный затратный шаг на стороне сервера, который, в принципе, не требуется (внутри должна быть отдельная аутентификация – это другой аспект, там требуются асимметричные криптосистемы).
Только что была упомянута проблема повторной отправки валидных записанных приветствий. Третья сторона записывает трафик, выделяет валидные приветствия (это те, на которые сервер отправил ответ), а потом проигрывает эти приветствия в сторону сервера. В наивной схеме, действительно, такое сработает: сервер ответит. Однако, так как третья сторона не знает секретов, то она даже не сможет расшифровать ответ сервера. Впрочем, повторное проигрывание пакетов даёт некоторые новые направления для атак: во-первых, можно устроить зонд (connection probe), выявляющий действующие серверы – отправляем валидный пакет-приветствие на IP-адрес, если есть ответ, то там есть работающий по данному протоколу сервер; во-вторых, так как сервер вынужден на своей стороне открыть сессию, можно исчерпать доступные сессии на сервере; в-третьих, повторная отправка чужого приветствия может приводить к тому, что будет разорвано легитимное соединение того же клиента – а это уже неприятно, поскольку позволяет просто блокировать возможность использования протокола: фиксируем успешный обмен по ответу сервера – тут же отправляем ранее записанный пакет-приветствие в сторону сервера (это вообще один из хитрых моментов, который, впрочем, за пределами данной записки, посвящённой пробному расшифрованию).
Как бороться с вмешательством, котрое реализуется повторной отправкой начальных пакетов? К сожалению, эффективное противодействие – потребует некоторых дополнительных ресурсов: нужно на сервере вести таблицу состояний, – некий буфер, если точнее, – и отбрасывать все повторные пакеты по их значению (можно брать только начальные байты). А внутрь пакета-приветствия, в зашифрованную часть, нужно встроить таймстемп, и потребовать синхронного времени на клиенте и сервере. Тогда сервер ведёт запись о поступлении и успешной обработке недавних приветствий, прямые быстрые повторы – сразу отбрасывает (игнорирует), а если получено старое приветствие, то его придётся расшифровать, чтобы обнаружить, что оно устарело (по таймстемпу – тут речь о том, что допускается только расхождение на сколько-то секунд с сервером). Таким образом, проблема повторной отправки решается тоже.
Итак, в добротной реализации сервер ведёт себя тихо, с сетевой точки зрения, пока не получит валидный свежий пакет-приветствие, на который уже отвечает своим приветствием и далее может начаться сессия. Тут необходимо оговорить траспортный момент. Предположим, используется TCP. А в TCP есть собственная сессия. Соответственно, невозможно отказаться от установления TCP-сессии для того, чтобы получить начальный пакет на сервере. Это означает, что зонд может проверить доступность TCP-соединения. Конечно, само по себе TCP-соединение ещё не означает, что на сервере установлен искомый сервис, но, всё же, “наводит на мысли”. В принципе, если третья сторона анализирует трафик, то она так или иначе увидит, что к сервису кто-то подключается, поэтому само по себе TCP-зондирование ничего нового о работающем сервисе не расскажет, но вот найти подозрительный сервер-кандидат, который пока не работает, позволит. К сожалению, этот момент довольно трудно устранить. Есть способы типа port knocking (“секретный стук”), кроме того, можно ограничить доступ на уровне ядра ОС по IP-адресам источника. При этом TCP вообще позволяет несколько более эффективно ограничивать попытки повторных ложных подключений с одного IP-адреса. Но это всё полумеры.
Есть вариант с UDP. Поскольку этот протокол без сессий, то ложный зондирующий пакет будет оставлен сервером без ответа, а зонд вряд ли сможет отличить эту ситуацию от отсутствия сервиса (конечно, и тут есть свои оговорки, но от TCP – ситуация точно отличается очень существенно). UDP быстрее TCP, но могут быть проблемы с преодолением пограничных узлов, транслирующих адреса, и с тем, что в каких-то сетях UDP просто зафильтрован.
Комментировать »
Недавно я писал о том, что невнятные cybersecurity guardrails (“ограничения/препоны для кибербезопасности”) мешают LLM-системе Claude исправлять собственные же ошибки в программном коде. Поскольку эти самые guardrails начали вылезать едва ли не при каждом запросе, я переключился на теоретическую математику в своих тестах – там, как я думал, guardrails не будет. И действительно, там их нет – всё работает, что называется, “согласно описанию” – без guardrails (да, моментально съедает токены, но это другая история).
То есть, препонов кибербезопасности нет в теоретической математике “силами LLM”.
Пока что.
Дело в том, что недавно появилось очередное открытое письмо про AI/ИИ в математике, подписанное многими филдсовскими лауреатами. И вот как бы по результатам этого письма не добавили “препоны/guardrails” ещё и в упражнения LLM в области теоретической математики. Ну, чтобы ограничить угрозу. Потому что в упомянутом письме прямо признаётся определяющая для соверменной математики роль не столько ИИ/LLM, сколько корпораций, этим LLM/ИИ управляющих, и предлагается озаботиться проблемами – ну, читай, “согласовывать и ограничивать”.
Комментировать »
Обычный вариант атаки MITM для TLS подразумевает, что у перехватывающего узла (прокси) есть секретный ключ от валидного серверного сертификата (ну и сам сертификат, естественно). Тогда перехватывающий узел выдаёт себя за настоящий TLS-сервер в сторону клиента, и за клиента – в сторону настоящего TLS-сервера.
В IP-сети всякий промежуточный узел может ответить вместо настоящего, так что в сетевом смысле атака не самая трудная. Получается, что TLS-сессия установлена не между клиентом и сервером, а превратилась в две TLS-сессии: одна – от клиента до перехватывающего узла, вторая – от перехватывающего узла до настоящего сервера. Промежуточный узел принимает трафик в обе стороны и видит его в открытом виде, так как TLS-соединение между клиентом и настоящим сервером не установлено, трафик никто не защищает.
На что тут влияет клиентская аутентификация в TLS? Вот на что: штатный способ аутентификации TLS-клиента сервером, – на этапе установления соединения, – подразумевает, что клиент подписывает все TLS-сообщения, которые были переданы до настоящего момента, а это означает, что перехватывающий узел не сможет получить корректную подпись для своей сессии в сторону подлинного сервера. Чтобы это сработало, сервер должен поддерживать клиентскую аутентификацию, конечно.
То есть, буквально, TLS-клиент при помощи секретного ключа подтверждает, что получил некоторые TLS-сообщения с конкретным содержанием (там побайтово все сообщения подаются на вход хеш-функции). В случае MITM, клиент подпишет те сообщения, которыми обменивался с перехватывающим узлом, с прокси. Но состав этих сообщений отличается от сообщений, которыми перехватывающий узел обменялся с подлинным сервером (см. ниже объяснения). Подлинный сервер же – видит лишь сообщения от перехватывающего узла (и свои собственные), соответственно, проверять клиентскую подпись он будет по этим сообщениям. Подпись, присланную клиентом, перехватывающий узел передаёт без изменений. Так как сообщения различаются, подпись не сойдётся. Перехватывающему узлу не известен секретный ключ клиента, поэтому перехватывающий узел не может подписать за клиента сообщения сессии в сторону подлинного сервера. Если же сообщения прокси передавал без изменений, то это означает, что перехвата TLS не случилось, а случилось обычное TLS-соединение и прокси не сможет раскрыть трафик.
Важная оговорка: это всё верно, но лишь без учёта возможности принудительного понижения стойкости – в принципе, перехватывающий узел, активно вмешиваясь в соединение, может вынудить стороны TLS согласовать заведомо нестойкие ключи и параметры протокола. Это позволит расшифровать трафик в пассивном режиме. Однако это совсем другая схема перехвата, она гораздо сложнее, клиенты типа современного браузера лучше защищены от применения подобных атак, а в TLS давно есть дополнительные индикаторы, помогающие такую атаку обнаружить, и т.д. В общем, в записке речь идёт о максимально простой схеме перехвата – с полной подменой узла.
А что если у перехватывающего узла есть подходящий секретный ключ и дверенный клиентский сертификат? Тогда – да, перехватывающий узел сможет выдать себя за аутентифицированного клиента в сторону подлинного сервера и продолжить прозрачный перехват, просто пригнорировав аутентификационный ответ прослушиваемого клиента.
Тут есть тонкий момент: нельзя забывать, что в TLS проверить корректность подписи и валидность клиентского сертификата должен подлинный сервер. Если сервер реально использует результат аутентификации клиента, то сессия с MITM – развалится (если у перехватывающего прокси нет клиентского секретного ключа). Но это именно особенность TLS. То есть, сервер должен всё проверять, но может и не проверить. Если сервер реально не проверяет значение клиентской подписи, то перехватывающий прокси может прислать что угодно похожее на подпись и TLS-соединение продолжит работать как обычно. Ну и тем более так будет, если сервер вообще не использует клиентской аутентификации в TLS (обычное дело).
И это приводит к следующим особенностям трансляции доверия через TLS. Предположим, что есть дополнительный прикладной протокол аутентификации, работающий через TLS, но не использующий встроенную в TLS клиентскую аутентификацию. Простейший вариант: клиент вводит пароль. Понятно, что тут MITM-прокси просто пересылает запрос на пароль клиенту, а пароль от клиента – пересылает серверу. Всё прозрачно работает, прокси узанёт пароль.
Более сложный вариант: у клиента есть секретный ключ для цифровой подписи, сервер верит в открытый ключ, соответствующий этому секретному. Сервер присылает запрос на подпись некоторых данных – клиент подписывает – сервер проверяет и убеждается, что у клиента есть секретный ключ, если всё сошлось – клиент аутентифицирован. Помешает ли это MITM-прокси? Нет, не помешает. Прокси, в рамках штатного перехвата трафика, просто копирует запрос сервера, пересылает его клиенту, получает от клиента подпись, передаёт её серверу – сработало, сервер аутентифицировал клиента и незаметил вмешательство прокси. Почему это работает? Потому, что тут аутентификация не привязана к транспортной сессии: сервер проверяет, что запросы поступают от стороны, имеющей доступ к секретному ключу, парному к доверенному открытому, но не проверяет, что транспортная сессия установлена с той же самой стороной.
Что это всё означает? Вот что: представьте, что клиент авторизуется через тот или иной механизм, использующий цифровую подпись, выполняемую на стороне клиента; эта схема, с точки зрения простого MITM-перехвата TLS, не даёт дополнительной защиты сессии. То есть, всё происходит на пару уровней выше TLS: клиент что-то подписал, сервер выдал клиенту авторизационный токен, этот токен виден на стороне MITM-прокси, теперь сторона с прокси может выдать себя за аутентифицированного клиента, подпись не требуется. Если подпись потребуется, то прокси перенаправит запрос клиенту. Да, по сравнению с паролем, тут есть некоторое преимущество: секретный ключ подписи не утекает наружу. Но, с другой стороны, выгода в плане защиты информации не так уж велика: ведь MITM-прокси может попросить клиента подписать что угодно, прикинувшись подлинным TLS-сервером при помощи перехватывающего TLS-сертификата.
Комментировать »
Воскресное чтение манускриптов. Сегодня продолжаем читать “Арифметику” Диофанта.
“Арифметика” на манускриптах уже связана с целой серией записок, в которой нам встречались: “маргинальный” комментарий к первой задаче; разбор текста первой задачи на манускрипте Vat.gr.191 в двух частях; принципы обозначения неизвестной у Диофанта и правило “минус на минус”; а также необычные “кубо-кубосы”, используемые для обозначения степеней неизвестной в “Арифметике”.
В этот раз – читаем вторую задачу, в версии всё того же Vat.gr.191 – манускрипта 13 в. из Ватиканской Апостольской библиотеки. Вторая задача, как легко догадаться, идёт сразу после первой.
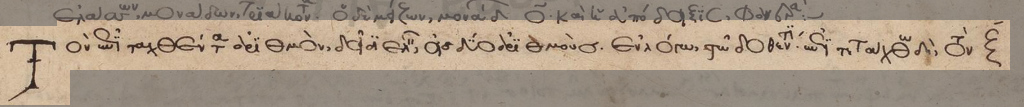
Это первое предложение второй задачи. В современной типографике: τὸν ἐπιταχθέντα ἀριθμὸν δεῖ διελεῖν εἰς δύο ἀριθμοὺς ἐν λόγῳ τῷ δοθέντι. Здесь задача формулируется: “заданное число нужно разбить на два числа, [находящихся] в соотношении данном”. Как и в первой задаче, тут под “разбить” понимается “представить в виде суммы”. То есть, это A == X + 3X. Можно сказать, что задача для начальной школы. Так, судя по всему, и было во времена Диофанта, да и, собственно, за четыре тысячи лет до него тоже. Почему всё ещё иногда приходится слышать, что, якобы, изучаемые в начальной школе сейчас, – в 21 веке н.э., – арифметические задачи представляли какой-то “недостижимый уровень” пару тысяч лет назад – загадка. Но, вообще-то, далеко не все задачи в “Арифметике” настолько простые. Возможно, в чтении “Арифметики” мы доберёмся и до сложных тоже.
Оставшаяся часть выделенной строки это начало предложения, переходящего на следующий лист (361r). А именно: ἐπιτετάχθω δὲ τὸν ξ̅ … – и продолжение на следующем скриншоте.
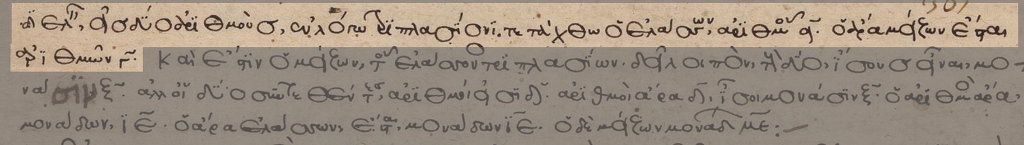
Продолжение: …διελεῖν εἰς δύο ἀριθμοὺς ἐν λόγῳ τριπλασίονι. Перевод будет ниже. Здесь есть интересный письменный момент – лигатура.
Обратите внимание на “закорючку”, с торчащим вверх хвостом, примерно в конце первой трети первой строки. Это не просто закорючка, а скорописная лигатура τρ в слове τριπλασίονι. Занятно, что в других случаях на этом же манускрипте τρι- в τριπλασίονι записано обычным способом (см. ниже).
Перевод: “[пусть] задано 60 разбить на два значения (“арифмоса”) в отношении тройном (τριπλασίονι)”. Число 60 в греческих обозначениях это ξ̅ . “Арифмосы” это диофантово обозначение для переменной величины. В этом манускрипте пока что “арифмосы” записаны полным словом. В современных текстах Диофанта (но на древнегреческом, конечно), вместо “арифмосов” будет обозначение, напоминающее букву S.
Читаем выделенную строку дальше: τετάχθω ὁ ἐλασσων ἀριθμος α̅. Перевод: “назначим меньшему значение 1 (α)”. То есть, у нас должно быть две кратности одной переменной, раз одна кратность составляет три других, то меньшее будет с единичной кратностью.
Есть большее и меньшее, но с учётом множителей при переменной. Здесь, буквально, имеется в виду вот что: запишем 1*X и 3*X, где 1*X – меньшее, а 3*X – большее. И X, как переменная, это “арифмос”. Про 3 * X написано дальше: ὀ ἄρα μείξων ἔσται ἀριθμῶν γ̅ . Перевод: “а большее будет (со) значением три”. γ̅- это три: α,β,γ,…
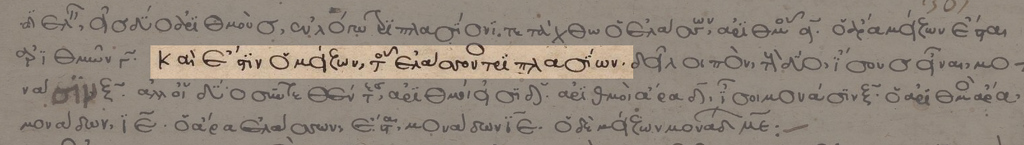
Читаем, разбирая закорючки и сокращения скорописи: καὶ ἔστιν ὀ μείξων τοῦ ἐλάσσονος τριπλασίων. Здесь, помимо τοῦ, есть знак, похожий на большую надстрочную O. Это скорописное сокращение для -ος на конце слова. Кроме того, в ἐλασσονος ещё и двойная сигма записана лигатурой. Буквальный перевод: “и большее есть меньшее утроенное”. То есть, 3X == X+X+X. Обратите внимание, что тут τρι- в τριπλασίων записано обычным образом, не так как выше, с лигатурой. Почему? Это отдельная тема.
Читаем дальше.
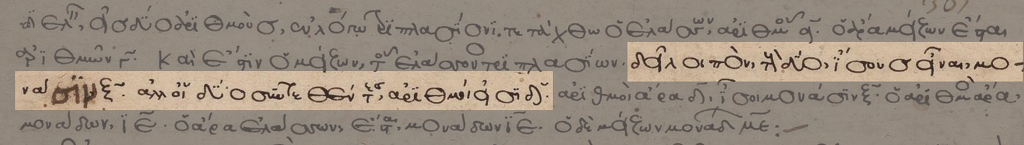
Текст: δεῖ λοιπὸν τοὺς δύο ἴσους εἶναι μονά(σιν) ξ̅ ἀλλ’ οἶ δύο συντεθέντες ἀριθμοί εἰσι δ̅. Перевод дословный: “так в результате два [значения] равны будут 60 единицам (μονάσιν), но два соединённых значение имеют 4″. Или: “сумма равна 60, а оба коэффициента при переменной дают 4”. Тут важно не перепутать “монады” с “арифмосами”. “Монады” – это единицы. 60 “монад” – это итоговое натуральное число шестьдесят. “Арифмосы” – это переменные и коэффициенты при переменных, и тот факт, что обе части переменных вместе (то есть, “соединённые, согласованные”) имеют значение в четыре (“арифмоса”), обозначает, что 3X + X = 4X. Это 4X и есть “четыре арифмоса”, то есть, буквально X+X+X+X.
Это всё часто кажется элементарщиной, но если речь про книгу “Арифметика”, то необходимо точно определить базовые понятия с самых первых страниц. Это не так-то просто сделать. Например, умножение можно определить как повторное сложение. И сейчас многие “продвинутые пользователи” думают, что, мол, автоматически “всё со всем коммутирует” (о том, что это не так – догадываются разве что алгебраисты). Отсюда происходят занимательные неверные толкования задач современной начальной школы – тут я традиционно ссылаюсь на записку про некоммутативные апельсины.
Вернёмся с манускрипту. Теперь читателю “Арифметики” должно быть понятно, что 4X – это 60. О чём и написано дальше.
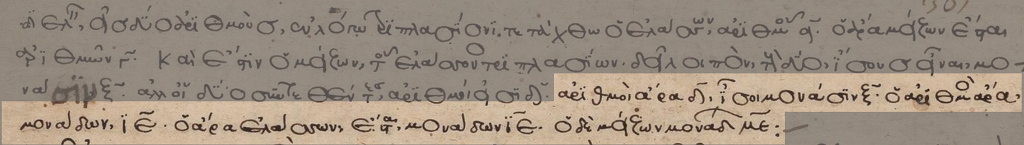
Заключительный фрагмент решения задачи: ἀριθμοὶ ἄρα δ̅ ἶσοι μονάσιν ξ̅. ὁ ἀριθμὸς ἄρα μονάδων ι̅ε̅, ὁ ἄρα ἐλάσσυων ἔσται μονάδων ι̅ε̅, ὁ δὲ μείζων μονάδων μ̅ε̅. Дословный перевод: “значений же четыре равно единицам 60, и (одно) значение составляет 15, значит, меньшее есть единиц 15, а большее же – единиц 45”. На русском языке: “переменная с коэффициентом 4 равна 60, значит она составляет 15, поэтому меньшее число есть 15, а большее – 45”. То есть, нашли ответ: X == 15; 3X == 45; 3X + X == 45 + 15 == 60. Те самые шестьдесят “монад”, которые образовались из 15 (ι̅ε̅) “монад” и 45 (μ̅ε̅) “монад”. То есть, тут, – прямо в самом начале предложения, – четыре (δ̅) “арифмоса” равны шестидесяти (ξ̅) “монадам”. “Арифмосы” – это ящики или коробки, в которые укладываются “монады”, в разном количестве. Здесь их пятнадцать. Именно так арифметику строят и сейчас, с той лишь небольшой разницей, что “монадой” нынче принято называть один пустой “арифмос”.
Комментировать »
Наступил сентябрь 2026 года. Небольшое обновление статуса по доменам. Часть имён .ru, .su, в том числе, dxdt.ru, я перенес к другому регистратору и, – так как меня убедили, что жаль просто бросить старые имена, – передал другому администратору. Тем более, что там оказались не только имена, ценные в исторической перспективе, но и достаточно важная электронная почта.
Другую часть .ru, .su (там пара-тройка имён всего) – я не переносил, и не намерен продлевать, поэтому, вероятно, они все будут удалены (не страшно). Пишу “вероятно” потому, что уверенности нет: правила резко поменялись и в них очень много “неожиданных поворотов”, это кроме ЕСИА (однако, не хочу эти моменты обсуждать – всё это слишком печально).
Удивительно, но перенести домены между регистраторами и сменить администратора удалось буквально в последние дни августа, благодаря наличию в реестре схемы передачи с кодом подтверждения. Перенос и смена администратора проходили не без шероховатостей, но завершилось всё, вроде, успешно. К счастью, “Мастерхост”, как принимающий регистратор, не только сохранил техподдержку, но ещё и сработал, в итоге, правильно (спасибо!). Я надеюсь, что на dxdt.ru пока что сохранится HTTP-редирект, ведущий на dxdt.blog, а dxdt.blog у меня не отберут (тут я изучаю вопрос смены регистратора для .blog тоже). Но это планы. В общем, посмотрим.
Comments Off on Про (мои) домены .RU/.SU
Очередной пример “аутентификационного” помешательства, на этот раз – GitHub: там, оказывается, довольно давно ввели “двухфакторную аутентификацию”, да так, что нельзя даже попасть в свой аккаунт. Совсем. То есть, мне, фактически, аккаунт заблокировали там опять, потому что для того, чтобы даже попасть в собственный профиль, требуется выполнить дополнительные действия по включению “2FA”. Ещё как-то можно понять, если такой метод дополнительной проверки вводился бы для каких-то действий с репозиториями. Но чтобы закрывать вход совсем, то есть, даже нельзя удалить данные из аккаунта – это уже перебор, конечно. (Нет, я могу настроить двухфакторную или “многофакторную” аутентификацию. Вопрос в другом – зачем это повсеместно доводится до абсурда? Но, конечно, это риторический вопрос.)
Комментарии (5) »
Могут ли в программных системах проверки математических, формализованных доказательств быть ошибки? Конечно. Они там даже есть. И эти ошибки могут проявляться в том, что какие-то неверные цепочки “доказательств”, будут отмечены как верные.
Вероятность ошибки тем выше, чем больше формальных конструкций в доказательстве. Если код доказательства генерирует LLM, а в коде миллионы строк, то вероятность “эксплуатации ошибки” – выше. Почему “эксплуатации”? Потому что никто не сказал, что мощная LLM-система, использующая тот тамый программный парсер для проверки своих сегенерированных “формализаций”, не подберёт ошибку специально так, чтобы формальное доказательство сошлось к нужному результату. Вполне может и подобрать.
Должна ли такая ошибка в парсере вообще воспроизводиться системно? Не должна, но может. То есть, естественно, если у вас дефектный программный “парсер теорем”, но проявление дефекта в нём зависит, скажем, от схемы исчерпания свободного ОЗУ того компьютера, на котором запущен парсер, то выводы системы проверки будут плавающими и это все сразу заметят. Ну как – “все”: не то чтобы прямо “все”, но те, у кого есть вычислительные ресурсы для запуска проверки миллионов строк на гигабайтах ОЗУ. Но это другое дело. Главное, что дефект может быть системным, а это означает, что он строго воспроизводится, раз за разом выдавая одинаковый, но неверный вывод. Как проверить миллионы строк формализации вручную? Никак.
Понятно, что можно взять и написать другой парсер, который либо подтвердит вывод, либо обнаружит ошибку. На вход нового парсера подаётся тот же самый поток доказательств. В конце концов, формализация – это лишь набор текстовых файлов, можно попробовать проверить на компьютере, но разным проверяющим кодом. Такая схема тоже используется, пусть и с ограничениями. Для Lean, например, есть Nanoda. Код парсера даже может быть обозримым. Но только тут необходимо учитывать компилятор. А чтобы доказать, что компилятор выводит тот машинный код, который ожидается, опять нужна формальная проверка на компьютере, в том или ином виде. Читай: нужен тот же парсер с формализацией.
Получается не просто “диагонализация”, а вообще-то некоторый замкнутый круг.
Комментировать »
 Новый
