Ресурсы: техническое описание TLS, LaTeX - в картинки (img), криптографическая библиотека Arduino, шифр "Кузнечик" на ассемблере AMD64/AVX и ARM64
У меня на сайте используется открытый ключ, который начинается с 0xDEADC0DE. Но вообще-то TLS-сертификат может служить и носителем целого текстового сообщения-декларации. Получается что-то вроде документа, который протестует против инфраструктуры УЦ, сложившейся в вебе. Создание такого сертификата описано на сайте Maurycyz.com. Текст сообщения виден в Base64, то есть, чтобы его прочитать – нужно вывести серверный сертификат в PEM (PEM представляет собой Base64-запись DER-представления, помещённую между текстовыми строками вида “BEGIN/END”). Выглядит это так:
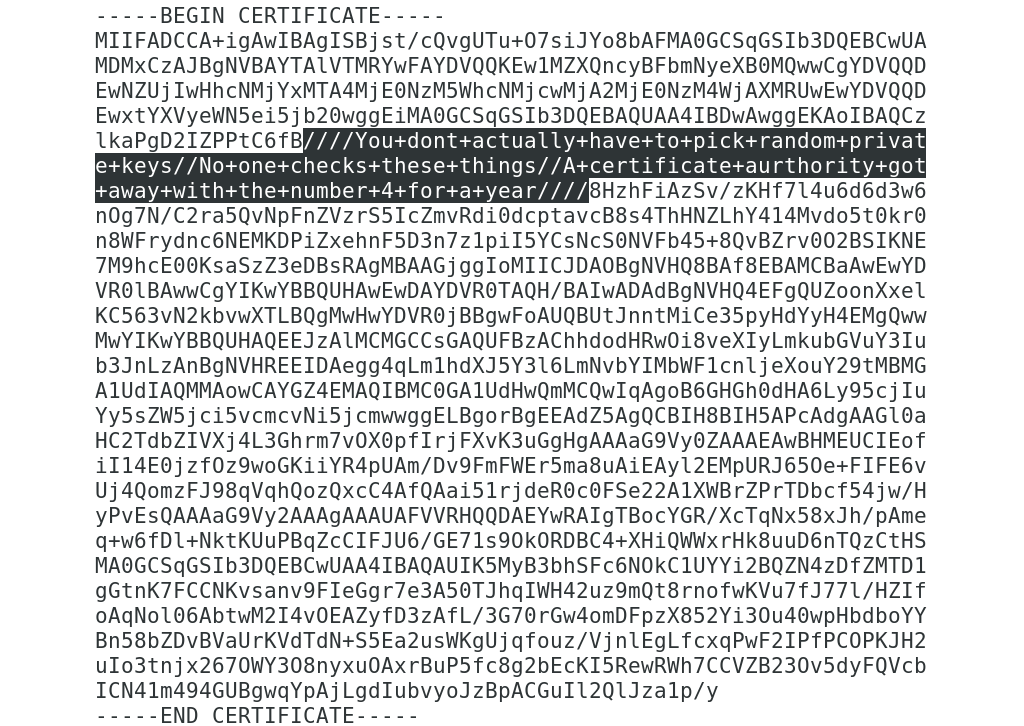
Работает это вот почему: опубликованная строка текста является корректным Base64-кодом; сертификат использует RSA, значение модуля ключа RSA можно подобрать под нужный код Base64 обратным преобразованием, вычислив подходящий простой делитель, это вычислительно быстро, так как исходная факторизация известна (детали есть по ссылке выше).
Комментировать »
Геолокация точки записи звуковой дорожки на основе “допплерограмм” звука пролёта самолётов (Youtube, англ.). В видео по ссылке рассказано о том, как можно точн определить географические координаты точки записи целевого ролика лишь при помощи анализа звуковых отметок, связанных с пролетавшими самолётами.
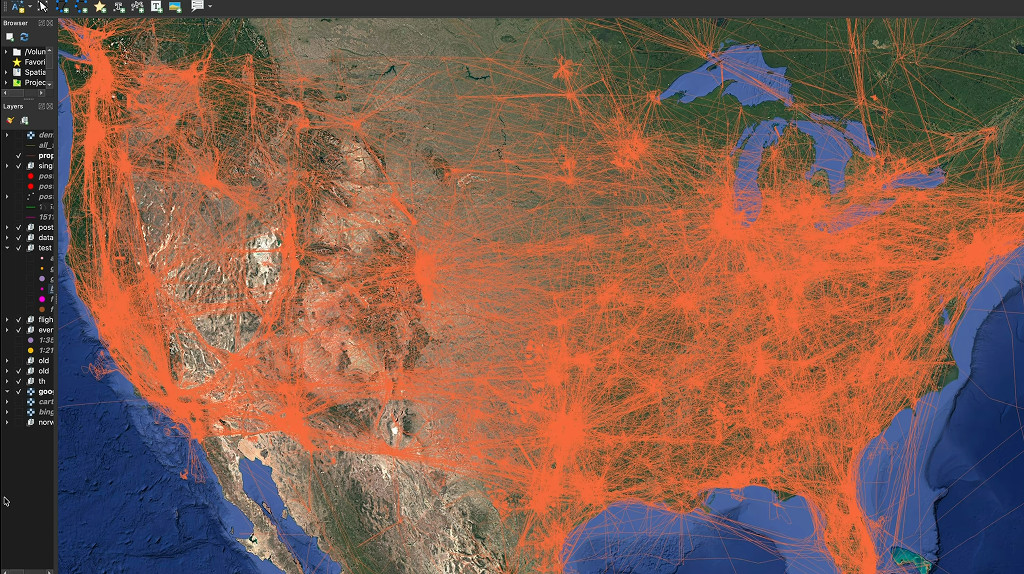
Речь про всю территорию США и заданную дату – то есть, заранее известно только то, что анализируемый видеоролик записан где-то на территории США в заданное время. Визуальных ориентиров в целевом ролике нет. Фокус в том, что траектории, по которым летят самолёты, вводят некоторое достаточно плотное координатное поле, потому что можно выбрать точки на земной поверхности, в которых звук самолёта обладает заданными характеристиками, при этом данные по траекториям – записываются на основании сигналов передатчика ADS-B, их можно скачать из доступных БД (Flightradar и др.). Понятно, что требуется обработка большого объёма данных, но вычислительные мощности сейчас доступны.
Чтобы выбрать подходящие трактории, используется допплеровский сдвиг и временная задержка, которые позволяют определить скорость и расстояние до самолёта в заданный момент времени. Ключевой ход – это учёт моментов времени, когда самолётов на записи не слышно, и использование в качестве опорного фильтра расстояния по времени между двумя акустическими следами в аудио: каждый след соответствует разному самолёту, а интервал между этим следами позволяет отбросить множество комбинаций траекторий, соответствующих разным точкам на земле. То есть, цепочки событий очень сильно помогают и тут.
Комментировать »
Не всегда дальность, доступная для успешного сеанса радиосвязи в рамках некоторого (цифрового) протокола, зависит от мощности сигнала и характеристик уровня шума на входе приёмника. Максимальную дальность может ограничивать схема таймингов протокола. Это, с одной стороны, момент очевидный, но, с другой стороны, отчего-то постоянно про него забывают.
Предположим, что обмен данными организован в виде кадров. Одна из сторон передаёт кадр (и внутри него – пакет) с запросом, а потом переключается на приём, ожидая начальный символ, задающий кадр для ответа. И вот пусть это время ожидания – 10 микросекунд (μs), с момента завершения передачи. Если через 10 микросекунд начало кадра не получено, то узел считает, что ответа нет. Это, например, очень похоже на “классический” Bluetooth, если хотите ближе к практике.
Что означает такая схема? Она означает, что сигнал должен “сбегать” в обе стороны за 10 микросекунд, без учёта обработки. То есть, мгновенный ответ на второй стороне означает, что доступное плечо – 5 микросекунд. Или, если посчитать в метры, проходимые электромагнитным импульсом, то около 1500 метров. Дальше, как бы не увеличивалась мощность сигнала, чувствительность приёмного тракта, – работать не будет: потому что мощность тут никак не позволяет уменьшить время задержки, и если ответ пришёл с задержкой больше 10 микросекунд, то приёмник его уже не прочитает.
Подобный тайминг ограничивает любые протоколы, не обязательно “цифровые”, но в цифровых – эффект сильнее. Понятно, что данное ограничение не влияет на пассивную сторону: прослушивать обмен сигналами можно с горазо большей дистанции, чем задумано в протоколе, особенно, если мощность передатчика велика. Но вот провести активный сеанс, что-то подменить на уровне логики выше радиоканала, да с большого расстояния, не получится без сложных ухищрений.
К ухищрениям здесь относится, например, превентивная отправка ответа до того, как был получен запрос. Иногда характеристики ответа можно предсказать, поэтому приёмник на другой стороне окажется обманут – примет “старый” сигнал за “новый” ответ. Сюда же попадает “ответ на следующий запрос”: понятно, что если узел, который, после ожидания в 10 микросекунд, не получил штатный ответ, снова отправляет запрос, а потом ждёт 10 микросекунд, то это узел может принять долгий ответ за “быстрый”. Конечно, в протоколе может быть предусмотрена “непредсказуемость” состава ответных пакетов, так что сработает это далеко не всегда.
Комментировать »
Немного элементарных математических подробностей о “коротких ключах” УЦ eMudhra. Секретный ключ в ECDSA – это натуральное число в некотором заранее известном интервале, от 2 до N. Арифметика там довольно простая. Обозначим ключ d. Этот ключ d на техническом языке называют “секретным скаляром”, но, вообще говоря, от этого он не перестаёт быть натуральным числом (натуральные числа, если кто вдруг забыл, это “обычный” счёт: 1, 2, 3, 4, 5 и так “до самого большого числа”).
Открытый ключ в ECDSA получается из секретного умножением точки-генератора G на секретный скаляр; на техническом языке: [d]G. Точка-генератор – это точка, принадлежащая эллиптической кривой, используемой в данном наборе параметров криптосистемы. Умножение здесь вводится как повторное сложение: [2]G = G + G. Задача вычисления d по известной точке [d]G в произвольной группе точек кривой считается вычислительно сложной.
Минимальное значение 2 – оно очевидно из соображений умножения; понятно, 2 – это угадываемое число (см. важные детали ниже). Максимальное значение N – про него обычно пишут, что это “порядок группы точек”. Это, опять же, технический термин, который обозначает количество точек, потенциально доступных при операциях данной криптосистемы. Математически, эта самая группа точек так устроена, что всё её элементы образуются сложением генератора G с самим собой (сложение здесь – обозначение групповой операции; на техническом языке такая группа называется “циклической”). Это всё может показаться сложным, из-за терминов, но на практике это просто закольцованная цепочка значений (точек): складываете один элемент с самим собой – идёте последовательно по другим элементам, которые получаются в результате; на определённом шаге – процесс зацикливается, попадаете “в начало”, в нейтральный элемент (следом за которым будет опять генератор G, потому что G = G + 0). На практике нельзя брать именно порядок группы M в качестве максимального значения, берут, например, M-2, но это технические детали.
Точек кривой в практических криптосистемах ECDSA очень много. Их количество близко к разрядности записи, то есть, например, около 2^256. Очень много. Это определяющий момент: если бы точек было мало, то их можно было бы перебрать за обозримое время все, определив секретный скаляр. Да, практически так же, как в рассматриваемом случае нестойких ключей, но только универсальным образом.
Опять же, в упомянутом случае – набор точек называется P-384 (обычно говорят, что это “кривая P-384”), базовая разрядность – 384 бита. Точка кривой – это тоже два натуральных числа, из определённого интервала, связанных определённой формулой в пару координат. Точка-генератор G – всем известна, это открытый параметр криптосистемы. Обычно, хотя бы одна из координат G – это “большое” натуральное число. Но данные аспекты не относятся к обсуждаемой теме прямо. (Кстати, “большое” тут в кавычках, потому что с порядком в группе точек кривой всё не так просто, как хотелось бы.)
Соответственно, умножаем известную точку G на подбираемое значение d (это быстрая операция), получаем точку Q, представленную парой координат (натуральных чисел), сравниваем получившиеся координаты с атакуемым открытым ключом, если совпало – мы нашли секретный ключ, он равен d.
Итак, значение секретного ключа d, натуральное число, которое на практике должно лежать в некотором большом интервале. Казалось бы, идеально – равновероятное распределение по всем возможным значениям. Но тогда и угадываемое число 254 (например) оказывается столь же вероятным, как и все прочие, не так ли? Почему же подобные малые числа должны отбрасываться? Потому, что есть внешние допущения, связанные с битовым представлением. “Слишком много нулей” – это одна из сигнатур, связанных с дефектами в реализации алгоритмов. Такие сигнатуры накладываются на доступный интервал и оказывается, что атакующий может угадать 254 именно потому, что он будет перебирать варианты, в которых “слишком много нулей”. Если бы запись скаляра 254 не обладала отличительными чертами (все старшие биты – нуль), то и угадать его было бы не так легко. Представьте, что скаляры d “перетасовали” секретным идеальным способом и 254 перешло в какое-то произвольное значение – как теперь его найти? Только полным перебором.
Но если при выборе секретного ключа d заведомо берутся значения больше 255 (например), то что это означает? Ничего нового: теперь нужно перебирать 256, 257, 258 и т.д. То есть, тут важен не сам аспект, что “все старшие байты нулевые”, а наличие дополнительной информации о структуре распределения секретных ключей. Естественно, есть хорошо известные варианты, к которым и относится этот случай с последовательными нулевыми байтами. Это тривиальные ключи, подпадающие под универсальные ошибочные схемы. И эти случаи можно проверять без какой-то дополнительной информации. Но если, предположим, известно, что секретные ключи на сервере – это значение SHA-256 от текущего таймстемпа и IPv4-адреса сервера, то пространство перебора тоже не очень велико.
Комментировать »
Как известно, буква S в аббревиатуре IoT означает Security (безопасность). Свежая публикация от Anthropic (компания из области AI/LLM, Claude) рассказывает о том, что “ИИ/LLM” смогут “самореплицироваться” и распространяться по IoT-системам. То есть, рассказывают, что вот теперь LLM будут свои наборы коэффициентов загружать на устройства типа “умных” пылесосов. Буквально, основная идея большой публикации по ссылке выше (с картинками!) в том, что, мол, LLM-агент взломает управляющую систему пылесоса, – или, может, даже холодильника, – перенесёт туда гигабайты своих коэффициентов, и запустит “инференс” на этом вновь захваченном устройстве, чтобы взламывать следующее. И это вызывает воспоминания о полиморфных вирусах для ПК под MS-DOS, появившихся в начале 90-х годов прошлого века, более тридцати лет назад.
Полиморфные вирусы “запаковывали” и зашифровывали основную свою программу, а распаковщик – генерировали разный, по шаблону, обычно. То есть, на новой системе у запакованного вируса не было статических сигнатур, за которые могла бы зацепиться антивирусная программа, осуществлявшая поиск. Ещё раз: после того, как вирус выбирал путь распространения на новую систему (через исполняемый файл-носитель, обычно), этот вирус генерировал собственный распаковщик, прикреплял к нему зашифрованное тело вируса, и записывал этот код на носитель, для распространения дальше. На новой системе вирус распаковывался, исследовал окружение, закреплялся в системе разными способами (их было где-то с десяток, некоторые – довольно изящные), и начинал собственное распространение.
“Полиморфность” – только одна из особенностей. Продвинутые компьютерные вирусы уже тридцать лет назад имели довольно сложную встроенную логику, позволявшую обнаруживать другие вирусы и блокировать конкурентов, обнаруживать и отключать/блокировать антивирусы, выбирать способ закрепления в системе согласно имеющейся конфигурации и т.д., и т.п. Были вирусы, которые могли переходить между разными типами систем. И никаких многогигабайтных LLM для этого не требовалось. Требовалось хорошее знание ассемблера и аппаратуры от разработчика (что и сейчас не помешает).
Естественно, в новости про саморасползающиеся через захват пылесосов LLM указано важное отличие: якобы, такой LLM-агент сможет атаковывать и заражать аппаратные архитектуры, с которыми раньше не сталкивался (но в качестве примера приводят Android почему-то). Не ясно, только, откуда же такой агент возьмёт описание этой новой аппаратной архитектуры и как сможет определить, что за архитектура в очередном пылесосе используется. Мог ли древний компьютерный вирус, разработанный под MS-DOS на x86 заразить SPARCstation под SunOS? Почему нет? Тут даже не нужен полноценный кросс-ассемблер – достаточно одного из аспектов реализации “полиморфности”: этот аспект сможет переводить машинный код с одной платформы на другую. Такие решения даже существовали, но, понятно, массовыми они быть не могли по другим причинам.
Комментировать »
Кстати, что касается выгруженной OpenAI огромной пачки (больше 700 статей!) сгенерированных ИИ/LLM “решений важных математических задач”, которую уже называют “математическим” “помойкалипсисом” (Slopocalypse). В. И. Арнольд в статье “Что такое математика”, – которая выходила в виде книги, например, в 2002 году, – в подразделе, который называется “Математическое мракобесие против Абеля и Пуанкаре”, пересказывает определение математики “по Ю. И. Манину” (и Арнольд, и Манин – среди крупнейших математиков 20-го века). Пара цитат из статьи Арнольда:
“Математика, согласно Манину, – это отрасль лингвистики или филологии, занимающаяся преобразованием конечных цепочек символов некоторого конечного алфавита в другие такие цепочки при помощи конечного числа “грамматических” правил. Отличие от естественных языков, вроде китайского, английского или русского, состоит лишь в том, что в грамматике этого специального языка есть отсутствующие в живых языках правила (например, набор символов “1+2” можно заменить на символ “3”).”
“[…]ведь если в результате игры с символами и получается что-либо полезное, то это просто означает, что оно содержалось уже в исходных предпосылках”.
Дальше там речь про искусство “претендовать на открытия, которых не совершал” и т.д. Понятно, в этом есть существенная доля специального юмора и сарказма. И, понятно, в той статье и речи не идёт про ИИ-генерирование. Но всё же – удивительно, как хорошо подходит к текущей ситуации, заведённой OpenAI. Многие надеялись использовать новый мощный инструмент для того, чтобы с его помощью выпускать пачки собственных статей. Но сейчас всё выглядит так, что беспилотный бульдозер OpenAI запустили в самостоятельное приключение, и вот он уже едет сносить домики в университетских кампусах.
Комментировать »
На фото ниже – антикварная шведская шкатулка, явно предполагавшая использование двух замков.
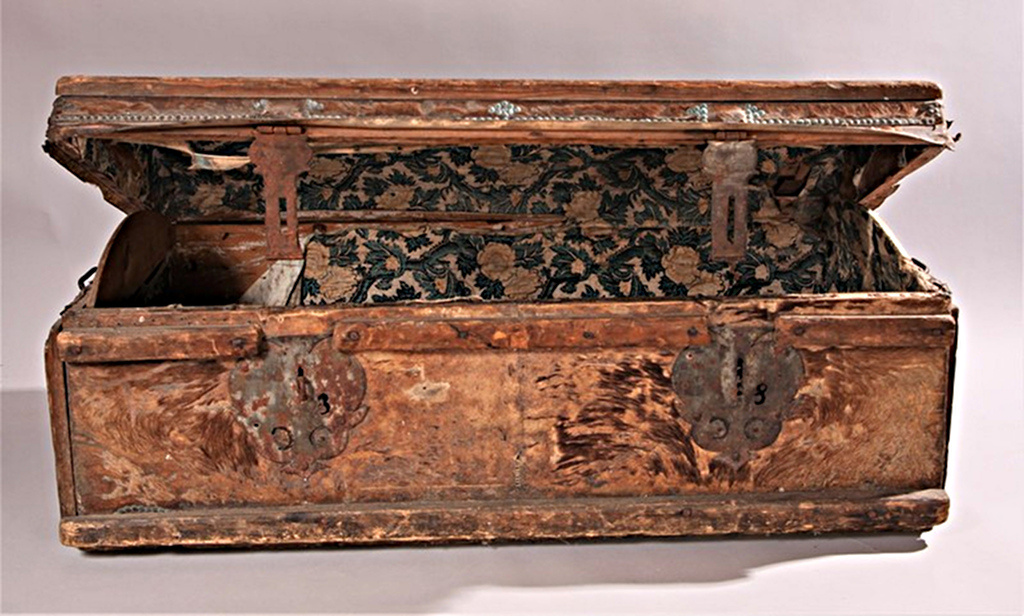
(Tomas Näslund/Vindelns hembygdsförening, источник; датировка не ясна, но, судя по всему, позже 18 века.)
Эта шкатулка явно не древняя, хоть и старинная, однако прочные сундуки и секретные коробки с двумя замками использовались ещё в древнем Риме. Сценарии использования могли быть разными.
Здесь эта фотография послужит иллюстрацией к схеме “протокриптографии”, которую я иногда привожу как пример древнего способа обмена секретными сведениями по открытому каналу без предварительного распределения ключей. И ключи здесь – это именно физические ключи. Сама схема, в принципе, известная. Но хорошо иллюстрирует особенности именнно инженерно-технической защиты информации в древности. То есть, сейчас принято считать контринтуитивной саму идею о том, что можно передать некие сведения между двумя сторонами, которые не имеют общего ключа, по открытому каналу так, что третья сторона не сможет простым способом получить доступ. Идея, может, и контринтуитивная, но, вообще говоря, подобную схему можно придумать, если посмотреть на шкатулки с двумя навесными замками.
Итак, сама схема. Есть две стороны, A и B. Сторона A хочет отправить стороне B секретную записку с недоверенным курьером. Общего механического ключа, – чтобы на стороне A запереть шкатулку, а отпереть на стороне B другой копией ключа, – нет. Как поступить?
Вот как: сторона A пишет записку и кладёт её в шкатулку, подобную той, что на фотографии, то есть с двумя местами для навесных замков. Закрыв шкатулку, A навешивает свой замок и оставляет у себя ключ. Запертая шкатулка отправляется “по открытому каналу” – то есть, с курьером стороне B. Сторона B шкатулку открыть не может – нет ключа, – но навешивает свой замок, от которого ключ есть, и отправляет шкатулку с двумя замками обратно. Сторона A, получив шкатулку, снимает свой замок, и снова отправляет запертую шкатулку стороне B. Теперь сторона B может снять свой замок и открыть шкатулку. Получилась схема обмена секретной запиской по открытому каналу без предварительного распределения ключей.
Что тут было бы предварительным распределением ключей? Да самое простое решение: сторона А и сторона B могли бы просто иметь копию ключа к одному замку, которым запирается шкатулка. Это простейший вариант. Если нужна схема посложнее, с разными ключами, то можно взять шкатулку со специальным замком: такой замок позволяет открыть шкатулку любым ключом из двух разных (этого несложно добиться: например, засов внутреннего замка на два ключа имеет два направления для открывания, каждое направление запирается “личинкой” под свой ключ). Понятно, что эти схемы сильно отличаются от исходной: один замок – два ключа. Ключ как-то нужно отправить второй стороне, если нет доверенного канала передачи ключа, то схема теряет секретность: ключ могут скопировать “на транзите”, и потом незаметно открыть шкатулку.
Какие есть особенности у схемы с двумя замками? Первая, самая главная: ключи не покидают пределы доверенного периметра. За периметр уходит только запертая шкатулка. Вторая особенность: заперев внутри шкатулки записку, сторона А уже не может поменять содержание записки, если шкатулка попала к стороне B. Третья особенность: сторона B – получит ту же самую записку, которая размещена в шкатулке изначально, но с двойным подтверждением, так как сторона-отправитель (сторона A) и поставила замок, и сняла его (подтверив, что есть ключ). Например, все эти особенности используются в статье “Покер в уме” (“Ментальный покер”, Shamir, Rivest, Adleman, MIT-LCS-TM-125, 1979), где и описана исходная схема (авторы указывают, что её предложил М. Рабин), но со многими шкатулками и для игральных карт.
К сожалению, схема работает только в том случае, если стороны обмена шкатулкой аутентифицированы! Описанная схема с двумя замками и шкатулкой подвержена классической атаке типа “человек посередине”. И в этом её основная техническая проблема. Но этот же момент сильно повышает дидактическую ценность схемы. До сих пор, говоря о том, что между сторонами существует открытый канал, мы подразумевали, что атакующий, просматривающий данный канал, пассивный – то есть, доставка шкатулки гарантируется: курьер не сможет удержаться от того, чтобы заглянуть в незапертую шкатулку и прочитать записку, но не станет менять процесс доставки. Активный же атакующий просто перехватывает шкатулку, навешивает свой замок, отправляет шкатулку обратно, получает снятый замок стороны A, открывает свой замок, читает записку, навешивает свой замок обратно и отправляет шкатулку стороне B, получателю. Естественно, с той лишь целью, чтобы потом выступить в роли стороны A, сняв по запросу свой замок.
Это, вообще говоря, неустранимая особенность подобных схем. Как ни странно, проявляется и в современной криптографии: например, такой же атаке подвержена схема Диффи-Хеллмана.
Каждая из сторон должна как-то убедиться, что обменивается шкатулкой именно с тем, с кем планировалось. Добиться этого при помощи лишь ключей и замков на шкатулке – не получится. Да, стороны могли бы знать и узнавать замки друг друга, но для этого стороны должны замки увидеть раньше. То есть, для первого обмена – не сработает. Зато сработает для повторных обменов: именно так, как сейчас действует механизм запоминания отпечатка ключа при первом контакте. Естественно, вариант со шкатулкой и двумя замками совсем теряет смысл, если использовать его повторно: если предполагается повторный обмен, то в первой итерации шкатулка должна содержать общий “секретный ключ”, который потом будет использован для другой шкатулки, с одним замком. Это сильно уменьшит трафик шкатулок (ср., например, с TLS и симметричными шифрами сейчас).
Естественно, помимо отметок на шкатулке и на самих замках, которые привязывают замок к шкатулке, стороны, обменивающиеся шкатулкой, могут приложить к ней письмо, в открытом виде, где подтвердят, что это именно они направляют шкатулку с конкретным замком. “Конкретность” замка тут, понятно, имеет исключительное, определяющее значение – иначе атакующий может просто подставить свой замок, сохранив сопроводительное письмо. Как узнать, что письмо подлинное? Например, по почерку. А почерк, предположим, может узнать человек, знакомый с каждым из участников. Получается система с доверенной третьей стороной (ср. например, с TLS-сертификатами и иерархией удостоверяющих центров).
В истории математической криптографии аналогичная схема известна как “трёхэтапный протокол Шамира”, который работает полностью аналогично шкатулке с замками, но шаг со снятием исходного замка возможен благодаря коммутативности используемой криптосистемы (см. Mental Poker по ссылке выше). В общем, очень полезная иллюстрация.
Комментировать »
Traffic Control. Имеется в виду трафик на дорогах. Механическая интерактивная детская игра. 1959 год. За 24 года до Интернета. Сделано из жести, с жестяными же автомобильчиками и автобусом, всё качественно раскрашено. (Не моё, ссылка на исходное видео с обзором – ниже.)
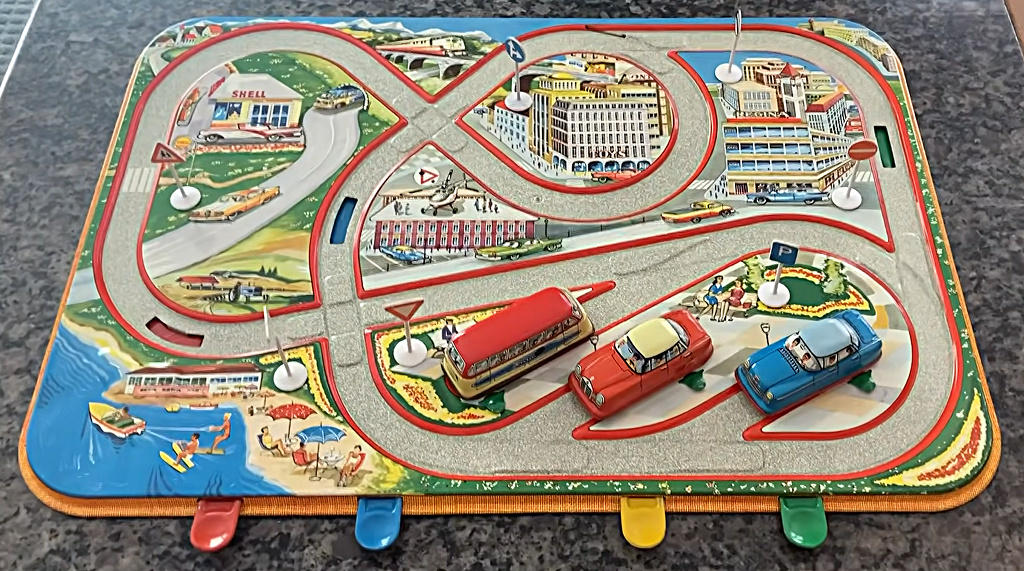
(Скриншот из видео, joe martella, Youtube.)
Автобус и автомобили – заводные, запускаются с парковки и едут по дорогам. Движением транспортных средств нужно управлять при помощи цветных кнопок (или клавиш), которые видны снизу. Подробное видео работы игрушки есть в обзоре (англ., Youtube). Довольно занимательное решение, между прочим. Немалая игровая ценность образуется из одного единственного приёма – это поворот наверху, позволяющий перенаправлять траспортное средство на разные петли: движение прямо или правый поворот.
Комментировать »
Могут ли в программных системах проверки математических, формализованных доказательств быть ошибки? Конечно. Они там даже есть. И эти ошибки могут проявляться в том, что какие-то неверные цепочки “доказательств”, будут отмечены как верные.
Вероятность ошибки тем выше, чем больше формальных конструкций в доказательстве. Если код доказательства генерирует LLM, а в коде миллионы строк, то вероятность “эксплуатации ошибки” – выше. Почему “эксплуатации”? Потому что никто не сказал, что мощная LLM-система, использующая тот тамый программный парсер для проверки своих сегенерированных “формализаций”, не подберёт ошибку специально так, чтобы формальное доказательство сошлось к нужному результату. Вполне может и подобрать.
Должна ли такая ошибка в парсере вообще воспроизводиться системно? Не должна, но может. То есть, естественно, если у вас дефектный программный “парсер теорем”, но проявление дефекта в нём зависит, скажем, от схемы исчерпания свободного ОЗУ того компьютера, на котором запущен парсер, то выводы системы проверки будут плавающими и это все сразу заметят. Ну как – “все”: не то чтобы прямо “все”, но те, у кого есть вычислительные ресурсы для запуска проверки миллионов строк на гигабайтах ОЗУ. Но это другое дело. Главное, что дефект может быть системным, а это означает, что он строго воспроизводится, раз за разом выдавая одинаковый, но неверный вывод. Как проверить миллионы строк формализации вручную? Никак.
Понятно, что можно взять и написать другой парсер, который либо подтвердит вывод, либо обнаружит ошибку. На вход нового парсера подаётся тот же самый поток доказательств. В конце концов, формализация – это лишь набор текстовых файлов, можно попробовать проверить на компьютере, но разным проверяющим кодом. Такая схема тоже используется, пусть и с ограничениями. Для Lean, например, есть Nanoda. Код парсера даже может быть обозримым. Но только тут необходимо учитывать компилятор. А чтобы доказать, что компилятор выводит тот машинный код, который ожидается, опять нужна формальная проверка на компьютере, в том или ином виде. Читай: нужен тот же парсер с формализацией.
Получается не просто “диагонализация”, а вообще-то некоторый замкнутый круг.
Комментировать »
Дошли слухи, что и новая модель OpenAI GPT-6 Astra, даже в режиме Pro, считает, что причина (существования) дня и ночи на Земле – это вращение Земли вокруг своей оси. Занятно. Несомненно, это сейчас самая продвинутая модель из публично доступных. Но результат “по данному вопросу” – всё тот же. Вообще, тема про вращение Земли и день с ночью – одна из самых показательных. И вовсе не в отношении LLM, а в отношении понимания, знания и “наученности”. Я, кстати, часто к этой теме обращаюсь, и на dxdt тоже.
Почему выше слово “существования” дано в скобках? Потому что тут есть небольшая языковая особенность. Исходный вопрос – на английском, и он хоть и использует определённый артикль, но истолковать, действительно, можно по-разному. Однако толкования не спасают ситуацию: What is the cause of day and night on Earth? GPT-6 почему-то отвечает: Day and night are caused by Earth’s rotation on its axis (дословно: “День и ночь вызваны вращением Земли вокруг своей оси”). Дальше там идут неважные пояснения. Очевидно, это просто неверный ответ, как бы слова ни трактовались (в рамках разумного, конечно). К сожалению, этот неверный ответ – самый распространённый, поэтому-то он и тут вылезает. Но, надо отдать системе должное: если начать подсказывать, то верные ответы начинают вылезать тоже. Впрочем, эта записка немного о другом, а GPT тут лишь в качестве повода.
Как вообще нужно отвечать на вопрос о том, в чём причина существования дня и ночи на Земле? Отвечать нужно прямо и правильно: причина – в Солнце. Почему? Потому, что если убрать Солнце, – как светило, – из системы, то не будет ни дня, ни ночи. Кто-то может потребовать уточнений: дня, понятно, не будет без Солнца, но вот планета-то погрузится в вечную ночь. Как бы ни так! Ночь – это промежуток времени от заката до восхода, так что день – необходим для определения ночи. Нет Солнца – нет восхода. Нет и ночи.
Очевидно?
Почти.
Если начать закапываться в детали, то вылезут небольшие логические хитрости. Первая из них: Земля должна быть непрозрачной. Вот это как раз очевидно. На прозрачной хрустальной Земле солнечный свет просвечивает все стороны одновременно. Вторая хитрость: на непрозрачной Земле не должно быть такой атмосферы, которая рассеивает свет Солнца “по всей поверхности планеты”. Но это именно что неожиданные детали и уточнения. И если убрать Солнце, то даже на хрустальной Земле не будет ни дня, ни ночи.
Рассмотрим теперь другой вопрос: в чём причина смены дня и ночи? Правильный ответ: причина в том, что Солнце вращается вокруг Земли. Потому что если Солнце не вращается вокруг Земли, то на одной стороне той Земли всё время ночь, а на другой – всё время день.
(Откровенно говоря, меня всегда удивлял тот факт, что люди начинают почему-то вспоминать как, якобы, “вот Коперник доказал”, хотя Коперник ничего такого и не пытался доказывать. “Допустим, ваш Коперник прав”, – пояснял Шерлок Холмс. Но какая разница? Да никакой, действительно.)
Кажется, если всё время ночь на одной стороне планеты, тогда эту ночь нельзя будет назвать ночью, поскольку опять нет восхода Солнца. Но это только формально: если путешествовать по такой Земле, проложив подходящий маршрут, то в какой-то момент восход образуется из-за собственного движения путешественника.
Заметьте, Земля, вокруг которой Солнце не вращается, тем не менее вращается вокруг своей оси (в наивном смысле), если только она движется по орбите вокруг Солнца. Как так получается? Очень просто: чтобы всё время быть повернутой к Солнцу одной стороной – Земле нужно вращаться. Но, опять же, вращение тут – это вопрос системы координат. Тем не менее, за движение по орбите тут опять отвечает Солнце. Не было бы Солнца, не было бы данного орбитального движения, а лишь вечный не-день, который вращением не исправить.
Комментировать »
Секунду координации (leap second) хотят отменить совсем. Одна из основных причин: по мнению Международного бюро мер и весов, есть большой шанс, что к 2035 году придётся вводить “отрицательную” секунду координации. То есть, раньше, для коррекции – секунду координации добавляли. Часы, работающие по “общепринятому” источнику частоты, ждали одну дополнительную секунду в сутках, чтобы их догнали астрономические события, связанные с вращением Земли. Расчётные сутки – удлинялись на секунду. Процесс должен компенсировать “убегание” метрологических источников частоты от представления о вращении Земли, как об историческом источнике понятия о сутках. Ну или наоборот – происходило “опережение”, тут уж как посмотреть: главное, что всегда есть некая накапливаемая разница, а знак её, вроде, не так важен. Ну, пока не возникает та самая “отрицательная” секунда координации.
Вопрос этот и сам по себе весьма спорный – вращение Земли не имеет строго определения, координация зависит от используемых методов подсчёта наблюдаемых событий и т.д., и т.п. Но это всё технические мелочи, по сравненению с тем, что в 2035 году эта же трактовка может привести к тому, что нужно будет реализовать “отрицательную” секунду, то есть, “перевести часы в обратную сторону” и одну секунду удалить из привычной минуты, и из суток. Представьте, что за 23:59:58 следует 00:00:00 следующих суток! Для точных компьютерных систем это выглядит пострашнее “проблемы 2000”. Из календаря исчезает секунда, поэтому, предположим, если где-то встретится TLS-сертификат, начало действия которого обозначено как 23:59:59, но дата приходится на сутки, когда произошла коррекция, то, получается, такого таймстемпа просто не существовало. И это даже посложнее, чем если кто-то написал 23:59:63. В последнем случае, хотя бы, можно заявить о нарушении формата, а вот 23:59:59 – никаких форматов не нарушает. Нарушает ли их 23:59:60, кстати? Отдельный вопрос. Как бы там ни было, но “отрицательную” секунду координации придётся дальше учитывать во всех вычислениях с преобразованием таймстемпов в календарное время. Тут и положительная-то секунда постоянно приводит к неприятностям, что уж там говорить об отрицательной.
Так что, вполне возможно, секунд координации больше не будет, остчёт секундного времени станет “равномерным”, но зато сделают сразу час координации. Ну а что – час? К нему, предположительно, нужно будет вернуться через несколько веков (именно: см. Draft Resolution C). Так-то. Было бы кому возвращаться.
Комментировать »
 Новый
