Ресурсы: техническое описание TLS, LaTeX - в картинки (img), криптографическая библиотека Arduino, шифр "Кузнечик" на ассемблере AMD64/AVX и ARM64
Геолокация точки записи звуковой дорожки на основе “допплерограмм” звука пролёта самолётов (Youtube, англ.). В видео по ссылке рассказано о том, как можно точн определить географические координаты точки записи целевого ролика лишь при помощи анализа звуковых отметок, связанных с пролетавшими самолётами.
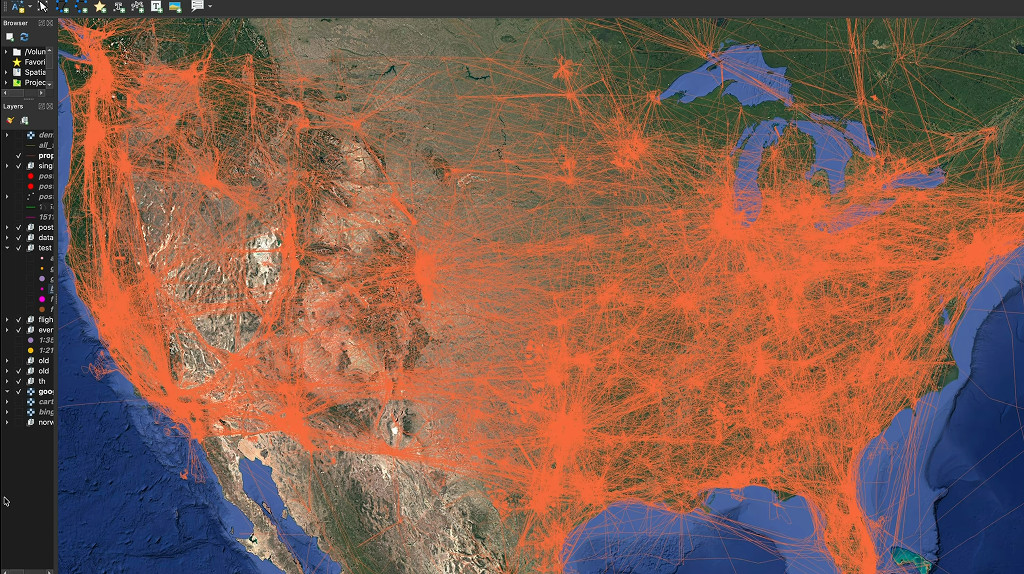
Речь про всю территорию США и заданную дату – то есть, заранее известно только то, что анализируемый видеоролик записан где-то на территории США в заданное время. Визуальных ориентиров в целевом ролике нет. Фокус в том, что траектории, по которым летят самолёты, вводят некоторое достаточно плотное координатное поле, потому что можно выбрать точки на земной поверхности, в которых звук самолёта обладает заданными характеристиками, при этом данные по траекториям – записываются на основании сигналов передатчика ADS-B, их можно скачать из доступных БД (Flightradar и др.). Понятно, что требуется обработка большого объёма данных, но вычислительные мощности сейчас доступны.
Чтобы выбрать подходящие трактории, используется допплеровский сдвиг и временная задержка, которые позволяют определить скорость и расстояние до самолёта в заданный момент времени. Ключевой ход – это учёт моментов времени, когда самолётов на записи не слышно, и использование в качестве опорного фильтра расстояния по времени между двумя акустическими следами в аудио: каждый след соответствует разному самолёту, а интервал между этим следами позволяет отбросить множество комбинаций траекторий, соответствующих разным точкам на земле. То есть, цепочки событий очень сильно помогают и тут.
Комментировать »
Если вы записываете IP-трафик на промежуточном узле, то можно ли в записи обнаружить использование в TLS-сессиях серверных TLS-сертификатов, выпущенных от нестойких ключей доверенного УЦ eMudhra? Можно, но не всегда.
Дело в том, что в TLS 1.3 сообщение с серверными сертификатами уже зашифровано, поэтому, простым способом, не зная сессионных ключей, увидеть, какие там сертификаты – не выйдет. Но в TLS до версии 1.3 – можно непосредственно видеть сертификаты в дампе открытого трафика.
Как распознать сертификаты? Естественно, по значению открытого ключа, либо – по значению подписи. Дело в том, что прямым признаком является промежуточный сертификат с соответствующим открытым ключом. Промежуточный сертификат входит в цепочку, ведущую к подписи на оконечном сертификате и, вообще говоря, должен передаваться в цепочке сертификатов с сервера. Да, в сертификатах есть имена, но они тут имеют вторичное значение (см. ниже), потому что главное – уязвимые ключи. Кто-то может “нарисовать” произвольных сертификатов с соответствующими именами, но другими ключами. Так как мы, по условию задачи, пытаемся выбрать сертификаты из дампов трафика, эти сертификаты даже не обязаны быть доверенными, чтобы обмануть фильтр, использующий только имена. Так что обнаружение таких сертификатов (по именам) в трафике не будет являться признаком того, что кто-то использовал скомпрометированные ключи УЦ. Строго говоря, и сами такие ключи ещё не есть окончательный сигнал: для полноты картины – необходимо сравнить и валидировать подписи (даже несмотря на то, что ключи – тривиальные).
Если не передаётся промежуточный сертификат, то сами подписи на оконечных сертификатах помогут выявить использование скомпрометированных ключей. Только тут уже процесс проверки будет немного сложнее – нужно взять открытый скомпрометированный ключ и проверить, что подпись на оконечном (серверном) сертификате валидируется. Так как данные ключи тривиальные, то даже если имена в сертификате не сходятся, мы всё равно обнаружили некоторый факт использования заведомо уязвимого решения. Но вот тут дополнительное сопоставление имён уже поможет обнаружить исполнение именно конкретного сценария, с конкретным УЦ.
Почему вообще такие TLS-сертификаты могли использоваться? В теории, распространённые браузеры должны проверять метки логов Certificate Transparency в сертификатах, и если сертификат не имеет валидных меток доверенных логов, то браузер не должен верить в такой сертификат. Метки логов можно получить штатным образом, зная подписывающий секретный ключ УЦ. Но дело даже не в этом. Дело в том, что далеко не только браузеры используют TLS. А различные прочие клиенты, которых много разных, вовсе не проверяют метки логов и не требуют их наличия в сертификате. Так что подмена работала (и работает) для многих устройств и приложений. Один из шумных практических примеров – неожиданно грубая ошибка в ПО такого устройства, как “Яндекс.Станция”, позволившая атакующему подставлять свой программный код при помощи атаки типа “Человек посередине”, с использованием тех самых тривиальных ключей eMudhra. Шумность данной проблемы обсуловлена тем, что тривиальность ошибки может легко посморить с тривиальностью самих ключей: доверенных “из коробки” УЦ – сотни, и устройство не может их никак контролировать, проверять нужно отпечатки ключей, а не доверять только коробочным УЦ.
Так что практических случаев применения скомпрометированных ключей очень много. И трудностей тут добавляет то, что проблемные ключи были подписаны другим доверенным УЦ – Sectigo, который горазодо более распространён. То есть, чтобы атака сработала – было достаточно доверия корневым ключам Sectigo.
Итак, в принципе, использование подменных сертификатов, выпущенных от триваильных ключей, можно увидеть в записи трафика, и такие сертификаты могли использоваться ранее. Однако если запись трафика не велась, либо если атакуемым устройством/приложением использовалась только актуальная версия TLS 1.3, где сертификаты передаются в зашированном виде, увидеть уже ничего не получится. Как говорится, “были сертификаты или нет – науке это не известно”. Однако с точки зрения теории защиты информации необходимо считать, что сертификаты такие были. И речь тут – только про TLS, но X.509-сертификаты используются и в других областях.
Комментировать »
Ещу раз отмечу один локально-положительный момент у этой истории вокруг тривиальных ключей в программах доверия браузеров. Я уже упоминал о том, что использую данное направление в качестве источника тем для курсовых работ студентов профильных вузов (обычно, эта тема – для второго курса). И вот в сообщении Google буквально указаны алгоритмы, которые и лежат в основе данной темы, которые прямо используются в реализации. Тема могла показаться слишком оторванной от реальности, но только не теперь.
А именно, то, что в англоязычной традиции называется Baby-Step Giant-Step (BSGS), известно как алгоритм Гельфонда (или Гельфонда-Шенкса) для дискретного логарифма; а вторая часть – разностный метод, – это, в принципе, обобщение предыдущего алгоритма, но с использованием других таблиц. Оба алгоритма на практике могут успешно работать только с небольшим подмножеством скаляров (потому что выигрыш там достигается из использования предвычисленных таблиц, но уже 2^64 – это слишком много по памяти). Этого оказалось достаточно, в данном практическом и шумном случае. Опять же, это математические детали.
Главное тут в другом – данный глобальный практический случай с eMudhra идеально отвечает на всякие сомнения в практической полезности изучения тривиальных логарифмов на эллиптических кривых: даже Google не использовал эти проверки, из-за чего глобальные программы доверия корневым ключам в браузерах оказались скомпрометированы на долгое время. Так что тема оказалась более чем к месту.
Комментировать »
Что ж, в Google хотя бы прямо признали, что проблема с тривиальными ключами была на их стороне тоже: требуемая базовая проверка для ECDSA вообще не выполнялась, поэтому тривиальные ключи от eMudhra прошли в программу и оставались незамеченными очень долго. Цитата:
However, prior to this incident, standard linting tools focused on algorithmic checks for RSA/DSA and blocklist checks for ECDSA; they had not implemented the Baby-Step Giant-Step (BSGS) discrete logarithm checks for small EC private scalars or pairwise EC key differences that paranoid_crypto includes.
(Тем не менее, до этого инцидента, типовые инструменты линтинга были сфокусированы на проверке RSA/DSA и списках заблокированных ключей для ECDSA; инструменты не поддерживали проверку методом малых и больших шагов для дискретного логарифма с малыми секретными скалярами или попарную разностную проверку, как это реализует paranoid_crypto.)
Пишут, что уже исправлено. Посмотрим.
Комментировать »
Про реакцию вокруг истории Удостоверяющего Центра (УЦ) eMudhra, – его скомпрометированных, тривиальных ключей, – сейчас пишут много, и разное. Но образовался какой-то странный перекос. Вообще-то, в данной истории вылезла проблема вовсе не с одним конкретным УЦ, а с программой доверия в целом.
То есть, в доверенной, “коробочной” версии набора ключей, используемой браузерами и прочими системами, повсеместно, больше года находились ключи из пары, “секретная” часть которой не являлась секретной. Совсем не являлась секретной. Да, эти ключи предложили к размещению из одного конкретного УЦ. Однако полностью скомпрометирована оказалась вся программа: ключи туда приняли, они были подписаны другим УЦ, повсеместно включены автоматом в качестве доверенных. Действия одного УЦ – компрометация всей программы. Больше года – время реакции.
Не сомневайтесь, именно так и было: ключи промежуточных УЦ уже много лет, по условиям тех самых программ доверия браузеров, необходимо предъявлять сразу после выпуска, это строгое требование; на тривиальных ключах была поставлена кросс-подпись другого хорошо известного доверенного УЦ (Sectigo). Тут целый ряд авторитетных корпораций (Google, Mozilla, Microsoft, Apple) – законодатели мод и локомотивы разнообразных требований и рекомендаций, ограничивающих участие в программах доверия. Для безопасности.
Однако в программе явно “что-то пошло не так”. Поэтому реальная проблема – гораздо больше и основательнее.
Но почему-то заметают её под ковёр.
Комментарии (4) »
Удивительно, что во многих проектах, оказывается, TLS с сертификатами “из коробки” используется для подтверждения не только источника, но и подлинности важных данных (например, кода обновления и т.д.). То есть, если узел-источник аутентифицирован в рамках коробочного TLS, относительно внешних УЦ, то и все данные, полученные с этого узла, подлинные – потому что источник, как бы, подлинный. Cейчас этот момент, – “неожиданно!”, – обсуждается. Естественно, в свете истории с тривиальными ключами удостоверяющего центра (УЦ) eMudhra, которые, несмотря на свою тривиальность, упешно и без вопросов были включены во все распространённые программы доверия CA/B-форума, в том числе, в браузеры от Google и Mozilla (к большому сожалению), где и находились больше года.
Вообще, если у вас приложение, которое скачивает обновления или ещё какие-то важные данные, то TLS тут можно и нужно использовать, но хорошо бы понимать, что и как там работает. То есть, тут однозначно нужен и key pinning, и дополнительное (помимо TLS!) удостоверение подлинности данных. То есть, данные в любом случае должны быть подписаны от доверенных ключей, и доверие должно быть зашито в приложение помимо внешней системы УЦ. Казалось бы, это хрестоматийные азы данного направления. И тем не менее – не везде таким правилам следуют.
Что такое key pinning? Это когда ваше приложение дополнительно сверяет отпечатки ключей сервера и, возможно, УЦ, с внутренними эталонами. Как и почему это работает? Если кто-то перехватил соединение и подменил сертификат сервера, то на стороне вашего приложения будет виден другой открытый ключ, не тот, который закреплён за подлинным сервером. Да, на этот открытый ключ будет выдан поддельный “доверенный” сертификат, для выпуска которого использовался скомпрометированный УЦ. Но ключ заведомо будет другим, что и позволит обнаружить подмену. Простое следование тому, что библиотека с системным хранилищем доверенных ключей подтвердила “подлинность TLS-сервера”, означает совсем не то, о чём, как оказывается, многие разработчики думают.
Действительно, даже в начале моего собственного описания TLS написано, буквально, следующее:
“TLS ставит своей целью создание между двумя узлами сети защищённого от прослушивания и подмены информации канала связи, пригодного для передачи произвольных данных в обоих направлениях, а также проверку того, что обмен данными происходит между именно теми узлами, для которых канал и планировался. Эти задачи называются, соответственно, обеспечением конфиденциальности, целостности и подлинности соединения (аутентификации).”
Тут всё написано верно. Но, похоже, надо будет добавить пояснения. Дело в том, что, да, одна из целей TLS – обеспечить проверку того, что “обмен данными происходит между именно теми узлами, для которых канал и планировался”. Но из этого не следует, что TLS-библиотека автоматически и прозрачно подтверждает подлинность узлов. TLS – это набор спецификаций. То, как с этими спецификациями живут библиотеки, – а тем более – списки доверенных ключей, – несколько другая история. TLS предоставляет возможности для аутентификации, которые описаны в протоколе. Но TLS, как спецификация, не гарантирует даже правильного понимания спецификаций.
Посудите сами. Во-первых, инфраструктура TLS-сертификатов находится за рамками TLS и имеет мало отношения именно к спецификации клиент-серверного TLS-соединения. Во-вторых, типичный “коробочный” процесс аутентификации узла использует некоторый внешний набор доверенных ключей. Обычно, этот набор является внешним даже для TLS-библиотеки! Аутентификация в TLS, на фундаментальном уровне, возможна только в отношении открытых ключей, а никак не IP-соединения. Соответственно, нужно понимать, что когда аутентификация выполняется библиотекой без должного внимания (без сравнения отпечатков), успех этой аутентификации означает не то, что “узел подлинный”, а, – внимание!, – то, что некоторый внешний игрок (УЦ) говорит, что узел с данным ключом и под данным именем контролирует тот же, кто подавал заявку на соответствующий сертификат. Это совсем другое! Почувствуйте, как говорится, разницу. Кому тут верит клиент? Конечно – УЦ, а не оконечному узлу.
В рамках TLS сервер передаёт свой открытый ключ и подтверждает, что знает соответствующий секретный ключ. То же самое может сделать и TLS-клиент. То есть, TLS предоставляет механизм для такого обмена: описывает, в какие блоки данных записывать ключи, в какие – записывать подписи, что именно подписывать, как обмениваться результатом. Но проверка того, что ключи действительно те самые, находится за пределами спецификации. Очевидно, спецификация универсального протокола не может ничего такого гарантировать – нельзя “прибить ключи” в спецификацию (хотя в библиотеки вот уже начали прибивать, но это – от непонимания).
Почему вообще возникает проблема? Потому что открытая схема использования TLS, – например, в вебе, для HTTPS, – предполагает, что клиент не может заранее узнать значения ключей. Это совершенно верное, логичное допущение. В нём и смысл – нужно сделать так, чтобы доверие можно было распространять на новые ключи ранее неизвестных узлов, автоматически. TLS это позволяет реализовать. Но нужно создать общий список доверенных ключей третьей стороны. Отсюда возникает инфраструктура УЦ.
Однако это совсем другая история, по сравнению с загрузкой, например, конкретных обновлений в конкретное приложение (или на устройство, тем более). Там-то как раз заранее известно, что нужно верить только в определённые ключи, и ключи сами – известны. И замена ключей в такой схеме вполне возможна: всё это отработано годами (см. устройство браузеров, репозиториев ОС). Должны быть резервные ключи, новые ключи – подписываются от старых, и так далее: это никак не мешает ведению собственной, независимой от произвольного списка внешних УЦ, схемы.
Комментировать »
Немного элементарных математических подробностей о “коротких ключах” УЦ eMudhra. Секретный ключ в ECDSA – это натуральное число в некотором заранее известном интервале, от 2 до N. Арифметика там довольно простая. Обозначим ключ d. Этот ключ d на техническом языке называют “секретным скаляром”, но, вообще говоря, от этого он не перестаёт быть натуральным числом (натуральные числа, если кто вдруг забыл, это “обычный” счёт: 1, 2, 3, 4, 5 и так “до самого большого числа”).
Открытый ключ в ECDSA получается из секретного умножением точки-генератора G на секретный скаляр; на техническом языке: [d]G. Точка-генератор – это точка, принадлежащая эллиптической кривой, используемой в данном наборе параметров криптосистемы. Умножение здесь вводится как повторное сложение: [2]G = G + G. Задача вычисления d по известной точке [d]G в произвольной группе точек кривой считается вычислительно сложной.
Минимальное значение 2 – оно очевидно из соображений умножения; понятно, 2 – это угадываемое число (см. важные детали ниже). Максимальное значение N – про него обычно пишут, что это “порядок группы точек”. Это, опять же, технический термин, который обозначает количество точек, потенциально доступных при операциях данной криптосистемы. Математически, эта самая группа точек так устроена, что всё её элементы образуются сложением генератора G с самим собой (сложение здесь – обозначение групповой операции; на техническом языке такая группа называется “циклической”). Это всё может показаться сложным, из-за терминов, но на практике это просто закольцованная цепочка значений (точек): складываете один элемент с самим собой – идёте последовательно по другим элементам, которые получаются в результате; на определённом шаге – процесс зацикливается, попадаете “в начало”, в нейтральный элемент (следом за которым будет опять генератор G, потому что G = G + 0). На практике нельзя брать именно порядок группы M в качестве максимального значения, берут, например, M-2, но это технические детали.
Точек кривой в практических криптосистемах ECDSA очень много. Их количество близко к разрядности записи, то есть, например, около 2^256. Очень много. Это определяющий момент: если бы точек было мало, то их можно было бы перебрать за обозримое время все, определив секретный скаляр. Да, практически так же, как в рассматриваемом случае нестойких ключей, но только универсальным образом.
Опять же, в упомянутом случае – набор точек называется P-384 (обычно говорят, что это “кривая P-384”), базовая разрядность – 384 бита. Точка кривой – это тоже два натуральных числа, из определённого интервала, связанных определённой формулой в пару координат. Точка-генератор G – всем известна, это открытый параметр криптосистемы. Обычно, хотя бы одна из координат G – это “большое” натуральное число. Но данные аспекты не относятся к обсуждаемой теме прямо. (Кстати, “большое” тут в кавычках, потому что с порядком в группе точек кривой всё не так просто, как хотелось бы.)
Соответственно, умножаем известную точку G на подбираемое значение d (это быстрая операция), получаем точку Q, представленную парой координат (натуральных чисел), сравниваем получившиеся координаты с атакуемым открытым ключом, если совпало – мы нашли секретный ключ, он равен d.
Итак, значение секретного ключа d, натуральное число, которое на практике должно лежать в некотором большом интервале. Казалось бы, идеально – равновероятное распределение по всем возможным значениям. Но тогда и угадываемое число 254 (например) оказывается столь же вероятным, как и все прочие, не так ли? Почему же подобные малые числа должны отбрасываться? Потому, что есть внешние допущения, связанные с битовым представлением. “Слишком много нулей” – это одна из сигнатур, связанных с дефектами в реализации алгоритмов. Такие сигнатуры накладываются на доступный интервал и оказывается, что атакующий может угадать 254 именно потому, что он будет перебирать варианты, в которых “слишком много нулей”. Если бы запись скаляра 254 не обладала отличительными чертами (все старшие биты – нуль), то и угадать его было бы не так легко. Представьте, что скаляры d “перетасовали” секретным идеальным способом и 254 перешло в какое-то произвольное значение – как теперь его найти? Только полным перебором.
Но если при выборе секретного ключа d заведомо берутся значения больше 255 (например), то что это означает? Ничего нового: теперь нужно перебирать 256, 257, 258 и т.д. То есть, тут важен не сам аспект, что “все старшие байты нулевые”, а наличие дополнительной информации о структуре распределения секретных ключей. Естественно, есть хорошо известные варианты, к которым и относится этот случай с последовательными нулевыми байтами. Это тривиальные ключи, подпадающие под универсальные ошибочные схемы. И эти случаи можно проверять без какой-то дополнительной информации. Но если, предположим, известно, что секретные ключи на сервере – это значение SHA-256 от текущего таймстемпа и IPv4-адреса сервера, то пространство перебора тоже не очень велико.
Комментировать »
Немного пояснений к предыдущей записке, о том, что в стандартную библиотеку Go crypto/x509 “гвоздями прибили” некоторые отпечатки открытых ключей, которым библиотека теперь не доверяет напрямую, минуя все прочие проверки. Причина, как бы, в том, что у некоторого УЦ утекли ключи от доверенных промежуточных сертификатов (по ссылке от Beldmit есть важные подробности). Что тут можно сказать? Основное: это максимально странная история – типичный костыль, неожиданность постановки которого только укрепляется тем, что это сделано в Go. Далее – чуть подробнее.
Во-первых, таким способом можно заблокировать на уровне библиотеки любые ключи из TLS-сертификатов, вне зависимости не только от системных настроек, но и от программного кода, который эту библиотеку вызывает. Например, можно заблокировать ключи какого-нибудь корпоративного УЦ. Из-за того, что в библиотеку встроены отпечатки (значения хеш-функций), даже понять, что это за ключ, не зная соответствующего сертификата, очень сложно. Представьте, что обычный разработчик использует данную библиотеку в своём приложении. Теперь этот разработчик обновил среду сборки на новую версию Go, пересобрал код приложения без изменений – бах! сертификаты не валидируются. Никаких политик, ничего подобного – не менялось.
А ведь данная библиотека даже не проверяет статус сертификата (не отозван ли), о чём там прямо написано в документации и комментариях. Конечно, если бы статус проверялся, то и вопрос бы, возможно, решился. Но не проверять статус сертификата автоматически – это совершенно нормально для такой, достаточно низкоуровневой, библиотеки. Прибивать внутри конкретные ключи – не нормально совсем. Ключи, заметьте, это даже не алгоритмы – алгоритмы в библиотеках Go для TLS блокировались и раньше, ключи в таком виде – пока не прибивали, это первый случай.
Во-вторых, что касается отзыва сертификатов, статуса, который, якобы, невозможно проверить. Да, в современных браузерах есть механизмы распространения отпечатков недоверенных ключей с обновлениями. Есть CRLSet (Chrome), который равно так и работает: без штатного механизма отзыва, по отпечаткам ключей напрямую. Но в данном случае речь про среду разработки. Неужели кто-то считает, что можно моментально пересобрать все те сотни приложений, которые используют данную библиотеку? Нет, это невозможно. В конкретном браузере – единый канал распространения обновлений и отлаженный процесс. При этом иногда приложения вообще не имеют автоматического механизма обновлений. Некоторые приложения не обновляются месяцами и годами, и там нет не то что механизма “пересборки”, но даже и процесса, который позволил бы штатно и быстро что-то пересобрать и доставить новые бинарные исполняемые файлы. То есть, “костыльная” схема с прибиванием ключей заведомо не является оперативной: многие и многие скомпилированные ранее приложения как работали, так и продолжат работать.
В-третьих, если такие экстраординарные меры, – специальный релиз Go, – приняты, то считаются ли теперь все вышеупомянутые приложения, собранные на старой версии, скомпрометированными? Непонятно. Да, механизмы управления списком доверенных сертификатов есть в ОС. Но, получается, эти механизмы тут сразу признаны неработающими. Надо заметить, что работают они, действительно, очень плохо, но это не означает, что нужно теперь в неплохую библиотеку “прибивать ключи гвоздями”. Более того, очевидно, что если приложение не имеет механизма управления списком доверия, то это приложение, вполне вероятно, не имеет и возможности нормального обновления через пересборку.
Нехорошая тенденция, в общем.
Комментарии (3) »
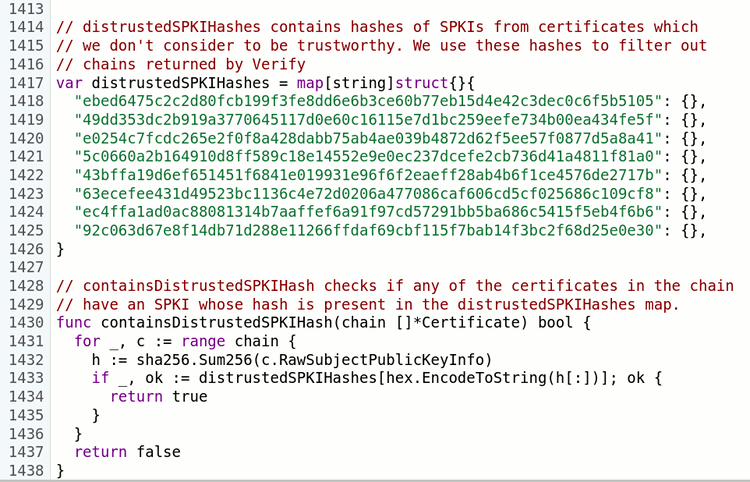
В стандартной библиотеке Go crypto/x509, к сожалению, тоже начали понемногу разламывать внутреннюю логику: в свежем релизе 1.27.3 добавлена функция, которая внутри библиотеки, в ветке проверки валидности цепочки сертификатов, непосредственно признаёт невалидными сертификаты по отпечаткам некоторых открытых ключей.
Нормальных объяснений – что это за ключи, почему их нужно встроить непосредственно в библиотеку, – нет. Сказано только, что это результат компрометации УЦ. Почему это должно требовать изменения логики работы verify.go, с привязкой к конкретным ключам, не объясняется. Очень странно.
Заметьте, что данный способ отбрасывания сертификатов по отпечаткам ключей работает вне зависимости от того, какой список доверенных сертификатов вы используете: ещё раз – ключи зачем-то зашили прямо в исходный код библиотеки (distrustedSPKIHashes в коде verify.go).
Комментарии (4) »
Какую статистику могут собирать системы Let’s Encrypt, как крупнейшего, по количеству оконечных TLS-сертификатов, удостоверяющего центра (УЦ) в Интернете? Вроде, часть статистики очевидна – имена доменов, IP-адреса, которые вносятся в сертификаты, и т.д. Но можно “загадать” и неочевидные элементы.
Начнём, впрочем, с очевидных. Понятно, что любые имена, которые УЦ вносит в сертификаты, это предмет внутренней статистики: общее количество, количество сертификатов на имя, разбивка по дереву DNS. Тут, при разбивке, не только по доменам верхнего уровня нужно делить: куча сертификатов Let’s Encrypt выпускается для технических доменов четвёртого, пятого уровня, и даже ниже (максимум – десятый, это ограничение УЦ). Сюда же относится и срок действия выпущенного сертификата: сколько коротких, сколько – обычных, как это проецируется на имена.
Менее очевидные показатели. Прежде всего, проверка права управления ресурсом (именем). Тут напрашивается подсчёт вариантов: DNS, HTTP, ALPN и т.д. Всё с разбиением по типам сертификатов, по открытым ключам. Узлы, с которых запрашиваются ACME-проверки, обозначат IP-адреса источников ACME-запросов. В рамках проверки можно обнаружить, где размещаются проверяемые ресурсы: хостинг DNS, хостинг веб, распределение IP-адресов. Причём, можно построить соответствие адресов, на которых используется сертификат (см. ниже), с адресами, которые “засветились” в процессе проверки права управления.
Важна статистика по результатам проверки: успешно, не успешно, причины отказа. Данные по CAA-записям – какие имена, где размещены сами записи (не обязательно совпадает с DNS-DCV, потому что CAA-запись может быть выше уровнем).
И, конечно, всё с разбивкой по ACME-аккаунтам. Потому что каждый ACME-аккаунт имеет собственный набор идентификаторов (ключ, номер и т.д.).
Откуда тут вообще возьмутся IP-адреса, отличные от тех, которые, – возможно, – указаны в сертификатах? Прежде всего, ACME-клиент приходит с какого-то IP-адреса. Это можно зафиксировать и привязать к ACME-аккаунту. Когда DCV-подсистема проверяет право управления, эта подсистема осуществляет опрос DNS (во всех случаях, кроме, возможно, проверки управления конкретным IP-адресом) – IP-адреса авторитативных серверов DNS разных уровней тоже можно записывать. При проверке HTTP – запросы к веб-серверу отправляются по конкретным IP-адресам; если процесс связан с DNS-проверкой, то IP-адрес берётся из DNS, если с проверкой IP-адреса, то этот адрес указывается в заказе, отправленном по ACME. Соответственно, получаем ещё адреса, пригодные для включения в статистику. И эти адреса можно привязать к сертификатам, ключам, доменным именам.
Откуда взять IP-адреса узлов, на которых используется сертификат? Для сертификата, который выпущен для IP-адреса – очевидно: из самого сертификата. Для DNS-имён – чуть менее очевидно: заказ и получение сертификата не обязаны выполняться с тех же серверов, где сертификат будет использоваться. Однако всякий уважающий себя УЦ выполняет, при помощи специального бота, обход узлов, имена которых указаны в выпущенных сертификатах, как раз для того, чтобы вести статистику использования. Из этого процесса и возьмутся IP-адреса носителей. Если, конечно, соответствующие узлы доступны для бота.
Некоторую статистику можно было бы видеть по OCSP-респондерам, но их в Let’s Encrypt больше нет. Из действующих схем проверки статуса сертификата остаются списки отзыва (CRL). Соответственно, можно строить статистику запросов к точкам раздачи этих списков – с каких IP-адресов и какие именно CRL-файлы запрашивают. Ещё есть точки раздачи промежуточных и корневых сертификатов УЦ. Опять же, запросы к ним – дополнительный источник статистики.
Комментировать »
Как известно, буква S в аббревиатуре IoT означает Security (безопасность). Свежая публикация от Anthropic (компания из области AI/LLM, Claude) рассказывает о том, что “ИИ/LLM” смогут “самореплицироваться” и распространяться по IoT-системам. То есть, рассказывают, что вот теперь LLM будут свои наборы коэффициентов загружать на устройства типа “умных” пылесосов. Буквально, основная идея большой публикации по ссылке выше (с картинками!) в том, что, мол, LLM-агент взломает управляющую систему пылесоса, – или, может, даже холодильника, – перенесёт туда гигабайты своих коэффициентов, и запустит “инференс” на этом вновь захваченном устройстве, чтобы взламывать следующее. И это вызывает воспоминания о полиморфных вирусах для ПК под MS-DOS, появившихся в начале 90-х годов прошлого века, более тридцати лет назад.
Полиморфные вирусы “запаковывали” и зашифровывали основную свою программу, а распаковщик – генерировали разный, по шаблону, обычно. То есть, на новой системе у запакованного вируса не было статических сигнатур, за которые могла бы зацепиться антивирусная программа, осуществлявшая поиск. Ещё раз: после того, как вирус выбирал путь распространения на новую систему (через исполняемый файл-носитель, обычно), этот вирус генерировал собственный распаковщик, прикреплял к нему зашифрованное тело вируса, и записывал этот код на носитель, для распространения дальше. На новой системе вирус распаковывался, исследовал окружение, закреплялся в системе разными способами (их было где-то с десяток, некоторые – довольно изящные), и начинал собственное распространение.
“Полиморфность” – только одна из особенностей. Продвинутые компьютерные вирусы уже тридцать лет назад имели довольно сложную встроенную логику, позволявшую обнаруживать другие вирусы и блокировать конкурентов, обнаруживать и отключать/блокировать антивирусы, выбирать способ закрепления в системе согласно имеющейся конфигурации и т.д., и т.п. Были вирусы, которые могли переходить между разными типами систем. И никаких многогигабайтных LLM для этого не требовалось. Требовалось хорошее знание ассемблера и аппаратуры от разработчика (что и сейчас не помешает).
Естественно, в новости про саморасползающиеся через захват пылесосов LLM указано важное отличие: якобы, такой LLM-агент сможет атаковывать и заражать аппаратные архитектуры, с которыми раньше не сталкивался (но в качестве примера приводят Android почему-то). Не ясно, только, откуда же такой агент возьмёт описание этой новой аппаратной архитектуры и как сможет определить, что за архитектура в очередном пылесосе используется. Мог ли древний компьютерный вирус, разработанный под MS-DOS на x86 заразить SPARCstation под SunOS? Почему нет? Тут даже не нужен полноценный кросс-ассемблер – достаточно одного из аспектов реализации “полиморфности”: этот аспект сможет переводить машинный код с одной платформы на другую. Такие решения даже существовали, но, понятно, массовыми они быть не могли по другим причинам.
Комментировать »
 Новый
