Ресурсы: техническое описание TLS, LaTeX - в картинки (img), криптографическая библиотека Arduino, шифр "Кузнечик" на ассемблере AMD64/AVX и ARM64
Воскресное чтение манускриптов. Сегодня продолжаем читать “Арифметику” Диофанта.
“Арифметика” на манускриптах уже связана с целой серией записок, в которой нам встречались: “маргинальный” комментарий к первой задаче; разбор текста первой задачи на манускрипте Vat.gr.191 в двух частях; принципы обозначения неизвестной у Диофанта и правило “минус на минус”; а также необычные “кубо-кубосы”, используемые для обозначения степеней неизвестной в “Арифметике”.
В этот раз – читаем вторую задачу, в версии всё того же Vat.gr.191 – манускрипта 13 в. из Ватиканской Апостольской библиотеки. Вторая задача, как легко догадаться, идёт сразу после первой.
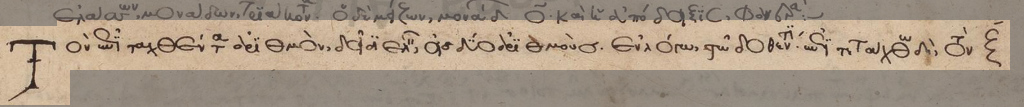
Это первое предложение второй задачи. В современной типографике: τὸν ἐπιταχθέντα ἀριθμὸν δεῖ διελεῖν εἰς δύο ἀριθμοὺς ἐν λόγῳ τῷ δοθέντι. Здесь задача формулируется: “заданное число нужно разбить на два числа, [находящихся] в соотношении данном”. Как и в первой задаче, тут под “разбить” понимается “представить в виде суммы”. То есть, это A == X + 3X. Можно сказать, что задача для начальной школы. Так, судя по всему, и было во времена Диофанта, да и, собственно, за четыре тысячи лет до него тоже. Почему всё ещё иногда приходится слышать, что, якобы, изучаемые в начальной школе сейчас, – в 21 веке н.э., – арифметические задачи представляли какой-то “недостижимый уровень” пару тысяч лет назад – загадка. Но, вообще-то, далеко не все задачи в “Арифметике” настолько простые. Возможно, в чтении “Арифметики” мы доберёмся и до сложных тоже.
Оставшаяся часть выделенной строки это начало предложения, переходящего на следующий лист (361r). А именно: ἐπιτετάχθω δὲ τὸν ξ̅ … – и продолжение на следующем скриншоте.
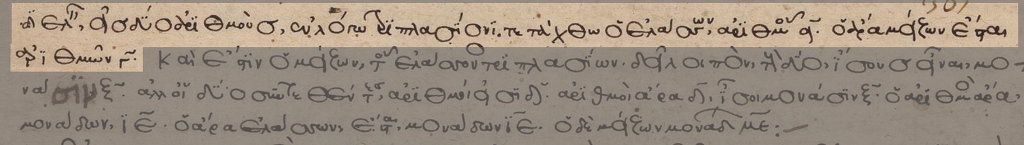
Продолжение: …διελεῖν εἰς δύο ἀριθμοὺς ἐν λόγῳ τριπλασίονι. Перевод будет ниже. Здесь есть интересный письменный момент – лигатура.
Обратите внимание на “закорючку”, с торчащим вверх хвостом, примерно в конце первой трети первой строки. Это не просто закорючка, а скорописная лигатура τρ в слове τριπλασίονι. Занятно, что в других случаях на этом же манускрипте τρι- в τριπλασίονι записано обычным способом (см. ниже).
Перевод: “[пусть] задано 60 разбить на два значения (“арифмоса”) в отношении тройном (τριπλασίονι)”. Число 60 в греческих обозначениях это ξ̅ . “Арифмосы” это диофантово обозначение для переменной величины. В этом манускрипте пока что “арифмосы” записаны полным словом. В современных текстах Диофанта (но на древнегреческом, конечно), вместо “арифмосов” будет обозначение, напоминающее букву S.
Читаем выделенную строку дальше: τετάχθω ὁ ἐλασσων ἀριθμος α̅. Перевод: “назначим меньшему значение 1 (α)”. То есть, у нас должно быть две кратности одной переменной, раз одна кратность составляет три других, то меньшее будет с единичной кратностью.
Есть большее и меньшее, но с учётом множителей при переменной. Здесь, буквально, имеется в виду вот что: запишем 1*X и 3*X, где 1*X – меньшее, а 3*X – большее. И X, как переменная, это “арифмос”. Про 3 * X написано дальше: ὀ ἄρα μείξων ἔσται ἀριθμῶν γ̅ . Перевод: “а большее будет (со) значением три”. γ̅- это три: α,β,γ,…
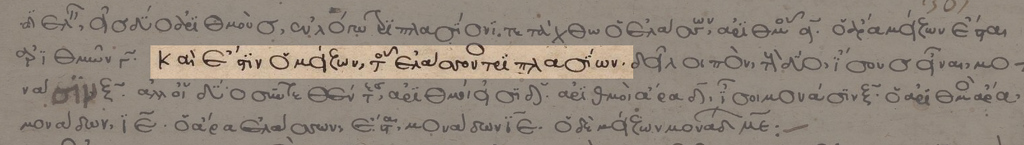
Читаем, разбирая закорючки и сокращения скорописи: καὶ ἔστιν ὀ μείξων τοῦ ἐλάσσονος τριπλασίων. Здесь, помимо τοῦ, есть знак, похожий на большую надстрочную O. Это скорописное сокращение для -ος на конце слова. Кроме того, в ἐλασσονος ещё и двойная сигма записана лигатурой. Буквальный перевод: “и большее есть меньшее утроенное”. То есть, 3X == X+X+X. Обратите внимание, что тут τρι- в τριπλασίων записано обычным образом, не так как выше, с лигатурой. Почему? Это отдельная тема.
Читаем дальше.
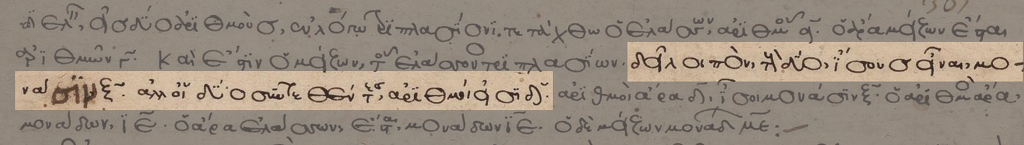
Текст: δεῖ λοιπὸν τοὺς δύο ἴσους εἶναι μονά(σιν) ξ̅ ἀλλ’ οἶ δύο συντεθέντες ἀριθμοί εἰσι δ̅. Перевод дословный: “так в результате два [значения] равны будут 60 единицам (μονάσιν), но два соединённых значение имеют 4″. Или: “сумма равна 60, а оба коэффициента при переменной дают 4”. Тут важно не перепутать “монады” с “арифмосами”. “Монады” – это единицы. 60 “монад” – это итоговое натуральное число шестьдесят. “Арифмосы” – это переменные и коэффициенты при переменных, и тот факт, что обе части переменных вместе (то есть, “соединённые, согласованные”) имеют значение в четыре (“арифмоса”), обозначает, что 3X + X = 4X. Это 4X и есть “четыре арифмоса”, то есть, буквально X+X+X+X.
Это всё часто кажется элементарщиной, но если речь про книгу “Арифметика”, то необходимо точно определить базовые понятия с самых первых страниц. Это не так-то просто сделать. Например, умножение можно определить как повторное сложение. И сейчас многие “продвинутые пользователи” думают, что, мол, автоматически “всё со всем коммутирует” (о том, что это не так – догадываются разве что алгебраисты). Отсюда происходят занимательные неверные толкования задач современной начальной школы – тут я традиционно ссылаюсь на записку про некоммутативные апельсины.
Вернёмся с манускрипту. Теперь читателю “Арифметики” должно быть понятно, что 4X – это 60. О чём и написано дальше.
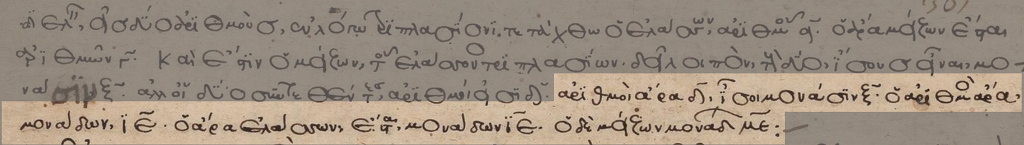
Заключительный фрагмент решения задачи: ἀριθμοὶ ἄρα δ̅ ἶσοι μονάσιν ξ̅. ὁ ἀριθμὸς ἄρα μονάδων ι̅ε̅, ὁ ἄρα ἐλάσσυων ἔσται μονάδων ι̅ε̅, ὁ δὲ μείζων μονάδων μ̅ε̅. Дословный перевод: “значений же четыре равно единицам 60, и (одно) значение составляет 15, значит, меньшее есть единиц 15, а большее же – единиц 45”. На русском языке: “переменная с коэффициентом 4 равна 60, значит она составляет 15, поэтому меньшее число есть 15, а большее – 45”. То есть, нашли ответ: X == 15; 3X == 45; 3X + X == 45 + 15 == 60. Те самые шестьдесят “монад”, которые образовались из 15 (ι̅ε̅) “монад” и 45 (μ̅ε̅) “монад”. То есть, тут, – прямо в самом начале предложения, – четыре (δ̅) “арифмоса” равны шестидесяти (ξ̅) “монадам”. “Арифмосы” – это ящики или коробки, в которые укладываются “монады”, в разном количестве. Здесь их пятнадцать. Именно так арифметику строят и сейчас, с той лишь небольшой разницей, что “монадой” нынче принято называть один пустой “арифмос”.
Комментировать »
Могут ли в программных системах проверки математических, формализованных доказательств быть ошибки? Конечно. Они там даже есть. И эти ошибки могут проявляться в том, что какие-то неверные цепочки “доказательств”, будут отмечены как верные.
Вероятность ошибки тем выше, чем больше формальных конструкций в доказательстве. Если код доказательства генерирует LLM, а в коде миллионы строк, то вероятность “эксплуатации ошибки” – выше. Почему “эксплуатации”? Потому что никто не сказал, что мощная LLM-система, использующая тот тамый программный парсер для проверки своих сегенерированных “формализаций”, не подберёт ошибку специально так, чтобы формальное доказательство сошлось к нужному результату. Вполне может и подобрать.
Должна ли такая ошибка в парсере вообще воспроизводиться системно? Не должна, но может. То есть, естественно, если у вас дефектный программный “парсер теорем”, но проявление дефекта в нём зависит, скажем, от схемы исчерпания свободного ОЗУ того компьютера, на котором запущен парсер, то выводы системы проверки будут плавающими и это все сразу заметят. Ну как – “все”: не то чтобы прямо “все”, но те, у кого есть вычислительные ресурсы для запуска проверки миллионов строк на гигабайтах ОЗУ. Но это другое дело. Главное, что дефект может быть системным, а это означает, что он строго воспроизводится, раз за разом выдавая одинаковый, но неверный вывод. Как проверить миллионы строк формализации вручную? Никак.
Понятно, что можно взять и написать другой парсер, который либо подтвердит вывод, либо обнаружит ошибку. На вход нового парсера подаётся тот же самый поток доказательств. В конце концов, формализация – это лишь набор текстовых файлов, можно попробовать проверить на компьютере, но разным проверяющим кодом. Такая схема тоже используется, пусть и с ограничениями. Для Lean, например, есть Nanoda. Код парсера даже может быть обозримым. Но только тут необходимо учитывать компилятор. А чтобы доказать, что компилятор выводит тот машинный код, который ожидается, опять нужна формальная проверка на компьютере, в том или ином виде. Читай: нужен тот же парсер с формализацией.
Получается не просто “диагонализация”, а вообще-то некоторый замкнутый круг.
Комментировать »
Ещё из серии “Забавные истории с LLM”. Снова Claude. Так как на пути программного кода возводятся неожиданные “кибербезопасные препоны” (cybersecurity guardrails), я тут на днях решил попробовать задачи из области теоретической математики: там есть Lean (это инструмент описания и проверки “компьютерных доказательств”), но не должно быть “кибербезопасных препон для безопасной безопасности”. На роль примера я наобум выбрал задачу 11.115 из “Коуровской тетради” (этот широко известный в узких кругах канонический список я упоминал ранее; как оказалось, не зря упоминал). Я набросал общее описание контрпримера к задаче, в меру собственного понимания, и попросил Claude найти конкретный контрпример и подготовить соответствующее доказательство на Lean.
Система Claude существует в нескольких LLM-воплощениях, доступны мне не все, но основные, как я понимаю, доступны. Сперва я задал запрос в Fable 5. Оно почему-то зациклилось и кружилось внутри себя, наступая периодически на “лимит вызова команд”, очень долго. Наверное, часа два. Никакого результата не выдало, но “кредиты” съело (неплохая “бизнес-модель”, кстати: показываем “юзеру” какие-то меняющиеся текстовые строки в браузере через Javascript и списываем за это “кредиты” в огромных количествах). Но не будем торопиться с выводами.
Потом я решил запустить в той же ветке Opus 5 Max. Как ни странно, Opus 5 Max довольно быстро нашло контрпример (да! и очень даже похожий на правду – см. ниже), но совсем не осилило Lean. Код Lean содержал какие-то вымышленные имена теорем, которых нет в библиотеках (я не очень хорошо понимаю Lean, но, думаю, тут всё именно так). Claude Opus 5 Max – объяснило, что на своей стороне не может компилировать Lean-код: нет среды и не хватает места, чтобы развернуть из пакетов. Но без машинного доказательства все рассуждения LLM, даже такой сверхмощной, о контрпримере, даже для такой простой задачи, – мне, к сожалению, не очень-то полезны (мой план-то был другим: попытаться вручную из корректного Lean-кода восстановить привычное математическое описание контрпримера).
Казалось бы, всё опять застопорилось.
Но нет. Внезапно Anthropic выпустили Fable 5.1. Буквально, вчера. Якобы, Fable 5.1 “сильно лучше в исследовательских задачах”, чем предыдущая Fable 5. Без особой надежды на успех, попробовал я в том же чате, со сломанным Lean, запустить Fable 5.1. Как ни странно, но оно бодро заявило, что сейчас в коде Lean оставит только те библиотеки (import), которые реально нужны для этого доказательства. Это логично. И, – возможно, – среда Lean c этими библиотеками влезет в доступные гигабайты контейнера на стороне Claude, так предположило Fable 5.1. После чего, как ни странно, действительно “урезало библиотеки” и действительно исправило ошибки в Lean-коде, так что стало понятно, что имеется в виду. В итоге, выдан файл с Lean-кодом, который уже компилируется и корректен со всех точек зрения, кроме того, что там могут быть неверные исходные допущения, но это я планирую проверить позже. Так вот.
(На всякий случай: если код и контрпример окажутся правильными, то, да, это будет решение для 11.115, которая пока что отмечена в тетради как открытая. Задачу я выбрал случайно, а критерием было то, что я сам смогу быстро написать условия на контрпример – поэтому-то и задача выбрана очень простая по формулировке и составу используемых объектов. Да, LLM-системы развиваются. Но тут и контрпример – какой-то подозрительно очевидный; если кому-то интересны супертехнические подробности, то вот: построим подгруппу на словах с чётными и нечётными степенями (это отображение в Z/2Z), и подгруппу на соотношениях с a^2. Код Lean я пока не публикую, поскольку не проверил, да и это всё может оказаться “подтягиванием” другого результата, который просто забыли упомянуть составители сборника.)
Комментировать »
В декабре 2024 года я писал на dxdt, что эффективным направлением применения ИИ-LLM к математическим задачам был бы поиск контрпримеров к более или менее известным утверждениям, в формате компьютерного доказательства. В качестве примера сборников подходящих задач я приводил “Коуровскую тетрадь” (это широко известный в узких кругах канонический список задач теории групп). Цитата из той записки:
Для заметной части из этих проблем и связанных задач можно было бы отыскать контрпримеры (и даже просто – примеры), используя современные возможности по оптимизированному перебору текстов компьютерных доказательств.
[…]
То есть, это самое реальное применение для знаменитых “LLM с нейросетками” на ближайшее время, при котором они могли бы оказаться очень эффективными для математических исследований.
Ну, идея довольно очевидная, поэтому, кто бы сомневался, что именно так и вышло: на днях OpenAI опубликовали список из десяти достаточно известных математических проблем, к которым предложены решения или контрпримеры, найденные “методами ИИ”, с использованием Lean.
Интересно, что одна из решённых в OpenAI задач – прямо указана и в “Коуровской тетради”, но лишь в самой свежей, 21-й редакции (я проверил только для англоязычной версии, понятно). В публикации OpenAI – это третья глава с утверждением non-sofic groups exist и контрпримером – с построением такой группы. В англоязычной “Коуровской тетради” это задача 21.86. Да, там обратная формулировка: “всякая ли группа является софической (sofic)?”. Но это как раз то, что нужно для поиска контрпримера: покажите одну группу, которая non-sofic, и это даст ответ – нет, не всякая. (“Софической”, конечно, не лучший перевод – должно быть “терминальной” или “терминируемой”, но данный вариант уже занят.)
Но что особенно занятно, так это то, что решённая ИИ OpenAI задача 21.86 в тетрадь добавлена в этом же, 2026 году! Удивительное совпадение. Например, препринт на Arxiv с 21-м изданием, в котором появляется данная задача, датирован январём 2026 года (версия 39, кому интересно). Естественно, сама исходная гипотеза про “софичность” всех групп – сильно старше, она, примерно, 2000 года. Однако в более старых версиях “Коуровской тетради” она не указана, а, похоже, появляется только в 2026 году.
Комментировать »
Воскресное чтение манускриптов. Продолжение разбора задач из “Арифметики” Диофанта в версии манускрипта Vat.gr.191 (13 век, Ватиканская Апостольская библиотека).
Часть вторая. Первая часть заканчивается разбором формулировки первой задачи в конкретных числах: 100 == X + (X + 40). Если не читали первую часть, то имеет смысл прочитать, ну, перед тем, как приступать ко второй.
Вообще, первая и вторая части тут относятся к одной записке, из которой я решил сделать две, так как рубрика что-то очень редкая. При этом, данный манускрипт с “Арифметикой” (а там не только “Арифметика”, которая начинается с листа 360r) встречался на страницах dxdt уже несколько раз. И, возможно, ещё встретится (если доступы к онлайн-архиву останутся). Так что эта “вторая часть” – это локальная вторая часть, и она посвящена дальнейшему разбору записи первой задачи.
Заметьте, что фундаментальная особенность серии про чтение манускриптов – это именно записи, а не сами задачи (или другие объекты) в современном изложении. Дело в том, что современность изложения, как выясняется, подразумевает достаточно много изменений, в том числе, подразумевает уничтожение “странностей”, которые кому-то показались несущественными. Один из примеров – чертежи в “Началах” Евклида: оказывается, на доступных древних манускриптах с “Началами” отрезки на чертежах к теоретико-числовым Предложениям имеют одинаковую (или почти одинаковую) длину – но если взять современное изложение “Начал”, то там эти отрезки будут перерисованы с различными длинами, соответствующими различным подразумеваемым числовым значениям (больше число – длиннее отрезок).
Нередко анахронизмы, наведённые переносом современной терминологии в прошлое, вообще переворачивают ситуацию с ног на голову. Отличный пример – распространённое представление, что, якобы, Аристотель считал, что тяжёлые тела падают быстрее лёгких. Но в трудах Аристотеля речь вообще о другом процессе. Начать с того, что сама концепция “падения тела”, как её привычно воспринимают сейчас, отсутствует у Аристотеля в принципе: современная трактовка “падения” требует понятия о гравитации, о некотором “притяжении”, а у Аристотеля – тела, “падая”, не падают, в современном смысле, но движутся сквозь среду к их естественному месту в мире, а гравитации – нет. Это, впрочем, тема для другой записки. Тем более, что про эту максимально ошибочную интерпретацию подхода Аристотеля я упоминал ранее.
Анахронизмы – анахронизмами, конечно, но ведь даже доступные манускрипты – это далеко не исходные публикации, а переписанные спустя несколько веков ныне утраченные “исходники” (в кавычках – потому что непонятно, что за материалы использовались на самом деле). Так, рассматриваемый здесь манускрипт Vat.gr.191, согласно его датировке, почти на тысячу лет моложе, чем период, когда действовал сам Диофант. Но тут уж ничего не поделать.
Вернёмся, впрочем, к самой формулировке первой задачи. Ещё раз общий вид фрагмента с задачей со скриншота манускрипта.

В прошлый раз остановились в самом начале третьей строки и разобрали большую редакторскую правку, которая записана слева.

То есть, выбрали “неизвестную” и выяснили, что “вторая часть” – это будет “неизвестная” плюс сорок единиц или X + (X + 40) в современной нотации. Читаем следующий фрагмент.

Здесь (в современной типографике) написано: συναμφότεροι ἄρα γίνονται ἀριθμοὶ δύο μοναδες μ̅· δέδονται δὲ μονάδες ρ̅. Максимально близкий перевод: “Вместе, таким образом, выражают неизвестную дважды, единиц 40: даёт же [всего] единиц 100”. Здесь μ̅ и ρ̅ это числа 40 и 100, соответственно, но обозначены эти числа буквами (с чертой, overline).
Таким образом, из X + (X + 40) мы переходим к X*2 + 40. Здесь X*2 это и есть ἀριθμοὶ δύο – “арифмосы” “дважды” (δύο; вообще, это, пожалуй, максимально знакомое русскоязычному читателю древнегреческое слово: буквально, “два”, даже читается едва ли не более похоже, чем английский вариант того же слова – two; и можно было бы перевести как “дуо-арифмос”, но это, конечно, не совсем так). После “двух арифмосов” и “40 единиц” подчёркивается, что всего дано 100. То есть, сумма должна быть равна сотне единиц (μονάδες ρ̅).
Итак, добрались до X*2 + 40, и 100 – в сумме. Читаем дальше.

Написано: μονάδες ἄρα ρ̅ ἴσαι εἰσὶν ἀριθμοῖς δυσὶ μονάσι μ̅ . Дословный перевод: “единиц, таким образом, сто (100), равны неизвестным двум (и) единицам 40”. Или более естественно: “Таким образом, 100 равно двум неизвестным плюс 40”. То есть, здесь записано: 100 == X*2 + 40.
Задача полностью сформулирована в конкретных числах. Заметьте, что сделанно это с объяснением шагов и преобразований. То есть, что получаем сейчас, если современным языком: “Разность чисел 40, сумма 100; найти числа; запишем формулу X + (X + 40) == 100; следовательно, 2X + 40 == 100”. Совсем простая задача для начальной школы. Как я уже отметил, далеко не все задачи в “Арифметике” Диофанта столь же простые. Далее, на манускрипте, начинается решение. Смотрим.

В современной типографике: καὶ ἀπὸ ὁμοίων ὅμοια, ἀφαιρῶ ἀπὸ τῶν ρ̄ μονάδου μ̄. Перевод: “И из подобного подобное, вычитаю из 100 единиц 40”. К этому фрагменту встречается дополнение, которого нет в рассматриваемом манускрипте Vat.gr.191. В дополнении сказано, что 40 нужно вычитать и из части с удвоенной неизвестной. Скорее всего, у Диофанта достаточным объяснением является вводный фрагмент: “и из подобного подобное”. Этот фрагмент означает, что “единицы” (монады, μοναδες) вычитаются из “единиц”, а неизвестные (арифмос) – остаются. В современных обозначениях: (X*2 + 40) – 40 == 100 – 40.

Текст: λοιποὶ ἀριθμοὶ δύο ἴσοι μονάσιν ξ̄, ἕκαστος ἄρα γίνεσται ἀριθμὸς μονὰδων λ̄. Что дословно означает: “Остаток – неизвестных две равны единицам 60, каждая, таким образом, выходит неизвестная [в] единиц 30”. И здесь имеется в виду то, сколько именно единиц в каждой неизвестной “помещается”. На современном языке, первый шаг (левая часть, до 60): X*2 == 60. Число 60 – это буква кси с чертой (ξ̄). Следующий шаг: X == 60/2 == 30. Число 30 – это лямбда с чертой (λ̄)
Финальный фрагмент.

Это уже ответ. Написано: ἐπὶ τὰσ ὑποστάσεις· ἔσται ὁ μὲν ἐλάσσων μονάδων τριάκοντα. ὁ δὲ μείζων μονάδου ο̄. καὶ ἡ ἀπόδειξις φανερά. Перевод: “В действительности: стало же меньшее единиц тридцать, да большее единиц 70. И продемонстрированное очевидно”. “В действительности” (в “иопстаси”, потому что ὑποστάσεις) тут надо читать как “окончательный результат”, то есть, числа ответа: 30 и 70 (ο̄).
А заключительный типовой оборот – “καὶ ἡ ἀπόδειξις φανερά”, – это некий аналог “что и требовалось доказать”, но только в том смысле, что, благодаря продемонстрированному, стал очевидным полученный ответ.
Комментировать »
Воскресное чтение манускриптов. Продолжаем читать “Арифметику” Диофанта в версии манускрипта 13 века Vat.gr.191 (Ватиканская Апостольская библиотека).
Чтение манускриптов – далеко не самая частая рубрика, однако данный манускрипт уже встречался на страницах dxdt раньше – рассматривались способы записи степеней, отрицательные и положительные числа, обозначение неизвестной. Сегодня я добрался до формулировки и решения первой задачи, как они даны на манускрипте.
Вообще, некоторые задачи из Диофанта довольно заумные, но к первой это наблюдение не относится – она очень простая. Однако уже на примере первой задачи можно заметить, насколько современная нотация отличается от имевшейся в 13 веке, и, видимо, раньше. Понятно, что по манускрипту 13 века можно судить только о нотации до 13 века: да, Диофант Александрийский – это, предположительно, третий век н.э., почти за тысячу лет до момента создания данного манускрипта, но если бы в 13 веке была какая-то продвинутая нотация, относительно записи в оригинальном труде Диофанта, то неясно, почему её не использовали.
Впрочем, ситуация ниже разобрана довольно подробно, поэтому мы увидим и более странные вещи: древнегреческий текст вообще так записан, как если бы сотрудник скриптория просто копировал звучание слов на слух (но, считается, формулировки именно так были представлены в тех материалах, которыми пользовался переписчик – в частности, это подтверждают исправления на манускриптах; так что, похоже, “на слух” кто-то переписал раньше).
Занятно, что такой подход каким-то образом совсем не мешает использовать при написании манускриптов самые разнообразные скорописные сокращения. Как я неоднократно отмечал, читать данные тексты очень сложно, нужно специально разбираться именно с палеографией: то есть, даже если вы знаете древнегреческий в подходящем варианте, но использовали современную, привычную “транскрипцию” алфавита, то всё равно прочитать подобный манускрипт “прямо с листа” – не выйдет: слишком многие буквы совсем не узнаются, отличий тут даже побольше, чем, например, между кириллическими “печатным буквами” и русским рукописным курсивом.
Казалось бы, если текст всё равно доступен только подготовленному специалисту, – тем более, в 13 веке, – почему же тогда не разработать и не использовать какую-то схему обозначения для “формул”, алгебраическую нотацию? Но нет, даже для обозначения неизвестной здесь использовано полноценное слово – “арифмос” (ἀριθμός – хотя можно было использовать знак, напоминающий s, он уже был у Диофанта).
Итак, общий вид фрагмента с первой задачей:

Здесь слева присутствует пара “маргинальных комментариев”, а точнее – редакторские правки. Нас интересует вторая, и мы ещё до неё доберёмся.
Как обычно, цель этой длинной записки – разобраться детально в том, что же происходит “в исходниках”, так как “Арифметика” Диофанта имеет очень большую важность для истории математики, важность сравнима даже с “Началами” Евклида. Соответственно, я постараюсь все детали объяснить. Поэтому дальше я сперва транслирую древнегреческий текст в современную типографику, чтобы проще прочитать, ставлю скриншот манускрипта с тем же текстом (если хотите – можете самостоятельно побуквенно сопоставить), а следом привожу перевод на русский, как я этот текст понимаю, и подробные объяснения, что там к чему, в свете, так сказать, исторического положения дел.
Формулировка задачи начинается следующими странными словами: τὸν ἐπιταχθέντα ἀριθμὸν διελεῖν εἰς δύο ἀριθμοὺς ἐν ὑπεροχῇ τῇ δοθείσῃ.

Перевод максимально близко к тексту: “Заданное значение разбить на два значения, с превышением данным”. Под “превышением” (ὑπεροχῇ) тут имеется в виду разность двух чисел. А “разбить” или “разделить” – обозначает, что нужно представить в виде суммы. То есть, в современных обозначениях, если данное число это A, а разность – N, будет так: A == X + (X + N). Здесь используется слово “арифмос”, иногда оно означает “число” просто, иногда – неизвестную (переменную) или “значение”, как “количество единиц”, особенно, в случае текстов Диофанта. Я будут почти везде использовать либо слово “значение”, либо слово “неизвестная”. Смысл тут в том, что “арифмос”, очень часто, соответствует привычному “иксу” (X).
Следующий фрагмент: ἔστω δὴ ὁ δοθεὶς ἀριθμὸς ὁ ρ̅, ἡ δὲ ὑπεροχὴ μονάδες τεσσαράκοντα. εὑρεῖν τοὺς ἀριθμούς.

Перевод: “Пусть же данно значение 100 (ρ̅ в греческих обозначениях чисел), да превышение – сорок единиц. Найти эти значения”. Здесь выбирается конкретный пример “в числах” для задачи. “Сорок” – записано словом (τεσσαράκοντα), как количество единиц. Эти “единицы” – это то, что называется “монады”. Вообще, для “монад” у Диофанта есть специальное обозначение – Μ “с блобом”, который, на самом деле, буква омикрон Ο: M̊. Но данный манускрипт здесь почти всегда использует запись словом – μονάς/μονάδες.
Тут начались числа, поэтому сразу нужна “шрифтовая” оговорка – обратите внимание на букву ρ (“ро”): это не совсем буква, это обозначение числа 100; древнегреческий способ записи чисел буквами требует указания горизонтальной черты над буквой (overline), но шрифты и Unicode не всегда с этим справляются. Тем не менее, чтобы не переходить на LaTeX, который рендерится в картинки, я тут и далее попробую указывать соответствующий unicode-символ: U+0305, вот так: ρ̅ – надеюсь, отображается нормально. А если нет, не нормально, то буква, скорее всего, будет отображена рядом с чертой: так что те буквы, для которых “черта рядом” – это числа.
Итак, в этом предложении записано, что пусть A == 100, а N == 40, надо найти X в X + (X + 40) == 100. Конкретные условия задачи.
Следущий фрагмент довольно сложный: τετάχθω ὁ ἐλάσσων ἀριθμοῦ ἑνὸς· [μονάδ(ων) ̄μ] ὁ ἄρα μείζων ἔσται ἀριθμοῦ α̅ μονάδων μ̅ .
Обратите внимание, что тут зачёркнута часть предложения. Мы добрались до важной правки. Часть предложения зачёркнута и на манускрипте (см. скриншот). К зачёркнутому – поставлена ссылка (знак, похожий на полумесяц), которая ведёт на редакторский комментарий – он записан слева. Это исправление пропущенного переписчиком фрагмента, но выполненное постфактум. То есть, тут в конце строки основного текста (справа на скриншоте) было записано окончание следующего фрагмента, который тоже на μ заканчивается: переписчик поторопился и перепрыгнул, пропустил кусок; такое случается довольно часто. Получилось, что пропущено несколько слов, но зато записано “сорок монад”, а это относится к другой части текста; недостающие слова как раз добавлены в редакторской правке, а исходная ошибка – вычеркнута. В других манускриптах этот фаргмент присутствует прямо в основном тексте. Я так же добавил текст правки в основную строку (см. выше).
Дословный перевод, с учётом правки: “Задали меньшее значение “единично”, тогда большее есть (это же) число “единожды” [плюс] сорок единиц”. Обратите внимание, что я тут развернул “монады” в слово, но исходный текст правки – на поле слева – содержит M̊. Итак, тут сказано: положим, что меньшее число есть X, тогда большее будет X + 40. Но вот только вместо “икса” используется “значение” (“арифмос”), взятое один раз – буквально: ἀριθμοῦ ἑνὸς – “арифмос” “единожды”. А прибавление 40 единиц – записано просто, “сорок единиц”, и “плюс” ничем не обозначен.
Что могло бы означать “значение, взятое единожды”? Оно означает, что это X*1 (справа!). То есть, хоть и справа, но это просто коэффициент при X – единица. В принципе, в исходной нотации могло бы быть записано как s и “альфа” – коэффициент единица при “неизвестной”. Буквально в том же предложении, но ближе к концу, используется почти что такое обозначение: α̅ – альфа с чертой, число обозначено буквой, а не записано словом: “1” против “единица”. Однако в основном тексте в этом манускрипте подобные обороты нередко записаны словами.
Это всё очень похоже на то, как, взяв выражение в современной нотации “1*x + 40”, записать это же выражение, но “со слов”: “один икс и сорок единиц”. Причём союз “и” тут пропускается (было бы καί): “один икс сорок единиц”. Почему так происходило в скриптории? Не очень понятно. Может быть, кто-то когда-то действительно продиктовал предложение в математической нотации, а сотрудники скриптория записали буквально словами.
Комментировать »
Кстати, в продолжение теоретико-числовых аспектов “Начал” Евклида. Смотрю тут книгу Бориса Трушина для школьников по теории чисел – “Теория чисел: с нуля до теоремы Эйлера”. На странице 66 там, под названием “Теорема Евклида”, приводится утверждение о том, что “простых чисел бесконечно много”, и доказательство – от противного: примем, что простых – конечное количество, перемножим их все, прибавим единицу, заметим, что результат не делится ни на одно из простых, – противоречие. Это типовое доказательство, которое встречается во многих учебниках. Почему приводят именно его – не очень понятно, но такова традиция. Однако, заметьте, в книге Трушина доказательство не названо “доказательством Евклида”. И это правильно. Почему? Потому, что Евклид-то доказывал данное утверждение не так. Евклид доказывал несколько более конструктивно.
Собственно, даже исходное предложение Евклида (9.20) сформулировано иначе: “простых чисел больше, чем в любом заданном (конечном) наборе простых чисел”. Может показаться, что это такая же формулировка, как и про “бесконечно много”, но, логически, это не так – Евклид не постулирует тут никакой бесконечности “от противного”, не рассматривает “все простые”, а использует конструктивный подход: даёте конкретный список простых чисел, и вот метод, по которому можно построить такое простое, которого не будет в этом списке. И доказательство у Евклида не от противного. Оно, что называется, более “конструктивное” (в той же мере, что и формулировка).
Логика исходного доказательства Евклида: выберем любые три простых числа A, B, C; возьмём наименьшее D, которое делится на A, B и C; прибавим к D единицу, получив число N = D + 1. (Обратите внимание, что единица здесь – это единица в евклидовом смысле, то есть, неделимый элемент.) Полученное число N либо является простым, которое не вошло в исходный список (утверждение, в этом случае, доказано), либо N – составное, и тогда N делится на какое-то простое (обратите внимание на этот момент – к нему ещё вернёмся ниже). Обозначим простое число, на которое делится N, буквой M. Если M – число из исходного списка [A, B, C], то M делит и D (по построению D). Следовательно, раз M делит и N, и D, то оно делит и разность N – D, но эта разность есть единица, и M не может её делить. Следовательно, M не входит в исходный список [A, B, C] – мы нашли новое простое число. То есть, тут показан достаточно конкретный способ конструирования нужных чисел, и это совсем другая история, чем постулирование “актуальной” бесконечности. Тем не менее, в учебниках регулярно приводят именно “доказательство от противного”, хоть оно и не является доказательством Евклида.
В доказательстве “от противного” фигурирует произведение всех простых. Если забыть, что это произведение всех простых, то нетрудно сделать ошибочный вывод, что можно всегда получить простое число, перемножив несколько последовательных простых и прибавив единицу. Это неприятный момент неверного обобщения результата, который полностью отсутствует в исходном доказательстве Евклида (см. выше). То есть, например, 2*3*5*7*11 + 1 = 2311 (простое), но это не означает, что просты и все такие числа (которые называют числами Евклида). Надо сказать, что в книге Трушина, как раз, сразу же, после доказательства теоремы Евклида этот, – наверное, самый важный, – момент подробно рассмотрен и показано, что уже 2*3*5*7*11*13 + 1 = 30031 = 59 * 509.
Книгу Трушина, кстати, порекомендую (и далеко не только школьникам). Там, конечно, есть несколько наивный небольшой раздел про применение теории чисел в криптографии, написанный, почему-то, на примере RSA, для которой проводится странное “сращивание” с шифрами простой замены. Это при том, что, конечно, RSA возникла из совсем другой задачи – из задачи распределения ключей, – а не из задачи зашифрования информации: для зашифрования были известны и абсолютно стойкий симметричный шифр, и симметричные же “комбинаторные” шифры, обладающие высокой стойкостью; более того, и наивный “побуквенный” шифр замены можно сделать очень стойким, пусть и простым в применении (возьмите колоду карт, скажем, и книгу). Но это всё специальные детали, которые я не смог пропустить в силу тематики dxdt.blog. И, конечно, к данному разделу в книге поставлена сноска, в которой прямо указано, что реальное применение RSA – сложнее, и совсем не такое, как описано. Так что, на содержательную часть – не влияет.
Комментировать »
Небольшое воскресное чтение манускриптов. Точнее – рассматривание чертежа из “Начал” Евклида, в версии манускрипта Vat.gr 190 девятого века. Это чертёж к Предложению 20 девятой книги, то есть, к доказательству того, что количество простых чисел больше, чем их есть в любом наперёд заданном (конечном) списке.

На чертеже почти все величины, используемые в доказательстве Предложения, обозначены отрезками одинаковой длины. Это довольно странно, а отчасти – загадочно, но именно так на старых манускриптах даны почти все чертежи для теоретико-числовых Предложений из “Начал”.
Другими словами, в доказательстве здесь используется три различных простых числа – ΑΒΓ, – это натуральные числа, но на рисунке их величины обозначены отрезками одинаковой длины. Причём, в более или менее современных переводах – отрезки на чертеже уже будут разными: очевидно, что трём разным натуральным числам не могут соответствовать отрезки одинаковой длины; ну, если только не считать эти отрезки совсем абстрактным представлением – тогда, конечно, длина на чертеже не важна: не рисуют же прямые углы, скажем, как строго прямые (вообще невозможно нарисовать прямой угол).
ΕΔ здесь – это отрезок, измеримый Α, Β и Γ, то есть, если на современный лад, произведение ΑΒΓ, а ΔΖ – единица (в евклидовом смысле), которая добавляется к ΕΔ, что даёт ΕΖ. Ну а Η – это отрезок, обозначающий простое число, которое измеряет ΕΖ (делит). И опять – одинаковой длины с ΕΔ.
Комментировать »
Открытый серверный ключ TLS, который указан в TLS-сертификате, на dxdt.blog начинается с подстроки DEADC0DE (в шестнадцатеричной записи, см. скриншот ниже).

Да, тут присутствует ещё и байт со значением 04 в самом начале, но он не имеет отношения непосредственно к ключу – это лишь указание на формат представления. 04 обозначает несжатую форму записи, когда прямо указываются две координаты точки ключа. Поэтому 04 можно отбросить. Такое значение ключа я использовал специально (это то, что называется vanity keys).
Как это значение получено? Оно получено перебором, конечно. Это не очень сложно сделать. Открытый ключ ECDSA – это точка на кривой. Точке соответствуют две координаты, одна из них (обычно, обозначают X), записывается слева. Поэтому в начале записи ключа будут идти старшие байты X-координаты. Остаётся подобрать такой секретный ключ, который даст открытый с нужной X-координатой. Секретный ключ – это натуральное число, больше двух и меньше порядка группы точек кривой (обычно, меньше тоже на два, но это детали). Нужно перебирать секретные ключи и проверять значение начальных байтов X-координаты открытого на соответствие заданной маске.
Открытый ключ – это точка-генератор G из параметров кривой, умноженная на значение секретного ключа d: [d]G. Я, используя готовую библиотеку из дистрибутива языка Go, написал быструю программу умножения на P-256 (кривая, которая используется здесь в ECDSA). Программа перебирает секретные ключи и делает это параллельно, во много потоков. Соответственно, даже на старом 16-потоковом процессоре AMD Ryzen 7, подбор ключа занял всего несколько часов. В результате подбора я получил нужный секретный ключ, который экспортировал для генерирования CSR (запрос на выпуск сертификата) и штатным способом использую при заказе TLS-сертификатов.
Вообще, для P-256 можно придумать немало открытых ключей, запись которых, в X-координате, выглядит ещё более необычно. Например:
0xAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAABBBBBBBBA
- цифры A и немного B,
0x1000000000000000000000000000000000000000000000000000000000000001
- единицы и нули,
0x5000000000000000000000000000000000000000000000000000000000055555
- пятёрки и нули,
0x7777777777777777777777777777777177777777777777777777777777777777
- семёрки с "неожиданной" единицей,
0x8888888888888888888888888888881888888888888888888888888888888888
- восьмёрки, но тоже с единицей.
Точки с такими X-координатами лежат на кривой P-256. Определить для них Y-координату – не представляет вычислительной проблемы. Более того, ввиду свойств данной кривой – все эти точки, действительно, являются открытыми ключами. Тут есть лишь одна проблема: по открытому ключу очень сложно, а на практике – невозможно, вычислить секретный ключ; потому что это и есть основная задача, обеспечивающая стойкость ECDSA. Конечно, подходящий секретный ключ можно угадать. В том числе, в результате перебора. Вот только перебрать даже половину от, примерно, 2^256 – нереально. Ну и записать подходящий секретный ключ просто по наитию, как поступил бы борелевский шаман, пока что тоже не вышло. Так что придётся, до поры до времени, обойтись без забавных записей, ограничившись hexspeak-вариантом с DEADC0DE. Но как только и если появится квантовый компьютер подходящей разрядности, тогда можно будет секретные ключи подобрать очень быстро.
Комментарии (2) »
Для интересующихся английским языком и математикой (при чём тут математика – будет понятно ниже): на сайте The Guardian весьма занимательная задача – нужно прочитать известные идиомы и крылатые фразы на английском, но записаны эти фразы и идиомы в виде наборов цветных прямоугольников, где размеры прямоугольника соответствуют начертанию буквы, а цвета – разные для гласных и согласных (зелёный – гласные). Например, вот так, как на картинке ниже (взято из исходной статьи).

Предложения местами сложные, однако некоторые – угадываются довольно быстро (например, первая фраза). Мне удалось прочитать все 10 (надеюсь, что правильно – ответов, на момент публикации этой записки, ещё нет), так что механизм точно работает, попробуйте.
Там есть цитаты из Шекспира, да и сами исходные тексты, конечно, характерны, так сказать, для британского “литературного бэкграунда”, но это очень интересно, поскольку на конкретном примере показывает, насколько важна графическая форма слова в записи и графические же отношения между словами – а это уже чисто математический аспект.
Казалось бы, это идеальная задача для ИИ/LLM. Современная ИИ/LLM, которая, якобы, на “уровне золотой медали Международной математической олимпиады”, должна легко такую задачу решить. Ведь эти системы “обучены” на огромном корпусе текстов, в котором упомянутые фразеологизмы встречаются постоянно (ну, как бы, “Весь мир – театр” и “Не всё то золото, что блестит” – куда же чаще?). Я, конечно, загрузил текст и картинку с задачкой в ChatGPT современной версии. Откровенно говоря, я, при всём моём скептическом отношении, думал, что хотя бы с парой фраз система справится. ChatGPT не угадало ни одной фразы. Так что задача даже лучше, чем можно подумать.
Комментарии (6) »
Воскресное чтение манускриптов. Продолжаем несколько беспорядочное чтение предисловия из “Арифметики” Диофанта. В версии манускрипта 13 века Vat.gr.191 из Ватиканской Апостольской библиотеки. В прошлый раз – изучали фрагмент про “минус на минус” и обозначение “отрицательных” величин. В этот раз – вернёмся немного назад и прочитаем про два других обозначения: про “число”, как “Число” и про “монаду” (почти как в языке Haskell).
Мы раньше уже встречались с обозначением степеней (неизвестной) у Диофанта, и там был “кубо-кубос” (κυβόκυβος – ΚΥΚ ) для шестой степени – то есть, “куб плюс куб”. Там же был и квадрат – “дунамис” (“динамис”). Случай, когда никакой степени при неизвестной нет, – это, в современных обозначениях, просто x, – Диофант описывает отдельно.

В манускрипте написано: “Не получившее никакого названия [степени], но содержащее в себе неопределённое количество единиц, Числом (ἀριθμός) назовём, и пусть его обозначение – ς”.
Однако обозначение ς, “сигма” тут – весьма условное: знак только похож на сигму, но это точно не сигма. Так, на данном манускрипте вообще-то используется некий S-образный знак с волной и кружочком, он в середине скриншота, а увеличенный фрагмент – дан ниже.

В разных источниках этот знак переменной тоже разный. Кроме “похожего на сигму”, как здесь, встречаются: Ч-подобный знак, разные “волны с точками и кружками”, иногда иные варианты (дзета и т.д.). Очень загадочный знак. Непонятно, откуда он взялся, если не из сокращения слова ἀριθμός, тем более, что такая логика хорошо укладывается в схему именования других объектов Диофантом, как “кубусы” с каппой и т.д. (см. например, T. L. Heath. Diophantus of Alexandria).
Да и на рассматриваемом здесь манускрипте Vat.gr.191 нетрудно заметить, что вместо этого странного значка, далее по тексту, часто используется как раз скорописное сокращение для слова ἀριθμός. Так что, вполне возможно, что обозначение неизвестной в первой степени и у исходного Диофанта – это ни “сигма”, ни ещё какая-то буква, а специальный знак для слова “арифмос” (откуда, понятно, происходит “арифметика”).
Теперь к монадам. Вторая часть выделенного на скриншоте текста (после странного “сигма-знака” для “арифмоса”) – это описание и название для свободного коэффициента. То есть, для константы, которая входит в уравнение, соотвествующее той или иной задаче. Константы нужно отличать от переменных: “Другой знак для неизменяемого и определённого количества единиц будет “Μ”, несущая “Ο” сверху: M̊” – написано у Диофанта. Диофант задаёт при помощи этого обозначение контекст вычислений. Не сомневайтесь – тут прямо противопоставлены “переменные” и “константы”, в соседних предложениях. Это “мю” (Μ) в обозначении свободного коэффициента – первая буква слова μονάς – “монас”/”монада”. Монада используется у Диофанта именно в смысле выделенного инструмента, позволяющего понятийно отделить место для числа, от самого числа, при преобразованиях. Если вы подумали, что монадой, по принципу использования, тут является “арифмос”, как переменная, то это не так – у Диофанта понятия вводятся из соображений выделения отличий между преобразованиями. Поэтому и степени переменной обозначаются разными именами: “динамис”, “дианамо-динамис”, “кубо-кубос”, а не как принято сейчас – коэффициентом при обозначении неизвестной. Поэтому монада тут нужна именно для фиксирования преобразования. Ну, то есть, сейчас бы, на техничном языке, сказали бы, что это “функториальный инструмент”. Почти что как монада, используемая для обёртывания, например, операций ввода в Haskell. Да и название совпадает, что, конечно, естественно: сам термин “монада” – образован от древнегреческого слова.
Некоторое время назад мы уже находили на манускриптах древние знаки “дипле”, которые сейчас используются с той же целью – для обозначения цитируемого фрагмента текста в сообщении электронной почты, например. В этот раз – в тексте Диофанта используется монада, причём, в том же понятийном ключе, как и в современном языке программирования Haskell, но не только там.
Комментировать »
 Новый
