Ресурсы: техническое описание TLS, LaTeX - в картинки (img), криптографическая библиотека Arduino, шифр "Кузнечик" на ассемблере AMD64/AVX и ARM64
Почему-то свежую (относительно) уязвимость в ядре FreeBSD (CVE-2026-101302), которая требует TLS 1.3 и находится в функциях KTLS (то есть, “выгрузки” обработки TLS-данных на сторону ядра), во внешних описаниях регулярно называют “сетевой уязвимостью”, просто позволяющей “обвалить ядро FreeBSD при помощи специального сетевого пакета, отправленного по TCP”. Это не совсем верно, и тут требуется небольшое поясение. Как сейчас модно говорить: “важен контекст”. И здесь “контекст” – в самом техническом смысле, а именно – TLS-контекст в ядре.
Данная уязвимость касается обработки именно TLS-записей в версии TLS 1.3, да ещё и после аутентификации и расшифрования полезной нагрузки. Другими словами, чтобы “проэксплуатировать” ветку кода с ошибкой (а там некорректная расчётная длина дополнения), атакующему требуется установленный в ядре TLS-контекст соединения и общие с атакуемым TLS-стеком секретные ключи. То есть, успешная атака требует, чтобы прошла аутентификация принятой TLS-записи. В TLS 1.3 здесь сначала проверяется целостность, а только потом данные расшифровываются.
Таким образом, штатная схема подразумевает, что стороны установили соединение и получили общий секрет, а потом можно отправлять “панические пакеты”. Просто так “налить панических пакетов” – не получится. Но это штатная схема. Естественно, для успешной атаки требуется подходящий TLS-контекст в атакуемом ядре, а не сам процесс установления соединения. Это понятно, забывать про это нельзя тоже. Да, подходящий TLS-контекст в ядре может быть установлен со стороны приложения без фактического выполнения полноценного TLS-соединения и отправки пакетов вообще, и вот тогда, да, специальный пакет с подходящей TLS-записью уже вызовет “панику” ядра. Что, конечно, тоже немало.
Комментировать »
Давно и неоднократно писал о том, что при спуфинге спутникового навигационного сигнала может, – отчасти, – помочь аутентификация сигнала. И вот, как пишут, такую систему аутентификации постепенно внедряют в гражданский сигнал GNSS Galileo. Возможно, что уже в ближайшие год-два заработает.
Строго говоря, базовая аутентификация там уже есть (называется OSNMA), но она не позволяет проверить сам подлежащий навигационный код. И вот именно эту дополнительную проверку обещают ввести. Вообще, смысл затеи базируется на двух элементах: первый элемент – нужно дать приёмнику криптографический механизм проверки подлинности принимаемого опорного сигнала; второй элемент – нужно, чтобы этот механизм охватывал и содержательную часть, то есть, сам код, по которому вычисляется разность времени (или расстояние до спутника, что то же самое). Реализация второго элемента добавляет сложности.
Естественно, если навигационный сигнал подписан, а приёмник может проверить подписи и аутентифицировать принятый код, это вовсе не означает, что подписано (аутентифицировано) и вычисленное положение приёмника. То есть, даже при наличии принимаемого подлинного сигнала, нет полной гарантии, что этот сигнал соответствует положению приёмника. Но криптографическая защита тут очень сильно увеличивает устойчивость: например, появляется более строгая привязка ко времени, которая может позволить отличить ретранслируемый сигнал, исходник которого записан в другой точке координатного пространства. Так как предсказать защищённый сигнал, не зная секретных ключей, практически невозможно, то спуфинговая система должна где-то записывать реальный, подлинный сигнал и ретранслировать его.
В идеале, конечно, удостоверяться должны сами координаты, вычисленные “на приёмнике”, но для этого, к сожалению, протребуется активная система с двухсторонней связью. То есть, вычисленные координаты нужно передавать обратно на проверяющий спутник, который сможет подтвердить их верность. Такое возможно в системах типа Starlink.
Ну и понятно, конечно, что ни определение подлинности источника, ни определение подлинности сигнала вычисленных координат, не добавляют какой-то волшебной устойчивости в случае, если сигнал просто не принимается. Но вот понять, что принимаемый сигнал – подлинный, а не “подспуфлен” с опережением, – приёмник сможет.
Комментировать »
Всегда удивляет, когда оценивают доступ к некоторому ресурсу по HTTP(S) – как доступ “только на чтение” (или “только на запись”). Речь про HTTP-клиента, который что-то загружает с “целевого” сервера. Удивительно, насколько сильно представление о “передаче данных” может абстрагироваться от реальных протоколов. Тот же HTTP – очень сложный протокол (и это даже без указания HTTP/2, HTTP/3), и там не бывает “только чтения”/”только записи”. Причём, в обе стороны. А ведь для того, чтобы получился HTTP, нужно ещё несколько слоёв пройти. И везде – сессии. А сессия – исключает “только чтение” или “только запись”.
Рассмотрим HTTPS-соединение в некоторых деталях. С этим соединением связан базовый набор транспортов. Он слоистый. У нас, – в этом примере, – HTTP работает через TLS, который работает через TCP.
Идём привычным образом справа налево. TCP – здесь есть установление соединения с подтверждением, это не “только чтение”, да ещё и каждый этап несёт потенциальные проблемы: отправка начального пакета клиентом (SYN) может вызвать проблемы в реализации TCP-стека на сервере (но, хотя бы, тут воздействие одностороннее, в привычном направлении: клиент что-то отправил на сервер – сервер сломался); первичный ответ сервера (SYN-ACK) – может привести уже к проблемам на клиенте, и это получается воздействие в обратном направлении, когда клиент пытался подключиться, но получил проблему в ответ; подтверждение от клиента (ACK) – опять отправляет что-то на сервер, но уже в привязке к состоянию сервера, то есть, увеличивается поверхность атаки (но направление – опять привычное, от клиента к серверу).
Да, TCP-стеки обычно довольно устойчивые. Но не всегда. Главное, уже на уровне TCP клиент не просто что-то отправляет на сервер, но и получает, так что не возможны ни схема “только чтение”, ни схема “только запись”. Обе стороны пишут/читают. Обе стороны обрабатывают внешние данные, присланные другой стороной. Обе стороны вынуждены работать в некотором контексте: клиент, когда получает SYN-ACK; сервер – когда получает ACK. И это ещё только на этапе установления соединения. Но в TCP есть ещё кадры, флаги, потеря пакетов и повторная отправка. И, заметьте, дело не дошло даже до начала TLS-сессии.
Если с TCP всё прошоло успешно, то TLS – следующий шаг. Опять есть процесс установления соединения. Клиент отправляет на сервер сложное сообщение (ClientHello и расширения), которое приводит к вызову криптографических библиотек на сервере; сервер отвечает ещё более сложным сообщением (ServerHello и расширения), обработка которого потребует сохранения состояния на стороне клиента. А ведь сообщения TLS разбиты по так называемым записям, которые тоже нужно корректно “распарсить”. То есть, сервер, справившись с TCP, начинает читать сложные структуры ClientHello, собрав их по TLS-записям. А клиент должен проделать то же самое, но со специально подготовленными внешними данным в контексте открываемой TLS-сессии. И опять неважно, что это клиент “что-то отправляет”: нет, чтобы что-то отправить, клиенту придётся обработать хитрое ServerHello, собрав его по записям и успешно “распарсив” структуры, которые могут логически указывать друг на друга, имеют отдельные вложенные заголовки и так далее. Тут уже немало возможностей сломать “отправляющий HTTP-запрос” клиент ещё до того, как HTTP даже начнёт работать и у клиента возникнет шанс на отправку HTTP-запроса.
И только если с TLS всё прошло успешно, появляется возможность отправлять HTTP-запросы и читать ответы. Естественно, внутри HTTP всё тоже не так уж просто: здесь есть редиректы, есть поля, задающие длину внешнего сообщения, при том что значения этих полей – тоже внешние данные, есть статусы, имена и заголовки. Тут тоже нет ни “только чтения”, ни “только записи”. Клиент, отправивший запрос, получит произвольный ответ и должен корректно “распарсить” его формат. А сервер, получив запрос, должен суметь не сломаться, если запрос имеет неожиданный формат. Но, хотя бы, это уже HTTP, с которого всё начиналось.
Комментировать »
Немного про развитие LLM. ChatGPT 6 Pro успешно разгадывает несложные узлы по картинке, причём не строгие схемы, а произвольно нарисованные “верёвки”. На мой взгляд, это заметное достижение. Вот посмотрите пример ниже – исходная картинка с узлами и скриншот с верной разгадкой, полученной без всякой предварительной подготовки.
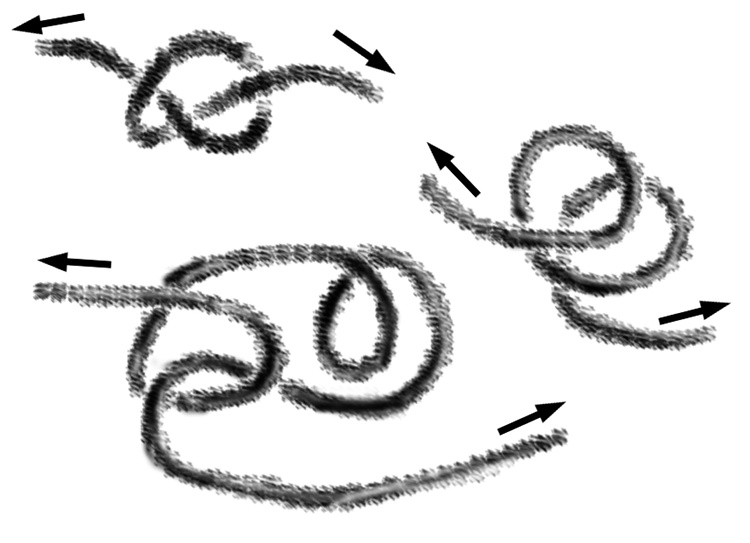
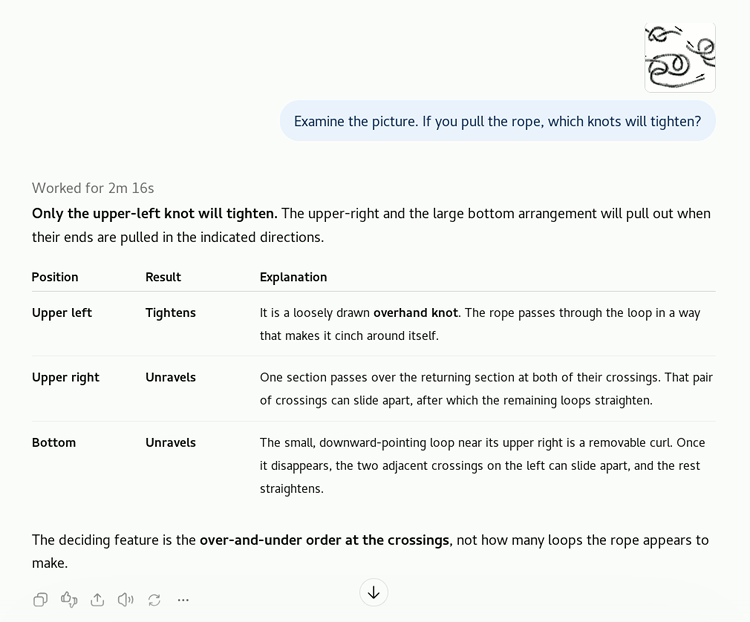
Тут не просто верный ответ, – only the upper-left knot will tighten (“только верхний левый узел затянется”), – но и детальное объяснение для каждого случая. Да, это максимальная из доступных публично LLM – GPT-6 Pro (причём, согласно описанию OpenAI, несмотря на название, GPT-6 Pro – это именно другая модель, а не “долгий” вариант “обычной” GPT-6), более двух минут обработки, но всё равно – показательно.
Комментарии (1) »
Пробное расшифрование – это хоть и вычислительно затратный, но типовой метод обнаружения подлинных попыток соединения на скрытом сервисе. При этом, если сервис правильно спроектирован, то и вычислительные затраты можно свести к весьма разумному уровню – процессоры сейчас мощные, тот же шифр AES – практически всегда на серверной стороне доступен в аппаратной реализации.
Основной принцип пробного расширования следующий: на сервер приходит внешний пакет, который может содержать данные для начального соединения от подлинного клиента – то есть, такое клиентское приветствие, позволяющее установить сетевое соединение и туннель, полностью зашифрованный. Сервер отвечает только на подлинные приветствия, а в ответ на поддельные – молчит. Здесь предполагается, что клиент и сервер уже знают общие симметричные секреты: обычно, это секретные ключи, настроенные в конфигурации и сервера, и клиента.
Содержание начального пакета данных должно быть вычислительно неотличимо от случайных данных (от шума) для внешнего наблюдателя. Это как раз и достигается тем, что данные зашифрованы. Но зашифрованы должны быть буквально все данные. То есть, тут не может быть некоторой структуры приветствия, как, например, в TLS: если пакет содержит некоторые заданные спецификацией поля (версию, идентификатор, таймстемп и пр.), то пассивный наблюдатель легко узнает протокол, к которому такой пакет относится. Поэтому видимой структуры быть не должно, но она может быть скрыта в зашифрованном блоке. (Тут еще есть транспортный аспект, типа TCP, об этом отдельно рассказано ниже.)
Но если пакет выглядит как шум, то что делать серверу? Тут как раз и начинается пробное расшифрование. Сервер пытается расшифровать полученные данные всеми известными ему клиентскими симметричными ключами. Внутри зашифрованного блока данных, – то есть, в открытом тексте, – уже содержится структура, которая и позволяет серверу понять, что расшифровано правильно – то есть, ключ найден верный. Это довольно хорошо отработанный подход, поэтому есть типовое решение: начальная часть открытого текста должна содержать достаточно длинный идентификатор клиента (например, 128 бит), этот же идентификатор сохраняется в таблице на стороне сервера, вместе с соотвествующими секретными ключами. Сервер перебирает эти ключи, расшифровывая пакет каждым.
Как только сервер, в результате расшифрования, получил идентификатор, совпавший с данными в таблице – сервер считает, что это начальное сообщение именно от того клиента, который указан в таблице. Это пока что предварительное решение, по схеме “в лоб”. С сетевой точки зрения, у данного решения есть сразу несколько больших недостатков, прежде всего – повторная отправка записанных пакетов. Мы недостатки сейчас рассмотрим и исправим. Но прежде всего важно заметить, что найден способ определить, что это за клиент стучится, приняв пакет, содержание которого выглядит для третьей стороны как поток байтов со случайными значениями.
Вероятность, что какой-то подставной пакет расшифруется так, что совпадёт и ключ, и идентификатор – настолько мала, что её можно не рассматривать. Тем более, что если так получится, то, для добротного шифра, это будет означать, что подставной клиент угадал ключ. Если же после всех вариантов расшифрования идентификатор клиента не найден, сервер отбрасывает пакет и не отвечает ничего. Да, обработка каждого входящего пакета требует выполнения многих операций расшифрования на сервере. Это неустранимая особенность: серверу придётся проверить данные по каждому клиенту. Если клиентов тысячи, то “невалидный” пакет сервер будет расшифровывать тысячи раз. Но, как отмечено выше, шифр AES нынче быстрый, а отправка наружу ответа о том, что пакет неверный – не требуется.
Теперь о других недостатках. Прежде всего, наивная схема зашифрования означает, что один и тот же клиент будет присылать одинаковый начальный пакет, потому что у клиента зафиксированы и значение ключа, и содержание пакета-приветствия. Это очень плохо, но легко исправляется, да ещё и сразу несколькими способами: например, в начало пакета в открытом виде записывается случайный вектор инициализации, который сервер использует при расшифровании (а клиент – при зашифровании). Этот вектор имеет фиксированную длину, но, поскольку значение вектора инициализации случайное, это не даёт никакой дополнительной различительной информации: к случайным данным прицепили случайные данные. Естественно, можно дописать изменяемый счётчик или слйчайный вектор внутри зашифрованных данных (см. ниже про таймстемп).
Следующий момент: если пакет имеет фиксированную длину, то при пассивном анализе можно зацепиться за эту длину. Решается тоже просто: к данным дописывается некий хвост-дополнение из случайных байтов, длина которого варьируется. Тогда у пакета образуется минимальная допустимая длина (поскольку должны войти данные приветствия), а практическая длина – изменяется от пакета к пакету. (Тут есть тонкий момент с контролем длины дополнения и дуплексным режимом для успешного соединения: дополнение нужно отбрасывать корректно, потому что иначе оно может попасть в начало следующего клиентского пакета. Но, опять же, оставим этот момент за пределами записки.)
Сервер знает длину полей в расшифрованных данных, знает, что поля идут одно за другим, может знать длину дополнения, поэтому просто отбрасывает это дополнение (где, после расшифрования, образуется некий мусор). Это всё самые простые способы, без аутентификации данных. Раз нет аутентификации, то кто-то может взять валидный пакет и дописать к нему что угодно в качестве дополнения, сделав некоторую метку. Сервер это “что угодно” вынужден будет расшифровать и если прочие данные сойдутся к валидным, то пакет будет принят в качестве приветствия. Это, на самом деле, не такая большая проблема: подобное тегирование мало что даёт, потому что для эффективного использования потребуется повторная отправка пакетов. И, опять же, есть несложное решение: используем код аутентификации сообщения, построенный на другом секретном ключе, а значение кода аутентификации дописываем в пакет. Сам код аутентификации тоже вычислительно неотличим от случайного (у нас случайный вектор инициализации), поэтому новых меток в пакете не появляется. Если аутентификация не сошлась для всех ключей, то пакет отбрасывается без дальнейшей обработки. В общем, это дополнительный затратный шаг на стороне сервера, который, в принципе, не требуется (внутри должна быть отдельная аутентификация – это другой аспект, там требуются асимметричные криптосистемы).
Только что была упомянута проблема повторной отправки валидных записанных приветствий. Третья сторона записывает трафик, выделяет валидные приветствия (это те, на которые сервер отправил ответ), а потом проигрывает эти приветствия в сторону сервера. В наивной схеме, действительно, такое сработает: сервер ответит. Однако, так как третья сторона не знает секретов, то она даже не сможет расшифровать ответ сервера. Впрочем, повторное проигрывание пакетов даёт некоторые новые направления для атак: во-первых, можно устроить зонд (connection probe), выявляющий действующие серверы – отправляем валидный пакет-приветствие на IP-адрес, если есть ответ, то там есть работающий по данному протоколу сервер; во-вторых, так как сервер вынужден на своей стороне открыть сессию, можно исчерпать доступные сессии на сервере; в-третьих, повторная отправка чужого приветствия может приводить к тому, что будет разорвано легитимное соединение того же клиента – а это уже неприятно, поскольку позволяет просто блокировать возможность использования протокола: фиксируем успешный обмен по ответу сервера – тут же отправляем ранее записанный пакет-приветствие в сторону сервера (это вообще один из хитрых моментов, который, впрочем, за пределами данной записки, посвящённой пробному расшифрованию).
Как бороться с вмешательством, котрое реализуется повторной отправкой начальных пакетов? К сожалению, эффективное противодействие – потребует некоторых дополнительных ресурсов: нужно на сервере вести таблицу состояний, – некий буфер, если точнее, – и отбрасывать все повторные пакеты по их значению (можно брать только начальные байты). А внутрь пакета-приветствия, в зашифрованную часть, нужно встроить таймстемп, и потребовать синхронного времени на клиенте и сервере. Тогда сервер ведёт запись о поступлении и успешной обработке недавних приветствий, прямые быстрые повторы – сразу отбрасывает (игнорирует), а если получено старое приветствие, то его придётся расшифровать, чтобы обнаружить, что оно устарело (по таймстемпу – тут речь о том, что допускается только расхождение на сколько-то секунд с сервером). Таким образом, проблема повторной отправки решается тоже.
Итак, в добротной реализации сервер ведёт себя тихо, с сетевой точки зрения, пока не получит валидный свежий пакет-приветствие, на который уже отвечает своим приветствием и далее может начаться сессия. Тут необходимо оговорить траспортный момент. Предположим, используется TCP. А в TCP есть собственная сессия. Соответственно, невозможно отказаться от установления TCP-сессии для того, чтобы получить начальный пакет на сервере. Это означает, что зонд может проверить доступность TCP-соединения. Конечно, само по себе TCP-соединение ещё не означает, что на сервере установлен искомый сервис, но, всё же, “наводит на мысли”. В принципе, если третья сторона анализирует трафик, то она так или иначе увидит, что к сервису кто-то подключается, поэтому само по себе TCP-зондирование ничего нового о работающем сервисе не расскажет, но вот найти подозрительный сервер-кандидат, который пока не работает, позволит. К сожалению, этот момент довольно трудно устранить. Есть способы типа port knocking (“секретный стук”), кроме того, можно ограничить доступ на уровне ядра ОС по IP-адресам источника. При этом TCP вообще позволяет несколько более эффективно ограничивать попытки повторных ложных подключений с одного IP-адреса. Но это всё полумеры.
Есть вариант с UDP. Поскольку этот протокол без сессий, то ложный зондирующий пакет будет оставлен сервером без ответа, а зонд вряд ли сможет отличить эту ситуацию от отсутствия сервиса (конечно, и тут есть свои оговорки, но от TCP – ситуация точно отличается очень существенно). UDP быстрее TCP, но могут быть проблемы с преодолением пограничных узлов, транслирующих адреса, и с тем, что в каких-то сетях UDP просто зафильтрован.
Комментировать »
Обычный вариант атаки MITM для TLS подразумевает, что у перехватывающего узла (прокси) есть секретный ключ от валидного серверного сертификата (ну и сам сертификат, естественно). Тогда перехватывающий узел выдаёт себя за настоящий TLS-сервер в сторону клиента, и за клиента – в сторону настоящего TLS-сервера.
В IP-сети всякий промежуточный узел может ответить вместо настоящего, так что в сетевом смысле атака не самая трудная. Получается, что TLS-сессия установлена не между клиентом и сервером, а превратилась в две TLS-сессии: одна – от клиента до перехватывающего узла, вторая – от перехватывающего узла до настоящего сервера. Промежуточный узел принимает трафик в обе стороны и видит его в открытом виде, так как TLS-соединение между клиентом и настоящим сервером не установлено, трафик никто не защищает.
На что тут влияет клиентская аутентификация в TLS? Вот на что: штатный способ аутентификации TLS-клиента сервером, – на этапе установления соединения, – подразумевает, что клиент подписывает все TLS-сообщения, которые были переданы до настоящего момента, а это означает, что перехватывающий узел не сможет получить корректную подпись для своей сессии в сторону подлинного сервера. Чтобы это сработало, сервер должен поддерживать клиентскую аутентификацию, конечно.
То есть, буквально, TLS-клиент при помощи секретного ключа подтверждает, что получил некоторые TLS-сообщения с конкретным содержанием (там побайтово все сообщения подаются на вход хеш-функции). В случае MITM, клиент подпишет те сообщения, которыми обменивался с перехватывающим узлом, с прокси. Но состав этих сообщений отличается от сообщений, которыми перехватывающий узел обменялся с подлинным сервером (см. ниже объяснения). Подлинный сервер же – видит лишь сообщения от перехватывающего узла (и свои собственные), соответственно, проверять клиентскую подпись он будет по этим сообщениям. Подпись, присланную клиентом, перехватывающий узел передаёт без изменений. Так как сообщения различаются, подпись не сойдётся. Перехватывающему узлу не известен секретный ключ клиента, поэтому перехватывающий узел не может подписать за клиента сообщения сессии в сторону подлинного сервера. Если же сообщения прокси передавал без изменений, то это означает, что перехвата TLS не случилось, а случилось обычное TLS-соединение и прокси не сможет раскрыть трафик.
Важная оговорка: это всё верно, но лишь без учёта возможности принудительного понижения стойкости – в принципе, перехватывающий узел, активно вмешиваясь в соединение, может вынудить стороны TLS согласовать заведомо нестойкие ключи и параметры протокола. Это позволит расшифровать трафик в пассивном режиме. Однако это совсем другая схема перехвата, она гораздо сложнее, клиенты типа современного браузера лучше защищены от применения подобных атак, а в TLS давно есть дополнительные индикаторы, помогающие такую атаку обнаружить, и т.д. В общем, в записке речь идёт о максимально простой схеме перехвата – с полной подменой узла.
А что если у перехватывающего узла есть подходящий секретный ключ и дверенный клиентский сертификат? Тогда – да, перехватывающий узел сможет выдать себя за аутентифицированного клиента в сторону подлинного сервера и продолжить прозрачный перехват, просто пригнорировав аутентификационный ответ прослушиваемого клиента.
Тут есть тонкий момент: нельзя забывать, что в TLS проверить корректность подписи и валидность клиентского сертификата должен подлинный сервер. Если сервер реально использует результат аутентификации клиента, то сессия с MITM – развалится (если у перехватывающего прокси нет клиентского секретного ключа). Но это именно особенность TLS. То есть, сервер должен всё проверять, но может и не проверить. Если сервер реально не проверяет значение клиентской подписи, то перехватывающий прокси может прислать что угодно похожее на подпись и TLS-соединение продолжит работать как обычно. Ну и тем более так будет, если сервер вообще не использует клиентской аутентификации в TLS (обычное дело).
И это приводит к следующим особенностям трансляции доверия через TLS. Предположим, что есть дополнительный прикладной протокол аутентификации, работающий через TLS, но не использующий встроенную в TLS клиентскую аутентификацию. Простейший вариант: клиент вводит пароль. Понятно, что тут MITM-прокси просто пересылает запрос на пароль клиенту, а пароль от клиента – пересылает серверу. Всё прозрачно работает, прокси узанёт пароль.
Более сложный вариант: у клиента есть секретный ключ для цифровой подписи, сервер верит в открытый ключ, соответствующий этому секретному. Сервер присылает запрос на подпись некоторых данных – клиент подписывает – сервер проверяет и убеждается, что у клиента есть секретный ключ, если всё сошлось – клиент аутентифицирован. Помешает ли это MITM-прокси? Нет, не помешает. Прокси, в рамках штатного перехвата трафика, просто копирует запрос сервера, пересылает его клиенту, получает от клиента подпись, передаёт её серверу – сработало, сервер аутентифицировал клиента и незаметил вмешательство прокси. Почему это работает? Потому, что тут аутентификация не привязана к транспортной сессии: сервер проверяет, что запросы поступают от стороны, имеющей доступ к секретному ключу, парному к доверенному открытому, но не проверяет, что транспортная сессия установлена с той же самой стороной.
Что это всё означает? Вот что: представьте, что клиент авторизуется через тот или иной механизм, использующий цифровую подпись, выполняемую на стороне клиента; эта схема, с точки зрения простого MITM-перехвата TLS, не даёт дополнительной защиты сессии. То есть, всё происходит на пару уровней выше TLS: клиент что-то подписал, сервер выдал клиенту авторизационный токен, этот токен виден на стороне MITM-прокси, теперь сторона с прокси может выдать себя за аутентифицированного клиента, подпись не требуется. Если подпись потребуется, то прокси перенаправит запрос клиенту. Да, по сравнению с паролем, тут есть некоторое преимущество: секретный ключ подписи не утекает наружу. Но, с другой стороны, выгода в плане защиты информации не так уж велика: ведь MITM-прокси может попросить клиента подписать что угодно, прикинувшись подлинным TLS-сервером при помощи перехватывающего TLS-сертификата.
Комментировать »
Ещё из серии “Забавные истории с LLM”. Снова Claude. Так как на пути программного кода возводятся неожиданные “кибербезопасные препоны” (cybersecurity guardrails), я тут на днях решил попробовать задачи из области теоретической математики: там есть Lean (это инструмент описания и проверки “компьютерных доказательств”), но не должно быть “кибербезопасных препон для безопасной безопасности”. На роль примера я наобум выбрал задачу 11.115 из “Коуровской тетради” (этот широко известный в узких кругах канонический список я упоминал ранее; как оказалось, не зря упоминал). Я набросал общее описание контрпримера к задаче, в меру собственного понимания, и попросил Claude найти конкретный контрпример и подготовить соответствующее доказательство на Lean.
Система Claude существует в нескольких LLM-воплощениях, доступны мне не все, но основные, как я понимаю, доступны. Сперва я задал запрос в Fable 5. Оно почему-то зациклилось и кружилось внутри себя, наступая периодически на “лимит вызова команд”, очень долго. Наверное, часа два. Никакого результата не выдало, но “кредиты” съело (неплохая “бизнес-модель”, кстати: показываем “юзеру” какие-то меняющиеся текстовые строки в браузере через Javascript и списываем за это “кредиты” в огромных количествах). Но не будем торопиться с выводами.
Потом я решил запустить в той же ветке Opus 5 Max. Как ни странно, Opus 5 Max довольно быстро нашло контрпример (да! и очень даже похожий на правду – см. ниже), но совсем не осилило Lean. Код Lean содержал какие-то вымышленные имена теорем, которых нет в библиотеках (я не очень хорошо понимаю Lean, но, думаю, тут всё именно так). Claude Opus 5 Max – объяснило, что на своей стороне не может компилировать Lean-код: нет среды и не хватает места, чтобы развернуть из пакетов. Но без машинного доказательства все рассуждения LLM, даже такой сверхмощной, о контрпримере, даже для такой простой задачи, – мне, к сожалению, не очень-то полезны (мой план-то был другим: попытаться вручную из корректного Lean-кода восстановить привычное математическое описание контрпримера).
Казалось бы, всё опять застопорилось.
Но нет. Внезапно Anthropic выпустили Fable 5.1. Буквально, вчера. Якобы, Fable 5.1 “сильно лучше в исследовательских задачах”, чем предыдущая Fable 5. Без особой надежды на успех, попробовал я в том же чате, со сломанным Lean, запустить Fable 5.1. Как ни странно, но оно бодро заявило, что сейчас в коде Lean оставит только те библиотеки (import), которые реально нужны для этого доказательства. Это логично. И, – возможно, – среда Lean c этими библиотеками влезет в доступные гигабайты контейнера на стороне Claude, так предположило Fable 5.1. После чего, как ни странно, действительно “урезало библиотеки” и действительно исправило ошибки в Lean-коде, так что стало понятно, что имеется в виду. В итоге, выдан файл с Lean-кодом, который уже компилируется и корректен со всех точек зрения, кроме того, что там могут быть неверные исходные допущения, но это я планирую проверить позже. Так вот.
(На всякий случай: если код и контрпример окажутся правильными, то, да, это будет решение для 11.115, которая пока что отмечена в тетради как открытая. Задачу я выбрал случайно, а критерием было то, что я сам смогу быстро написать условия на контрпример – поэтому-то и задача выбрана очень простая по формулировке и составу используемых объектов. Да, LLM-системы развиваются. Но тут и контрпример – какой-то подозрительно очевидный; если кому-то интересны супертехнические подробности, то вот: построим подгруппу на словах с чётными и нечётными степенями (это отображение в Z/2Z), и подгруппу на соотношениях с a^2. Код Lean я пока не публикую, поскольку не проверил, да и это всё может оказаться “подтягиванием” другого результата, который просто забыли упомянуть составители сборника.)
Комментировать »
Я иногда говорю, что к JWT (веб-токену) нужно относиться так, как если бы это был “публичный документ”, что JWT мог быть “написан на заборе”. Речь тут всегда идёт о точке зрения сервера, использующего “внешние” JWT для внутренней аутентификации пользователей. Но всё равно этот момент вызывает у слушателей удивление: как так? ведь это же токен аутентификации, он позволяет получить доступ к сервису, его же нужно держать в секрете! Конечно, нужно держать в секрете, если вы клиент-пользователь и только что этот токен получили. Но если вы реализуете внешний, по отношению к провайдеру токенов, сервер, то можно ли расчитывать на то, что токен клиент “держал в секрете”? Можно ли рассчитывать на то, что получал токен именно тот клиент, который сейчас его предъявил? Правильный ответ: нет и нет, нельзя. Так что нужна совсем другая интерпретация, если вы на стороне сервера, а токен получили даже не от того, кто его выдал – токен вам принёс клиент, который, предположим, и “прочитал его на заборе”.
“Что мы знаем о лисе? Ничего. И то – не все”. Вспомним про JWT. JWT – это токены доступа (JSON Web Token), содержащие различные данные, имеющие цифровую подпись, и представленные JSON-структурой. В JWT может быть записано имя пользователя и его роль, задающая уровень доступа. Данные токена нередко не зашифрованы, а занесены в открытом виде, поэтому их легко прочитать, получив токен. Банальный способ применения JWT – носитель данных авторизации. Есть разновдности токенов по назначению, а перехват того или иного токена, в типовом режиме использования, становится равносилен перехвату роли, записанной в токене. Но эффект перехвата не всегда прямой и ограниченный. Например, при “удачном” стечении обстоятельств, если перехвачен токен “обновления” (refresh JWT), то перехвативший его может “обновить” чужую сессию и получить новые параметры доступа для чужого аккаунта. JWT сейчас едва ли не повсеместно используют в качестве носителя данных в процессах авторизации/аутентификации. Несмотря на то, что сам механизм допускает дополнительные каналы подтверждения подлинности токена сервером, его выдавшим, в подавляющем большинстве случаев – JWT используют напрямую: верят самому токену и только, и хорошо, если корректно проверяют подпись и срок действия.
Пусть токен подписан цифровой подписью. Предполагается, что секретный ключ от данной подписи принадлежит некоторому доверенному провайдеру токенов. Однако, чтобы сформировать доверие технически, можно начать верить в открытый ключ, связанный с провайдером токенов. Сам по себе JWT, что бы в нём ни было написано, доверия вызывать не должен. Правильно: ведь клиент-пользователь мог “прочитать его на заборе”.
Это как раз и означает, что для системы, которая проверяет доступы по токену, используя указанные внутри токена параметры (scope) и значение подписи, всё равно, как этот токен получен. Нельзя строить доверие только на способе получения токена, а тем более, на том, что токен принёс клиент, назвавшийся каким-то там именем.
То есть, буквально, доверие внутри системы, которая проверяет данный токен, образуется потому, что токен содержит валидную подпись от дверенного ключа, а не потому, что токен был получен каким-то “защищённым” образом. Например, с точки зрения этой системы – данный токен вообще можно считать публичным документом, сколь бы парадоксальным это ни казалось. (Ещё раз, данные внутри полей токена могут быть дополнительно зашифрованы (JWE), а чтобы их прочитать – нужно знать подходящий ключ. Но это дополнительная мера.)
Почему это всё может казаться странным? Прежде всего потому, что, в массовых сценариях веба, JWT разрешает доступ некоторому пользователю к некоторой онлайн-системе и разрешает использование некоторых функций. Соответственно, если пользователь свой авторизационный токен потерял, а кто-то этот токен – нашёл (“прочитал на заборе”), то этот “кто-то” может получить и доступ пользователя к целевой системе (полный аналог “авторизационной куки”). От действий пользователя этот доступ уже не зависит. Поэтому, конечно, пользователь должен держать свой токен в секрете. Это очевидно. Возникает ли тут противоречие? “Публичный документ”, который нужно держать в секрете? Как это? Но обратите внимание, что тут нет никаких механизмов дополнительного подтверждения для пользователя: пользователь где-то получил токен; вероятно, там он вводил пароль или ещё как-то авторизовался, но теперь токен действует непосредственно – если внутри токена, в открытом виде, написано, что это пользователь Имярек, значит, в доверяющей системе пользователь с данным токеном станет Имяреком. То есть, противоречия нет. А вся хитрость в том, что это просто так принято: считать JWT секретным и привязанным к пользователю, но без реальных проверок. Проверки возможны – об этом в конце записки.
Важный момент, про который нельзя забывать: от пользователя, авторизующегося при помощи JWT в базовой схеме, даже не требуется доказательство владения секретным ключом от подписи в токене. Считается, что ключ есть у сервиса, который выпускает токен. Соответственно, если подходить строго формально, то и авторизация тут предоставляется ключу сервиса, не пользователю. То есть, всякий может прочитать значения внутри токена (если он не зашифрован) и внешний сервис (не пользователь!) имеет полный контроль над ключом, позволяющим создавать доверенные токены, в том числе, с заданным значением полей. Это ли не “публичный документ”, при прочих равных?
Заметьте, что так как обычный JWT самодостаточен, утащить его у пользователя может и тот сервис, на котором пользователь пытается JWT применить. Другими словами: пользователь получает JWT на одном сервисе, но сам протокол подразумевает, что пользователь потом предъявляет этот токен произвольным другим сервисам, которые токен видят и могут использовать в произвольных целях. То есть, опять возникают признаки “публичного документа”.
Но если интерепртировать JWT как публичный, то, получается, и доступ предоставить можно только тот же, что получает произвольный, неавторизованный пользователь? В идеале – именно так и должно быть (и см. про расширения протокола ниже). Однако на практике – это радикально уменьшает степень полезности JWT. Да, такие “определённо публичные” JWT всё ещё можно использовать как некий инструмент подтверждения происхождения данных, например, в качестве доверенного файла конфигурации: ведь изменить параметры, не зная секретного ключа, не получится. Но от JWT ожидают некоторого прозрачного способа аутентификации “по цепочке”: то есть, какой-то другой сервис пользователя проверил, выпустил подтверждение, отдал его пользователю, и теперь это подтверждение принимается на другом сервисе как эквивалент локальной аутентификации. Удобно. Но не всегда правильно.
Вообще, история с дополнительным ограничением применимости JWT весьма важная. Например, RFC 9449 как раз описывает дополнительный механизм, который позволяет привязать JWT, выданный внешним сервисом, к открытому ключу, секретную часть которого контролирует пользователь, предъявивший JWT. При использовании JWT пользователь предъявляет и доказательство владения собственным секретным ключом. В такой схеме уже не получится использовать только лишь подписанный внешним сервисом JWT. Нужно ещё знать пользовательский секретный ключ. И это как раз полный и верный ответ на трактовку JWT как публичного документа: да, JWT – публичный, но чтобы применить его на сервисе – нужно доказать знание пользовательсткого секретного ключа, поэтому-то в этой схеме “просто прочитать JWT на заборе” уже не достаточно.
Комментировать »
Вновь пишут про успехи ИИ/LLM-систем “олимпиадного уровня”, на этот раз – про набор из задач Международной лингвистической олимпиады (IOL), где LLM-система Claude Opus 4.8 показывает “результат уровня золотой медали”.
Странно всё это.
Я некоторое время использую Claude Opus 5 Max, которая, вроде как, должна быть получше. Cправедливости ради, необходимо отметить, что вот программный код, – при компактной задаче и наличии подробнейшего пошагового описания того, что и как должна делать программа, – оно генерирует неплохой (пусть и не всегда, но – почти всегда неплохой; возможно, если доступ не отберут, я как-нибудь поделюсь впечатлениями). Однако вот языковая логика (не языка программирования, а естественная) – нередко хромает. На все три ноги из двух.
Так, недавно эта система выдала мне заведомую “дихотомию”, но с третьим вариантом. Да. Буквально:
если вы знаете пароль – тогда, [blah blah blah, текст про этот вариант];
если вы не знаете пароль – тогда, [blah blah blah, текст про вариант, когда пароль не знаем];
если ни то, ни другое (neither) – [blah blah blah, произвольный текст, который, понятно, не может относиться к поставленной задаче, где мы либо знаем пароль, либо не знаем пароль].
Но, оказывается, уровень “золотой медали” по языковым задачам был у прошлой модели. Как говорится: “что-то тут не так”. Продолжаем наблюдение.
Комментарии (2) »
Сейчас на веб-сайтах крупнейших российских банков в TLS появился “сертификат Минцифры”, в том числе, на веб-интерфейсах систем “Личного кабинета”. “Сертификат Минцифры” – это сертификат корневого ключа Национального Удостоверяющего Центра, “сертификат НУЦ”. То есть, для штатного соединения – нужно доверие соответствующим корневым сертификатам (от НУЦ). Из коробки – доверие есть только в “Яндекс.Браузере”. В остальных случаях – нужно добавлять сертификат вручную.
С доверием тут проблема не только в браузерах. Сертификатам этим вообще доверяют не все пользователи. В связи с этим сейчас много где рекомендуется некоторый весьма технический метод установки “сертификатов Минцифры”, но с ограничением по допустимым именам хостов, чтобы сертификаты от данного корня считались валидными только для некоторых имён, предположим, для имён только в зоне .RU, или для имён только в DNS-зоне банковского сайта. Это боязнь атаки типа MITM: технически, всякий УЦ может выпустить сертификат для любого имени.
Речь не про механизмы управления доверием по именам в конкретных браузерах, а именно про уровень TLS-сертификатов и цифровой подписи. Чтобы реализовать ограничения, предлагается “переподписывание” при помощи собственного, локального доверенного корневого ключа, с установлением ограничений в nameConstraints. Схема многим кажется хитрой. И надо заметить, что техническая хитрость в схеме действительно есть. Я не считаю, что это хорошая схема для продвинутого пользователя. Для такого пользователя гораздо лучше – аккуратно создать отдельную копию браузера, со своим списком корней. Поэтому детальных команд я не привожу, но если захотите, то сгенерировать всё нетрудно при помощи OpenSSL (не забудьте только ключи удалить).
Вообще, цель этой записки в другом: объяснить, что это всё означает, почему и как работает. Речь здесь пойдёт про веб-браузеры и TLS в HTTPS.
Итак, упомянутая выше схема “переподписывания” давно известна среди специалистов, она вполне штатная, и называется “кросс-подпись”. Логика алгоритма в том, что открытый ключ из целевого “корневого сертификата”, – обозначим его литерой “Б”, – подписывается ключом доверенного УЦ, а получившийся новый сертификат содержит такой же открытый ключ, как сертификат “Б”, и такое же имя в поле Subject. По такой схеме долгое время в браузерах работал УЦ Let’s Encrypt (да и сейчас есть сертификаты для корневых ключей Let’s Encrypt, выпущенные от других УЦ, это улучшает совместимость).
Почему кросс-подпись работает? Потому что в ходе валидации серверного сертификата цепочка строится по именам (Issuer <===> Subject), а подписи проверяются по открытым ключам из сертификатов цепочки. Часть цепочки – присылает сервер, а доверенный корень – встроен в браузер. Чтобы сертификат был признан валидным, необходимо (но не достаточно), чтобы цепочка пришла к доверенному ключу. Но нет разницы, что это за ключ и откуда он – главное, чтобы он был доверенным. Поэтому прочие данные из TLS-сертификата всегда играют вспомогательную роль, главное, что есть в сертификате – открытый ключ. Поэтому и сертификаты строго называют “сертификатами ключей”.
Предположим, что сервер вернул собственный, оконечный сертификат, а подпись на этом сертификате стоит от ключа промежуточного удостоверяющего центра (УЦ), сертификат данного ключа тоже прислал сервер. Валидирующий сертификаты браузер выбирает сертификат подписывающего ключа, прежде всего, по имени Issuer из подписанного сертификата, потом производится попытка проверки подписи ключом из выбранного сертификата. Если вдруг оказалось несколько сертификатов, подходящих по имени, но с разными ключами, то процедура проверки подписи даст валидный результат только для правильного ключа. Обратите на этот момент внимание – он главный: проверка подписи выполняется при помощи ключа, и доверие, в конечном итоге, выстраивается по ключам. Фокус схемы с кросс-подписью в том, что ваш браузер начинает верить в ключ потому, что доверие этому ключу прямо установлено. И установлено доверие может быть другим корневым сертификатом, а не тем, который предлагается “скачать и установить”. Главное, чтобы открытый ключ совпадал.
Оказывается, этот момент регулярно ускользает из поля внимания даже технически продвинутых пользователей, а в результате – теряется понимание процесса.
Рассмотрим очень подробный пример.
Пусть сервер адресуется именем example.com. Для example.com выпущен оконечный (серверный) сертификат от ключа промежуточного УЦ под названием Interm-CA-1. Для открытого ключа этого УЦ Interm-CA-1 выпущен сертификат “корневым УЦ” Root-CA-1. И открытый ключ Root-CA-1 встроен в браузер. Браузер доверяет открытому ключу Root-CA-1. Этот открытый ключ непосредственно указан в сертификате Root-CA-1. Тогда браузер выстраивает цепочку example.com <- Interm-CA-1 <- Root-CA-1, проверяет подписи от Root-CA-1 на Interm-CA-1, а от Interm-CA-1 на example.com и, если всё сошлось, распространяет доверие по цепочке до сертификата example.com. Это обычный способ, без кросс-подписи.
Теперь представьте, что в браузере есть и Root-CA-2, тоже доверенный. Пусть Root-CA-2 выпустил и подписал сертификат для того же открытого ключа, который указан в сертификате Root-CA-1. “Обычный” сертификат корневого ключа Root-CA-1, который упоминался выше, – это самоподписанный сертификат, то есть, подпись в нём от того же ключа, открытая часть которого указана в сертификате. Новый сертификат, выпущенный для ключа Root-CA-1 не является самоподписанным – его подписал Root-CA-2, используя другой ключ.
Обратите внимание: открытый ключ в этом новом сертификате – тот же, что и в самоподписанном сертификате корневого ключа Root-CA-1. Это подпись другая. Соответственно, этот открытый ключ позволит успешно проверить подпись, поставленную Root-CA-1 на сертификате Interm-CA-1 из цепочки, описанной выше. Более того, когда УЦ Root-CA-2 генерировал сертификат для ключа Root-CA-1, то этот УЦ и в качестве имени Subject сертификата указал Root-CA-1. Но Issuer – отличается: здесь стоит Root-CA-2 (в самоподписанном исходном и Issuer, и Subject – были Root-CA-1). Браузер верит ключу Root-CA-2. Теперь возможна другая цепочка: example.com <- Interm-CA-1 <- {Root-CA-1} <- Root-CA-2. Цепочка ведёт к Root-CA-2, он доверенный. Сертификат в фигурных скобках {Root-CA-1} – это сертификат для того же открытого ключа, от Root-CA-1, но выпущен он Root-CA-2. А раз это тот же ключ, то и для сертификатов, которые в цепочке находятся левее {Root-CA-1} ничего не поменялось – доверие транслируется точно так же. Это и есть кросс-подпись.
В схеме кросс-подписи больше не нужен доверенный корневой самоподписанный сертификат Root-CA-1. Его не нужно ставить в браузер вообще, потому что доверие транслируется от Root-CA-2 через кросс-подпись, поставленную на ключе, а не “на исходном сертификате”, как почему-то иногда пишут. Нет, исходный корневой сертификат не “переподписывается” – из него просто берётся открытый ключ, а далее доверие этому ключу образуется при помощи его подписывания собственным, локальным корневым ключом. И в браузер добавляется доверие этому, корневому ключу. Естестсвенно, необходим {Root-CA-1} (в фигурных скобках), выпущенный Root-CA-2. Этот сертификат (в фигурных скобках) локальный, его не пришлёт сервер. Поэтому сертификат придётся добавить в браузер (если для этого сертификата установить флаг доверия, то не нужен уже Root-CA-2, кстати. Но см. ниже про целевые ограничения – их нельзя утрачивать.)
Где же здесь ограничения? Они в nameConstraints. В TLS-сертификатах есть штатный способ, который позволяет описать ограничения по именам, для которых применим ключ из сертификата. Обратите внимание на важный момент: это механизм описания, он вовсе никак не позволяет “реализовать ограничение”. Реализация – остаётся на стороне валидатора сертификатов. То есть, если браузер применяет ограничения из блока сертификата nameConstraints, то сертификат не будет считаться валидным для имён, за пределами списка, если не применяет – будет. Современные браузеры nameConstraints обрабатывают и ограничения применяют. В частности, Firefox действует даже строже, чем предписывают RFC, касающиеся этих ограничений.
Механизм ограничения валидности довольно прост: в поле nameConstraints перечисляются наборы DNS-имён для которых разрешено или запрещено применять ключ при проверке подписи. Прежде всего, данное поле предназначено для сертификатов ключей УЦ. То есть, для ключей, от которых выпускаются другие сертификаты. При корректном применении ограничения должны действовать по всей цепочке вниз. Например, если в корневом сертификате указано ограничение “разрешено только для example.com”, то валидатор, следующий ограничениям, не примет сертификат от этого корня для example.net. Цепочка проверки при этом может включать несколько промежуточных сертификатов. Ограничения по именам применяются и тогда, когда в сертификате этих имён много: все имена должны быть разрешены, иначе валидация не пройдёт. То есть, при правильной реализации, метод весьма действенный.
Теперь, если мы подписываем кросс-подписью ключ другого УЦ, то мы можем указать нужные ограничения в сертификате, который подписываем. Ограничения перечисляются в nameConstraints. В принципе, ограничения можно указать и сразу в локальном сертификате корневого ключа. В качестве состава ограничений может быть как только конкретный домен верхнего уровня, так и конкретные DNS-имена веб-сайтов. Тогда браузер посчитает невалидными оконечные сертификаты, выпущенные от исходного корневого ключа, но для имён, которые не входят в разрешённый список. Предполагается, что это противодействует потенциальным MITM-атакам: “ограниченный” корневой сертификат уже не позволит браузеру посчитать валидным оконечный сертификат, выпущенный для, условно, google.com. Заметьте, впрочем, что у Chrome и Google есть специальные меры, отслеживающие подобную подмену без всяких nameConstarints и собственного локального корня. При этом локальный корень, налаженный по описанной схеме в том же Chrome, данные меры поломает, поскольку всё будет выглядеть так, как если бы в систему установлен “сертификат корпоративного УЦ”, а для таких случаев многие способы детектирования подмены серверных ключей работают не так строго. Это один из неочевидных аспектов использования данного решения.
Итак, схема сводится к следующим шагам: 1) генерируем собственный корневой секретный ключ и сертификат для этого ключа с ограничениями по именам в nameConstraints; 2) встраиваем в браузер открытую часть данного ключа в качестве доверенного; 3) выпускаем от этого корневого ключа сертификат кросс-подписи для ключа из “сертификата Минцифры”, совпадающий по имени Issuer с “оригинальным”, возможно, повторяем тут ограничения по именам, добавляем этот сертификат тоже в доверенные. “Сертификат Минцифры” – добавлять не нужно, уже добавлен ключ из него. Всё. Теперь браузером начинают считаться доверенными сертификаты только на сайтах, подходящих по именам.
Какие есть подводные камни на этом направлении? Самые разные. Форма и размер этих камней – определяются теми рисками, с которыми вы попытались бороться. Прежде всего: наличие локального “ограниченного” корня вовсе не отменяет установления TLS-соединения. Нет. Браузер всё равно будет подключаться к произвольным сайтам, выполнять начальную стадию TLS-соединения, и лишь получив в ответ сертификат, ключ из которого сходится к нашему “ограниченному корню”, применять ограничения по именам и выдавать ошибку, если ограничения не позволяют принять сертификат. Про это нельзя забывать: собственный корень не ограничивает подключение и обработку сертификатов, он управляет только итогом валидации.
Заметьте, кстати, что если на локальном компьютре установлен антивирус, перехватывающий TLS-соединения браузера, то все описанные манипуляции с сертификатами никак не повлияют на реальное положение дел с валидацией.
Добавление локального корневого сертификата в доверенные означает, что если соответствующий секретный ключ утечёт, то тот, кто его получил, сможет подменять сертификаты для всех вариантов имён, подходящих под ограничение nameConstaraints. Если это сайты банков, то сразу возникает весьма неприятный риск. Поэтому, как минимум, следует защитить (лучше – уничтожить) такой “подменный” секретный ключ. Этот момент тоже постоянно упускают из виду.
Соответственно, если идея “ограничений” состояла в том, чтобы ограничить применение “сертификатов к сайтам”, то в данной схеме это не так, сертификаты продолжают применяться, они лишь не считаются валидными. Поэтому вариант с отдельным браузером, под конкретные сайты, имеющим собственный набор корневых сертификатов, в который либо добавлен вручную оригинальный корень, либо собственный корень для “кросс-подписи”, может оказаться сильно лучше.
Комментировать »
Ближайшее будущее в области TLS-сертификатов для веба – это сертификаты на хеш-деревьях. Я писал об этом неоднократно. Ещё одно подтверждение: черновик политики Google по включению в список доверенных удостоверяющих центров (УЦ) веб-браузера Chrome. Этот черновик касается постквантовых криптосистем цифровой подписи (или, как их ещё обозначают, “квантовостойких” криптосистем). В контексте данной программы доверенных УЦ Chrome – это криптосистема ML-DSA (и только). Но главное тут не тип криптосистемы, а то, что политика допускает исключительно схему с хеш-деревьями, с MTC (Merkle Tree Certificates). Соответственно, УЦ, не поддерживающие MTC – в программу даже податься не смогут, вне зависимости от других параметров. MTC, с точки зрения УЦ, совсем другая история, если сранивать с имеющимся сейчас вариантом.
Этот вариант, – хеш-деревья, – алгоритмически близок с реализации Certificate Transparency (CT). Концептуально, MTC – это перенос CT на сторону УЦ. Поэтому в черновике политики прямо сказано, что на начальном этапе включение в “квантовостойкие корни браузера” будет доступно только для тех организаций, которые уже поддерживают работоспособный лог CT (то есть, запустили такой лог до 1 февраля 2026 года). К таким организация, естественно, относятся Let’s Encrypt, Cloudflare и Google (но не только эти).
Основные особенности MTC в TLS: “бесподписные” сертификаты – то есть, буквально, серверные TLS-сертификаты в которых вместо подписи – доказательство включения в хеш-дерево; очень короткий срок действия сертификатов – предпочтение будет отдаваться “шестидневным” сертификтам (и более “коротким”). “Бесподписная” часть – экономит трафик, поскольку сильно уменьшает размер сертификата в байтах, но также привязывает клиента к сервису, с которого нужно скачивать обновления дерева. Короткий срок действия – привязывает к точке выдачи сертификатов (и, таким образом, к провайдеру данных дерева) ещё и операторов TLS-серверов.
Комментировать »
 Новый
