Ресурсы: техническое описание TLS, LaTeX - в картинки (img), криптографическая библиотека Arduino, шифр "Кузнечик" на ассемблере AMD64/AVX и ARM64
Cloudflare становится самостоятельным “хорошо известным” Удостоверяющим Центром (УЦ), который включен в браузеры. Уже включен, потому что Cloudflare покупает корень от GlobalSign, а он уже входит в браузерный список доверенных. То есть, GlobalSign – это теперь Cloudflare, которые его купили:
we have signed a definitive agreement to acquire an established, broadly trusted root from GlobalSign (мы подписали итоговое соглашение, чтобы приобрести действующий корень GlobalSign с повсеместным доверием).
Так-то. Интересное развитие.
Комментировать »
На фото ниже – антикварная шведская шкатулка, явно предполагавшая использование двух замков.
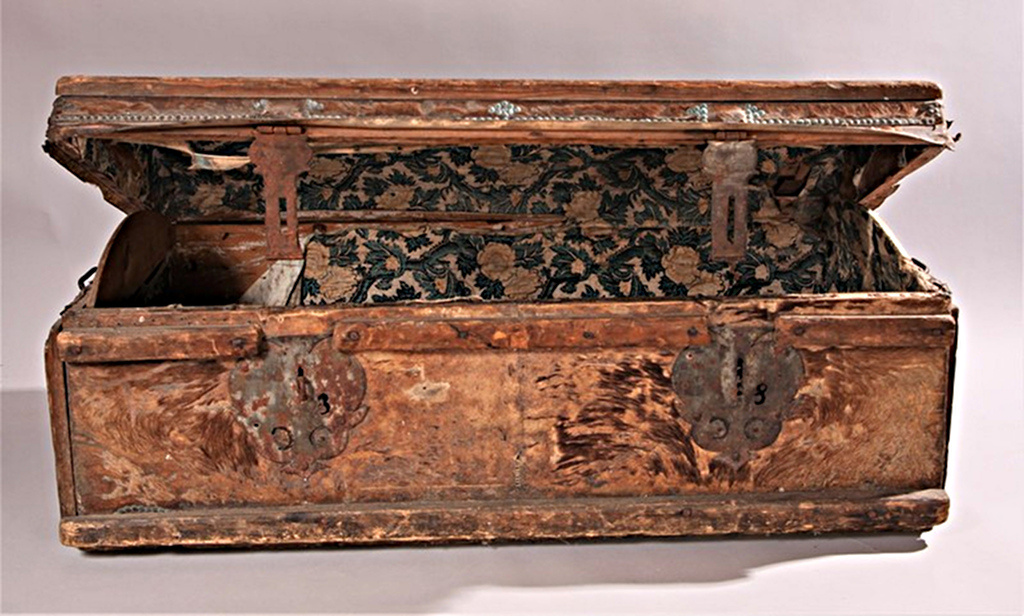
(Tomas Näslund/Vindelns hembygdsförening, источник; датировка не ясна, но, судя по всему, позже 18 века.)
Эта шкатулка явно не древняя, хоть и старинная, однако прочные сундуки и секретные коробки с двумя замками использовались ещё в древнем Риме. Сценарии использования могли быть разными.
Здесь эта фотография послужит иллюстрацией к схеме “протокриптографии”, которую я иногда привожу как пример древнего способа обмена секретными сведениями по открытому каналу без предварительного распределения ключей. И ключи здесь – это именно физические ключи. Сама схема, в принципе, известная. Но хорошо иллюстрирует особенности именнно инженерно-технической защиты информации в древности. То есть, сейчас принято считать контринтуитивной саму идею о том, что можно передать некие сведения между двумя сторонами, которые не имеют общего ключа, по открытому каналу так, что третья сторона не сможет простым способом получить доступ. Идея, может, и контринтуитивная, но, вообще говоря, подобную схему можно придумать, если посмотреть на шкатулки с двумя навесными замками.
Итак, сама схема. Есть две стороны, A и B. Сторона A хочет отправить стороне B секретную записку с недоверенным курьером. Общего механического ключа, – чтобы на стороне A запереть шкатулку, а отпереть на стороне B другой копией ключа, – нет. Как поступить?
Вот как: сторона A пишет записку и кладёт её в шкатулку, подобную той, что на фотографии, то есть с двумя местами для навесных замков. Закрыв шкатулку, A навешивает свой замок и оставляет у себя ключ. Запертая шкатулка отправляется “по открытому каналу” – то есть, с курьером стороне B. Сторона B шкатулку открыть не может – нет ключа, – но навешивает свой замок, от которого ключ есть, и отправляет шкатулку с двумя замками обратно. Сторона A, получив шкатулку, снимает свой замок, и снова отправляет запертую шкатулку стороне B. Теперь сторона B может снять свой замок и открыть шкатулку. Получилась схема обмена секретной запиской по открытому каналу без предварительного распределения ключей.
Что тут было бы предварительным распределением ключей? Да самое простое решение: сторона А и сторона B могли бы просто иметь копию ключа к одному замку, которым запирается шкатулка. Это простейший вариант. Если нужна схема посложнее, с разными ключами, то можно взять шкатулку со специальным замком: такой замок позволяет открыть шкатулку любым ключом из двух разных (этого несложно добиться: например, засов внутреннего замка на два ключа имеет два направления для открывания, каждое направление запирается “личинкой” под свой ключ). Понятно, что эти схемы сильно отличаются от исходной: один замок – два ключа. Ключ как-то нужно отправить второй стороне, если нет доверенного канала передачи ключа, то схема теряет секретность: ключ могут скопировать “на транзите”, и потом незаметно открыть шкатулку.
Какие есть особенности у схемы с двумя замками? Первая, самая главная: ключи не покидают пределы доверенного периметра. За периметр уходит только запертая шкатулка. Вторая особенность: заперев внутри шкатулки записку, сторона А уже не может поменять содержание записки, если шкатулка попала к стороне B. Третья особенность: сторона B – получит ту же самую записку, которая размещена в шкатулке изначально, но с двойным подтверждением, так как сторона-отправитель (сторона A) и поставила замок, и сняла его (подтверив, что есть ключ). Например, все эти особенности используются в статье “Покер в уме” (“Ментальный покер”, Shamir, Rivest, Adleman, MIT-LCS-TM-125, 1979), где и описана исходная схема (авторы указывают, что её предложил М. Рабин), но со многими шкатулками и для игральных карт.
К сожалению, схема работает только в том случае, если стороны обмена шкатулкой аутентифицированы! Описанная схема с двумя замками и шкатулкой подвержена классической атаке типа “человек посередине”. И в этом её основная техническая проблема. Но этот же момент сильно повышает дидактическую ценность схемы. До сих пор, говоря о том, что между сторонами существует открытый канал, мы подразумевали, что атакующий, просматривающий данный канал, пассивный – то есть, доставка шкатулки гарантируется: курьер не сможет удержаться от того, чтобы заглянуть в незапертую шкатулку и прочитать записку, но не станет менять процесс доставки. Активный же атакующий просто перехватывает шкатулку, навешивает свой замок, отправляет шкатулку обратно, получает снятый замок стороны A, открывает свой замок, читает записку, навешивает свой замок обратно и отправляет шкатулку стороне B, получателю. Естественно, с той лишь целью, чтобы потом выступить в роли стороны A, сняв по запросу свой замок.
Это, вообще говоря, неустранимая особенность подобных схем. Как ни странно, проявляется и в современной криптографии: например, такой же атаке подвержена схема Диффи-Хеллмана.
Каждая из сторон должна как-то убедиться, что обменивается шкатулкой именно с тем, с кем планировалось. Добиться этого при помощи лишь ключей и замков на шкатулке – не получится. Да, стороны могли бы знать и узнавать замки друг друга, но для этого стороны должны замки увидеть раньше. То есть, для первого обмена – не сработает. Зато сработает для повторных обменов: именно так, как сейчас действует механизм запоминания отпечатка ключа при первом контакте. Естественно, вариант со шкатулкой и двумя замками совсем теряет смысл, если использовать его повторно: если предполагается повторный обмен, то в первой итерации шкатулка должна содержать общий “секретный ключ”, который потом будет использован для другой шкатулки, с одним замком. Это сильно уменьшит трафик шкатулок (ср., например, с TLS и симметричными шифрами сейчас).
Естественно, помимо отметок на шкатулке и на самих замках, которые привязывают замок к шкатулке, стороны, обменивающиеся шкатулкой, могут приложить к ней письмо, в открытом виде, где подтвердят, что это именно они направляют шкатулку с конкретным замком. “Конкретность” замка тут, понятно, имеет исключительное, определяющее значение – иначе атакующий может просто подставить свой замок, сохранив сопроводительное письмо. Как узнать, что письмо подлинное? Например, по почерку. А почерк, предположим, может узнать человек, знакомый с каждым из участников. Получается система с доверенной третьей стороной (ср. например, с TLS-сертификатами и иерархией удостоверяющих центров).
В истории математической криптографии аналогичная схема известна как “трёхэтапный протокол Шамира”, который работает полностью аналогично шкатулке с замками, но шаг со снятием исходного замка возможен благодаря коммутативности используемой криптосистемы (см. Mental Poker по ссылке выше). В общем, очень полезная иллюстрация.
Комментировать »
Traffic Control. Имеется в виду трафик на дорогах. Механическая интерактивная детская игра. 1959 год. За 24 года до Интернета. Сделано из жести, с жестяными же автомобильчиками и автобусом, всё качественно раскрашено. (Не моё, ссылка на исходное видео с обзором – ниже.)
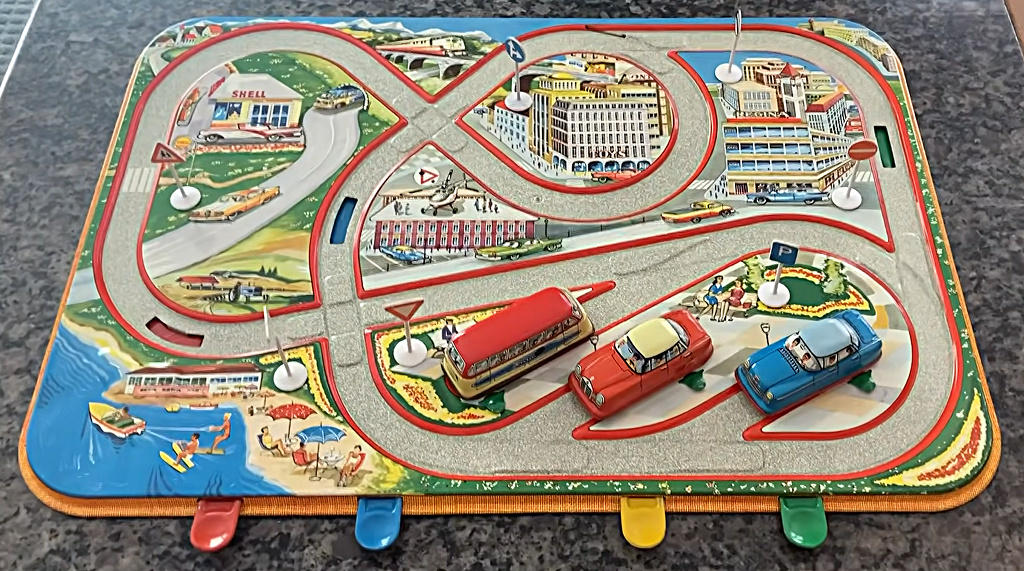
(Скриншот из видео, joe martella, Youtube.)
Автобус и автомобили – заводные, запускаются с парковки и едут по дорогам. Движением транспортных средств нужно управлять при помощи цветных кнопок (или клавиш), которые видны снизу. Подробное видео работы игрушки есть в обзоре (англ., Youtube). Довольно занимательное решение, между прочим. Немалая игровая ценность образуется из одного единственного приёма – это поворот наверху, позволяющий перенаправлять траспортное средство на разные петли: движение прямо или правый поворот.
Комментировать »
В свежем Chrome 155 включена поддержка подписей ML-DSA в TLS-сертификатах (в том числе). Но не для корневых ключей, входящих в общую глобальную иерархию доверенных ключей, которая “коробочная” – то есть, не для WebPKI, а только для внутренних систем, с добавлением корневых ключей вручную: на сайтах и “из коробки” отдельные TLS-сертификаты с ML-DSA пока не планируются, а планируется, что будет добавлена сразу схема на хеш-деревьях.
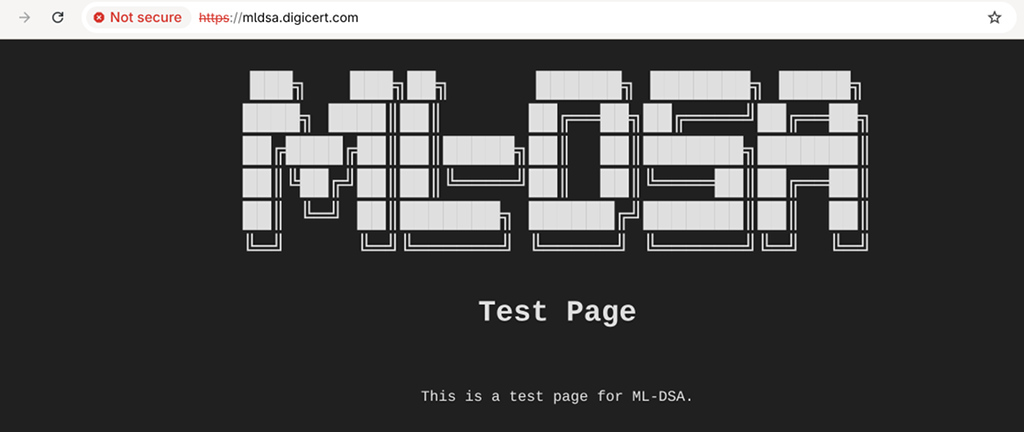
ML-DSA – это постквантовая криптосистема цифровой подписи. У DigiCert есть тестовый веб-сайт, где используется цепочка сертификатов с ML-DSA-подписями. Так что посмотреть на такие сертификаты можно даже браузером. Но без автоматической валидации. К сожалению, оконечный сертификат на веб-узле по ссылке не содержит SAN: вообще говоря, по современным спецификациям, да с точки зрения браузера, такой сертификат не валиден для веб-узла в TLS, безотносительно ML-DSA, поскольку строго требуется указание имени именно в SAN, а Subject/CN – давно не используется для проверки DNS-имени (но можно добавить исключение, конечно).
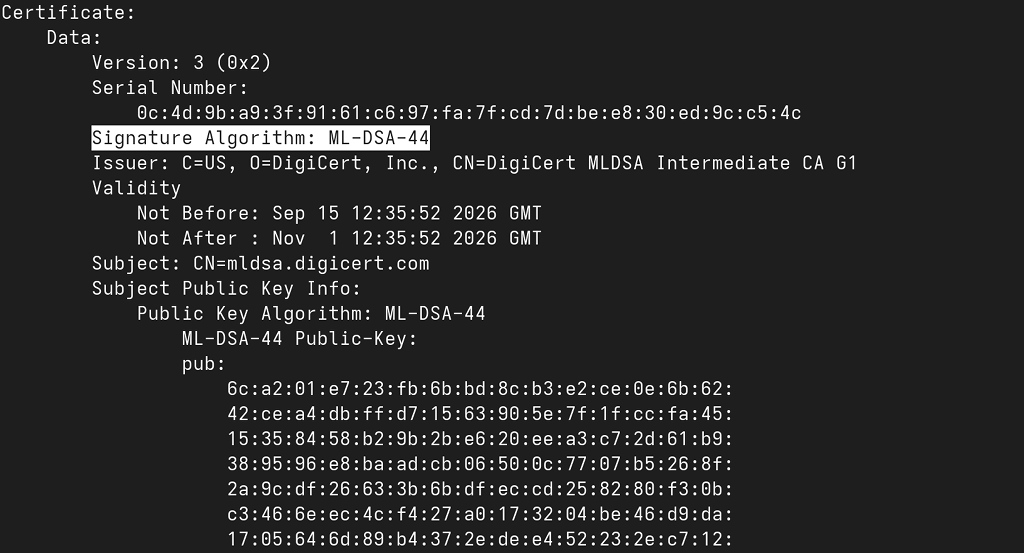
Другими словами: автоматически перейти на подобные сертификаты для веб-сайта пока что не получится, и не только потому, что никакой хорошо известный УЦ ещё их не поддерживает, но и потому, что не поддерживают браузеры. Но сделать собственную цепочку TLS-сертификатов с ML-DSA (и, кстати, CRL тоже), а потом попробовать, что произойдёт в Chrome свежей версии – уже можно: средства и спецификации есть.
И, ещё раз, не забывайте, что внедрение именно такого варианта в “общем вебе” даже не планируется. Доверенные УЦ сразу перейдут на MTC – сертификаты на хеш-деревьях. Там тоже используется ML-DSA, но схема совсем другая, и она позволяет вовсе не указывать подписи в самих оконечных (серверных) сертификатах.
Комментировать »
Небольшой оффтопик. Почитал тут отзывы про консультативную группу “про ИИ в математике”, которую упоминал вчера. В OpenAI, несомненно, сильный маркетинг (и особенно сильно направление, которое принято называть GR/PR – можно отделять от “чистого маркетинга”, можно не отделять, это просто оговорка, тут не важно). Поэтому и данная свежая история про консультативную группу по ИИ в математике – это же чисто маркетинговый ход, по лучшим учебникам, просто хрестоматийный. Странно, что не все это понимают. Смотрите сами: у OpenAI есть риск получить негативный эффект на почве отношения сообщества к тому, что OpenAI ломает складывавшиеся десятилетиями правила публикации “решения задач”. Это далеко не репутационный ущерб, ещё только риск. Но риск есть? Есть. Не проблема, сделаем всё по учебникам: заранее блокируем риск – покажем ответственное отношение к вопросу, сформируем и продвинем консультативную группу!
Теперь заметьте главное: чёткий положительный маркетинговый эффект от создания такой группы – мгновенный. Ещё сильнее он работает в положительную сторону, блокируя риски, в актуальном контексте одобрения “решения ещё сотни задач”. А что же группа будет делать для математики? А это уже вопрос будущего – очевидно, что сам принцип одобрения публикаций такая группа только подкрепляет, поэтому, пока участники группы пытаются как-то оправдать и объяснить своё участие (тоже – “хотим как лучше”), станем пользоваться немедленным положительным маркетинговым эффектом. Мудрый, грамотный ход. Но маркетинговый.
Комментировать »
В 2025 году я писал (в том числе, на “Хабр”), что “суперинтеллект” будет определяться по сообщениям газет. Если точнее, то ИИ станет “сверхразумом”, как только газеты про это напишут. Буквально:
Если только не считать, что степень сверхразумности будет определяться по сообщениям газет: может же так быть, что какую‑то новую систему просто объявят сверхразумной? Вполне.
Что ж, ждать потребовалось не долго: сегодня, в 2026 году, президент США Трамп, как пишут, постановил называть “искусственный интеллект” – “сверхинтеллектом” или “сверхразумом”: Super Intelligence, SI. Такой термин теперь рекомендовано использовать в штатовских официальных правительственных документах. Вот.
Комментировать »
Из OpenAI пишут, что решили ещё “более сотни” давних математических задач (интересно, есть ли там 11.115 из “Коуровской тетради” – ну, а вдруг?) и сформировали, ни много ни мало, а консультативную группу (advisory group) по математике и искусственному интеллекту. Группа, получается, будет определять, что и как публиковать. В общем, что называется, “история получила занимательное продолжение”. Продолжаем наблюдение.
Комментировать »
Пробное расшифрование – это хоть и вычислительно затратный, но типовой метод обнаружения подлинных попыток соединения на скрытом сервисе. При этом, если сервис правильно спроектирован, то и вычислительные затраты можно свести к весьма разумному уровню – процессоры сейчас мощные, тот же шифр AES – практически всегда на серверной стороне доступен в аппаратной реализации.
Основной принцип пробного расширования следующий: на сервер приходит внешний пакет, который может содержать данные для начального соединения от подлинного клиента – то есть, такое клиентское приветствие, позволяющее установить сетевое соединение и туннель, полностью зашифрованный. Сервер отвечает только на подлинные приветствия, а в ответ на поддельные – молчит. Здесь предполагается, что клиент и сервер уже знают общие симметричные секреты: обычно, это секретные ключи, настроенные в конфигурации и сервера, и клиента.
Содержание начального пакета данных должно быть вычислительно неотличимо от случайных данных (от шума) для внешнего наблюдателя. Это как раз и достигается тем, что данные зашифрованы. Но зашифрованы должны быть буквально все данные. То есть, тут не может быть некоторой структуры приветствия, как, например, в TLS: если пакет содержит некоторые заданные спецификацией поля (версию, идентификатор, таймстемп и пр.), то пассивный наблюдатель легко узнает протокол, к которому такой пакет относится. Поэтому видимой структуры быть не должно, но она может быть скрыта в зашифрованном блоке. (Тут еще есть транспортный аспект, типа TCP, об этом отдельно рассказано ниже.)
Но если пакет выглядит как шум, то что делать серверу? Тут как раз и начинается пробное расшифрование. Сервер пытается расшифровать полученные данные всеми известными ему клиентскими симметричными ключами. Внутри зашифрованного блока данных, – то есть, в открытом тексте, – уже содержится структура, которая и позволяет серверу понять, что расшифровано правильно – то есть, ключ найден верный. Это довольно хорошо отработанный подход, поэтому есть типовое решение: начальная часть открытого текста должна содержать достаточно длинный идентификатор клиента (например, 128 бит), этот же идентификатор сохраняется в таблице на стороне сервера, вместе с соотвествующими секретными ключами. Сервер перебирает эти ключи, расшифровывая пакет каждым.
Как только сервер, в результате расшифрования, получил идентификатор, совпавший с данными в таблице – сервер считает, что это начальное сообщение именно от того клиента, который указан в таблице. Это пока что предварительное решение, по схеме “в лоб”. С сетевой точки зрения, у данного решения есть сразу несколько больших недостатков, прежде всего – повторная отправка записанных пакетов. Мы недостатки сейчас рассмотрим и исправим. Но прежде всего важно заметить, что найден способ определить, что это за клиент стучится, приняв пакет, содержание которого выглядит для третьей стороны как поток байтов со случайными значениями.
Вероятность, что какой-то подставной пакет расшифруется так, что совпадёт и ключ, и идентификатор – настолько мала, что её можно не рассматривать. Тем более, что если так получится, то, для добротного шифра, это будет означать, что подставной клиент угадал ключ. Если же после всех вариантов расшифрования идентификатор клиента не найден, сервер отбрасывает пакет и не отвечает ничего. Да, обработка каждого входящего пакета требует выполнения многих операций расшифрования на сервере. Это неустранимая особенность: серверу придётся проверить данные по каждому клиенту. Если клиентов тысячи, то “невалидный” пакет сервер будет расшифровывать тысячи раз. Но, как отмечено выше, шифр AES нынче быстрый, а отправка наружу ответа о том, что пакет неверный – не требуется.
Теперь о других недостатках. Прежде всего, наивная схема зашифрования означает, что один и тот же клиент будет присылать одинаковый начальный пакет, потому что у клиента зафиксированы и значение ключа, и содержание пакета-приветствия. Это очень плохо, но легко исправляется, да ещё и сразу несколькими способами: например, в начало пакета в открытом виде записывается случайный вектор инициализации, который сервер использует при расшифровании (а клиент – при зашифровании). Этот вектор имеет фиксированную длину, но, поскольку значение вектора инициализации случайное, это не даёт никакой дополнительной различительной информации: к случайным данным прицепили случайные данные. Естественно, можно дописать изменяемый счётчик или слйчайный вектор внутри зашифрованных данных (см. ниже про таймстемп).
Следующий момент: если пакет имеет фиксированную длину, то при пассивном анализе можно зацепиться за эту длину. Решается тоже просто: к данным дописывается некий хвост-дополнение из случайных байтов, длина которого варьируется. Тогда у пакета образуется минимальная допустимая длина (поскольку должны войти данные приветствия), а практическая длина – изменяется от пакета к пакету. (Тут есть тонкий момент с контролем длины дополнения и дуплексным режимом для успешного соединения: дополнение нужно отбрасывать корректно, потому что иначе оно может попасть в начало следующего клиентского пакета. Но, опять же, оставим этот момент за пределами записки.)
Сервер знает длину полей в расшифрованных данных, знает, что поля идут одно за другим, может знать длину дополнения, поэтому просто отбрасывает это дополнение (где, после расшифрования, образуется некий мусор). Это всё самые простые способы, без аутентификации данных. Раз нет аутентификации, то кто-то может взять валидный пакет и дописать к нему что угодно в качестве дополнения, сделав некоторую метку. Сервер это “что угодно” вынужден будет расшифровать и если прочие данные сойдутся к валидным, то пакет будет принят в качестве приветствия. Это, на самом деле, не такая большая проблема: подобное тегирование мало что даёт, потому что для эффективного использования потребуется повторная отправка пакетов. И, опять же, есть несложное решение: используем код аутентификации сообщения, построенный на другом секретном ключе, а значение кода аутентификации дописываем в пакет. Сам код аутентификации тоже вычислительно неотличим от случайного (у нас случайный вектор инициализации), поэтому новых меток в пакете не появляется. Если аутентификация не сошлась для всех ключей, то пакет отбрасывается без дальнейшей обработки. В общем, это дополнительный затратный шаг на стороне сервера, который, в принципе, не требуется (внутри должна быть отдельная аутентификация – это другой аспект, там требуются асимметричные криптосистемы).
Только что была упомянута проблема повторной отправки валидных записанных приветствий. Третья сторона записывает трафик, выделяет валидные приветствия (это те, на которые сервер отправил ответ), а потом проигрывает эти приветствия в сторону сервера. В наивной схеме, действительно, такое сработает: сервер ответит. Однако, так как третья сторона не знает секретов, то она даже не сможет расшифровать ответ сервера. Впрочем, повторное проигрывание пакетов даёт некоторые новые направления для атак: во-первых, можно устроить зонд (connection probe), выявляющий действующие серверы – отправляем валидный пакет-приветствие на IP-адрес, если есть ответ, то там есть работающий по данному протоколу сервер; во-вторых, так как сервер вынужден на своей стороне открыть сессию, можно исчерпать доступные сессии на сервере; в-третьих, повторная отправка чужого приветствия может приводить к тому, что будет разорвано легитимное соединение того же клиента – а это уже неприятно, поскольку позволяет просто блокировать возможность использования протокола: фиксируем успешный обмен по ответу сервера – тут же отправляем ранее записанный пакет-приветствие в сторону сервера (это вообще один из хитрых моментов, который, впрочем, за пределами данной записки, посвящённой пробному расшифрованию).
Как бороться с вмешательством, котрое реализуется повторной отправкой начальных пакетов? К сожалению, эффективное противодействие – потребует некоторых дополнительных ресурсов: нужно на сервере вести таблицу состояний, – некий буфер, если точнее, – и отбрасывать все повторные пакеты по их значению (можно брать только начальные байты). А внутрь пакета-приветствия, в зашифрованную часть, нужно встроить таймстемп, и потребовать синхронного времени на клиенте и сервере. Тогда сервер ведёт запись о поступлении и успешной обработке недавних приветствий, прямые быстрые повторы – сразу отбрасывает (игнорирует), а если получено старое приветствие, то его придётся расшифровать, чтобы обнаружить, что оно устарело (по таймстемпу – тут речь о том, что допускается только расхождение на сколько-то секунд с сервером). Таким образом, проблема повторной отправки решается тоже.
Итак, в добротной реализации сервер ведёт себя тихо, с сетевой точки зрения, пока не получит валидный свежий пакет-приветствие, на который уже отвечает своим приветствием и далее может начаться сессия. Тут необходимо оговорить траспортный момент. Предположим, используется TCP. А в TCP есть собственная сессия. Соответственно, невозможно отказаться от установления TCP-сессии для того, чтобы получить начальный пакет на сервере. Это означает, что зонд может проверить доступность TCP-соединения. Конечно, само по себе TCP-соединение ещё не означает, что на сервере установлен искомый сервис, но, всё же, “наводит на мысли”. В принципе, если третья сторона анализирует трафик, то она так или иначе увидит, что к сервису кто-то подключается, поэтому само по себе TCP-зондирование ничего нового о работающем сервисе не расскажет, но вот найти подозрительный сервер-кандидат, который пока не работает, позволит. К сожалению, этот момент довольно трудно устранить. Есть способы типа port knocking (“секретный стук”), кроме того, можно ограничить доступ на уровне ядра ОС по IP-адресам источника. При этом TCP вообще позволяет несколько более эффективно ограничивать попытки повторных ложных подключений с одного IP-адреса. Но это всё полумеры.
Есть вариант с UDP. Поскольку этот протокол без сессий, то ложный зондирующий пакет будет оставлен сервером без ответа, а зонд вряд ли сможет отличить эту ситуацию от отсутствия сервиса (конечно, и тут есть свои оговорки, но от TCP – ситуация точно отличается очень существенно). UDP быстрее TCP, но могут быть проблемы с преодолением пограничных узлов, транслирующих адреса, и с тем, что в каких-то сетях UDP просто зафильтрован.
Комментировать »
Недавно я писал о том, что невнятные cybersecurity guardrails (“ограничения/препоны для кибербезопасности”) мешают LLM-системе Claude исправлять собственные же ошибки в программном коде. Поскольку эти самые guardrails начали вылезать едва ли не при каждом запросе, я переключился на теоретическую математику в своих тестах – там, как я думал, guardrails не будет. И действительно, там их нет – всё работает, что называется, “согласно описанию” – без guardrails (да, моментально съедает токены, но это другая история).
То есть, препонов кибербезопасности нет в теоретической математике “силами LLM”.
Пока что.
Дело в том, что недавно появилось очередное открытое письмо про AI/ИИ в математике, подписанное многими филдсовскими лауреатами. И вот как бы по результатам этого письма не добавили “препоны/guardrails” ещё и в упражнения LLM в области теоретической математики. Ну, чтобы ограничить угрозу. Потому что в упомянутом письме прямо признаётся определяющая для соверменной математики роль не столько ИИ/LLM, сколько корпораций, этим LLM/ИИ управляющих, и предлагается озаботиться проблемами – ну, читай, “согласовывать и ограничивать”.
Комментировать »
Обычный вариант атаки MITM для TLS подразумевает, что у перехватывающего узла (прокси) есть секретный ключ от валидного серверного сертификата (ну и сам сертификат, естественно). Тогда перехватывающий узел выдаёт себя за настоящий TLS-сервер в сторону клиента, и за клиента – в сторону настоящего TLS-сервера.
В IP-сети всякий промежуточный узел может ответить вместо настоящего, так что в сетевом смысле атака не самая трудная. Получается, что TLS-сессия установлена не между клиентом и сервером, а превратилась в две TLS-сессии: одна – от клиента до перехватывающего узла, вторая – от перехватывающего узла до настоящего сервера. Промежуточный узел принимает трафик в обе стороны и видит его в открытом виде, так как TLS-соединение между клиентом и настоящим сервером не установлено, трафик никто не защищает.
На что тут влияет клиентская аутентификация в TLS? Вот на что: штатный способ аутентификации TLS-клиента сервером, – на этапе установления соединения, – подразумевает, что клиент подписывает все TLS-сообщения, которые были переданы до настоящего момента, а это означает, что перехватывающий узел не сможет получить корректную подпись для своей сессии в сторону подлинного сервера. Чтобы это сработало, сервер должен поддерживать клиентскую аутентификацию, конечно.
То есть, буквально, TLS-клиент при помощи секретного ключа подтверждает, что получил некоторые TLS-сообщения с конкретным содержанием (там побайтово все сообщения подаются на вход хеш-функции). В случае MITM, клиент подпишет те сообщения, которыми обменивался с перехватывающим узлом, с прокси. Но состав этих сообщений отличается от сообщений, которыми перехватывающий узел обменялся с подлинным сервером (см. ниже объяснения). Подлинный сервер же – видит лишь сообщения от перехватывающего узла (и свои собственные), соответственно, проверять клиентскую подпись он будет по этим сообщениям. Подпись, присланную клиентом, перехватывающий узел передаёт без изменений. Так как сообщения различаются, подпись не сойдётся. Перехватывающему узлу не известен секретный ключ клиента, поэтому перехватывающий узел не может подписать за клиента сообщения сессии в сторону подлинного сервера. Если же сообщения прокси передавал без изменений, то это означает, что перехвата TLS не случилось, а случилось обычное TLS-соединение и прокси не сможет раскрыть трафик.
Важная оговорка: это всё верно, но лишь без учёта возможности принудительного понижения стойкости – в принципе, перехватывающий узел, активно вмешиваясь в соединение, может вынудить стороны TLS согласовать заведомо нестойкие ключи и параметры протокола. Это позволит расшифровать трафик в пассивном режиме. Однако это совсем другая схема перехвата, она гораздо сложнее, клиенты типа современного браузера лучше защищены от применения подобных атак, а в TLS давно есть дополнительные индикаторы, помогающие такую атаку обнаружить, и т.д. В общем, в записке речь идёт о максимально простой схеме перехвата – с полной подменой узла.
А что если у перехватывающего узла есть подходящий секретный ключ и дверенный клиентский сертификат? Тогда – да, перехватывающий узел сможет выдать себя за аутентифицированного клиента в сторону подлинного сервера и продолжить прозрачный перехват, просто пригнорировав аутентификационный ответ прослушиваемого клиента.
Тут есть тонкий момент: нельзя забывать, что в TLS проверить корректность подписи и валидность клиентского сертификата должен подлинный сервер. Если сервер реально использует результат аутентификации клиента, то сессия с MITM – развалится (если у перехватывающего прокси нет клиентского секретного ключа). Но это именно особенность TLS. То есть, сервер должен всё проверять, но может и не проверить. Если сервер реально не проверяет значение клиентской подписи, то перехватывающий прокси может прислать что угодно похожее на подпись и TLS-соединение продолжит работать как обычно. Ну и тем более так будет, если сервер вообще не использует клиентской аутентификации в TLS (обычное дело).
И это приводит к следующим особенностям трансляции доверия через TLS. Предположим, что есть дополнительный прикладной протокол аутентификации, работающий через TLS, но не использующий встроенную в TLS клиентскую аутентификацию. Простейший вариант: клиент вводит пароль. Понятно, что тут MITM-прокси просто пересылает запрос на пароль клиенту, а пароль от клиента – пересылает серверу. Всё прозрачно работает, прокси узанёт пароль.
Более сложный вариант: у клиента есть секретный ключ для цифровой подписи, сервер верит в открытый ключ, соответствующий этому секретному. Сервер присылает запрос на подпись некоторых данных – клиент подписывает – сервер проверяет и убеждается, что у клиента есть секретный ключ, если всё сошлось – клиент аутентифицирован. Помешает ли это MITM-прокси? Нет, не помешает. Прокси, в рамках штатного перехвата трафика, просто копирует запрос сервера, пересылает его клиенту, получает от клиента подпись, передаёт её серверу – сработало, сервер аутентифицировал клиента и незаметил вмешательство прокси. Почему это работает? Потому, что тут аутентификация не привязана к транспортной сессии: сервер проверяет, что запросы поступают от стороны, имеющей доступ к секретному ключу, парному к доверенному открытому, но не проверяет, что транспортная сессия установлена с той же самой стороной.
Что это всё означает? Вот что: представьте, что клиент авторизуется через тот или иной механизм, использующий цифровую подпись, выполняемую на стороне клиента; эта схема, с точки зрения простого MITM-перехвата TLS, не даёт дополнительной защиты сессии. То есть, всё происходит на пару уровней выше TLS: клиент что-то подписал, сервер выдал клиенту авторизационный токен, этот токен виден на стороне MITM-прокси, теперь сторона с прокси может выдать себя за аутентифицированного клиента, подпись не требуется. Если подпись потребуется, то прокси перенаправит запрос клиенту. Да, по сравнению с паролем, тут есть некоторое преимущество: секретный ключ подписи не утекает наружу. Но, с другой стороны, выгода в плане защиты информации не так уж велика: ведь MITM-прокси может попросить клиента подписать что угодно, прикинувшись подлинным TLS-сервером при помощи перехватывающего TLS-сертификата.
Комментировать »
 Новый
