Ресурсы: техническое описание TLS, LaTeX - в картинки (img), криптографическая библиотека Arduino, шифр "Кузнечик" на ассемблере AMD64/AVX и ARM64
Ещё из серии “Забавные истории с LLM”. Снова Claude. Так как на пути программного кода возводятся неожиданные “кибербезопасные препоны” (cybersecurity guardrails), я тут на днях решил попробовать задачи из области теоретической математики: там есть Lean (это инструмент описания и проверки “компьютерных доказательств”), но не должно быть “кибербезопасных препон для безопасной безопасности”. На роль примера я наобум выбрал задачу 11.115 из “Коуровской тетради” (этот широко известный в узких кругах канонический список я упоминал ранее; как оказалось, не зря упоминал). Я набросал общее описание контрпримера к задаче, в меру собственного понимания, и попросил Claude найти конкретный контрпример и подготовить соответствующее доказательство на Lean.
Система Claude существует в нескольких LLM-воплощениях, доступны мне не все, но основные, как я понимаю, доступны. Сперва я задал запрос в Fable 5. Оно почему-то зациклилось и кружилось внутри себя, наступая периодически на “лимит вызова команд”, очень долго. Наверное, часа два. Никакого результата не выдало, но “кредиты” съело (неплохая “бизнес-модель”, кстати: показываем “юзеру” какие-то меняющиеся текстовые строки в браузере через Javascript и списываем за это “кредиты” в огромных количествах). Но не будем торопиться с выводами.
Потом я решил запустить в той же ветке Opus 5 Max. Как ни странно, Opus 5 Max довольно быстро нашло контрпример (да! и очень даже похожий на правду – см. ниже), но совсем не осилило Lean. Код Lean содержал какие-то вымышленные имена теорем, которых нет в библиотеках (я не очень хорошо понимаю Lean, но, думаю, тут всё именно так). Claude Opus 5 Max – объяснило, что на своей стороне не может компилировать Lean-код: нет среды и не хватает места, чтобы развернуть из пакетов. Но без машинного доказательства все рассуждения LLM, даже такой сверхмощной, о контрпримере, даже для такой простой задачи, – мне, к сожалению, не очень-то полезны (мой план-то был другим: попытаться вручную из корректного Lean-кода восстановить привычное математическое описание контрпримера).
Казалось бы, всё опять застопорилось.
Но нет. Внезапно Anthropic выпустили Fable 5.1. Буквально, вчера. Якобы, Fable 5.1 “сильно лучше в исследовательских задачах”, чем предыдущая Fable 5. Без особой надежды на успех, попробовал я в том же чате, со сломанным Lean, запустить Fable 5.1. Как ни странно, но оно бодро заявило, что сейчас в коде Lean оставит только те библиотеки (import), которые реально нужны для этого доказательства. Это логично. И, – возможно, – среда Lean c этими библиотеками влезет в доступные гигабайты контейнера на стороне Claude, так предположило Fable 5.1. После чего, как ни странно, действительно “урезало библиотеки” и действительно исправило ошибки в Lean-коде, так что стало понятно, что имеется в виду. В итоге, выдан файл с Lean-кодом, который уже компилируется и корректен со всех точек зрения, кроме того, что там могут быть неверные исходные допущения, но это я планирую проверить позже. Так вот.
(На всякий случай: если код и контрпример окажутся правильными, то, да, это будет решение для 11.115, которая пока что отмечена в тетради как открытая. Задачу я выбрал случайно, а критерием было то, что я сам смогу быстро написать условия на контрпример – поэтому-то и задача выбрана очень простая по формулировке и составу используемых объектов. Да, LLM-системы развиваются. Но тут и контрпример – какой-то подозрительно очевидный; если кому-то интересны супертехнические подробности, то вот: построим подгруппу на словах с чётными и нечётными степенями (это отображение в Z/2Z), и подгруппу на соотношениях с a^2. Код Lean я пока не публикую, поскольку не проверил, да и это всё может оказаться “подтягиванием” другого результата, который просто забыли упомянуть составители сборника.)
Комментировать »
Столкнулся тут с очередной маректинговой уловкой Anthropic. Называется, снова, Guardrails (“Ограждения/ограничения”).
Я уже некоторое время тестирую LLM-системы, чтобы понять, на что они реально годятся в плане “кодинга” (не “вайб”!). В рамках этого процесса я попросил Claude реализовать в программном коде некий, – не самый сложный, – сетевой протокол, интенсивно использующий криптографию. Я не стану приводить детали, они не имеют отношения к теме. И вот, исходя из опыта, я подготовил очень подробное описание и протокола, и программы: “промпт”, всё на английском, как положено. По тому “промпту” система Claude Opus 5 Max, – минут за двадцать-тридцать, то есть, прямо вот очень быстро, – сгенерировала требуемый программный код, больше тысячи эффективных строк (Go, но, опять же, речь не об этом). Не сказать, что код вызывает восхищение, но он, действительно, неплохой, как программный код, и практически идеально оформлен (комментарии, разбивка по файлам и пр.). Это всё необходимо признать.
Но, не будем торопиться. Переходим к маректинговой уловке. В коде, сгенерированном Claude, я нашёл несколько существенных ошибок, пара из которых – это прямые и серьёзные уязвимости. Да, это далеко не самые очевидные ошибки. Как я понимаю, при условии написания качественного и подробного входного “промпта” (на английском!), фокусов с банальными дефектами, – типа, забытой проверки подписи, – в ведущих LLM-системах нынче уже не наблюдается. В Claude (веб-интерфейс) есть режим “ревью кода”, где можно буквально к конкретной строке написать замечание. Что я и сделал: написал подробные замечания к коду, с вариантами исправлений. Обратите внимание: Claude – генерирует код, с нуля, по моему “промпту”; я – нахожу серьёзные ошибки, показываю на них, и прошу исправить.
Что происходит дальше? А дальше система сначала “думает”, потом пишет, что, мол: “хорошее ревью”; “все ошибки отмечены верно”, “я само нашло ещё две, пока разбиралось, как исправить”; “всё признаю, начинаю исправлять”. И потом – всё. Неожиданный финал: вылезает системное сообщение, что сработали “наши ограждения кибербезопасности” (ну, хорошо, “ограничения”, конечно) и система не будет продолжать обрабатывать предлагаемые исправления. “Зарегистрируйтесь в нашей программе по кибербезопасности!”.
То есть, эта штука сперва сама сгенерировала код с уязвимостями, а потом, когда я предложил внести исправления в этот код, заявила, что тут “кибербезопасность” и исправлять, поэтому, отказывается. Но с таким уязвимостями – код использовать нельзя. Заметьте, речь не идёт о создании инструмента для “пентестинга” или о написании утилиты для “фазинга” чужого протокола. Такого нет и близко – реализовывался протокол обмена пакетами данных по сети. Код написан Claude. Реализация содержит конкретные дыры. Исправлять за собой дыры – система упрямо отказывается, упирая на “безопасность”. В чём же здесь безопасность? Загадка. Видимо, в грубом маркетинге: мы сперва что-то сгенерируем, а потом откажемся продолжать поддержку без дополнительной регистрации/оплаты.
А с широко разрекламированной Fable 5 – всё ещё сильно хуже: там эти же “ограждения-барьеры”, в точно таком же контексте исправления дефектов сгенерированного кода, срабатывают вообще едва ли не постоянно; и результат система не выдаёт, но ещё и “кредиты” за использование ресурсов – исправно списывает (в огромном количестве).
Как говорится, кто бы сомневался!
Комментарии (2) »
Вроде, удалось продлить адрес dxdt.blog ещё на один год: учитывая все “странности” – успешность продления вовсе не была очевидной. Вообще, “забавно” было бы потерять ещё и dxdt.blog, куда сайт переехал.
Комментарии (5) »
Секунду координации (leap second) хотят отменить совсем. Одна из основных причин: по мнению Международного бюро мер и весов, есть большой шанс, что к 2035 году придётся вводить “отрицательную” секунду координации. То есть, раньше, для коррекции – секунду координации добавляли. Часы, работающие по “общепринятому” источнику частоты, ждали одну дополнительную секунду в сутках, чтобы их догнали астрономические события, связанные с вращением Земли. Расчётные сутки – удлинялись на секунду. Процесс должен компенсировать “убегание” метрологических источников частоты от представления о вращении Земли, как об историческом источнике понятия о сутках. Ну или наоборот – происходило “опережение”, тут уж как посмотреть: главное, что всегда есть некая накапливаемая разница, а знак её, вроде, не так важен. Ну, пока не возникает та самая “отрицательная” секунда координации.
Вопрос этот и сам по себе весьма спорный – вращение Земли не имеет строго определения, координация зависит от используемых методов подсчёта наблюдаемых событий и т.д., и т.п. Но это всё технические мелочи, по сравненению с тем, что в 2035 году эта же трактовка может привести к тому, что нужно будет реализовать “отрицательную” секунду, то есть, “перевести часы в обратную сторону” и одну секунду удалить из привычной минуты, и из суток. Представьте, что за 23:59:58 следует 00:00:00 следующих суток! Для точных компьютерных систем это выглядит пострашнее “проблемы 2000”. Из календаря исчезает секунда, поэтому, предположим, если где-то встретится TLS-сертификат, начало действия которого обозначено как 23:59:59, но дата приходится на сутки, когда произошла коррекция, то, получается, такого таймстемпа просто не существовало. И это даже посложнее, чем если кто-то написал 23:59:63. В последнем случае, хотя бы, можно заявить о нарушении формата, а вот 23:59:59 – никаких форматов не нарушает. Нарушает ли их 23:59:60, кстати? Отдельный вопрос. Как бы там ни было, но “отрицательную” секунду координации придётся дальше учитывать во всех вычислениях с преобразованием таймстемпов в календарное время. Тут и положительная-то секунда постоянно приводит к неприятностям, что уж там говорить об отрицательной.
Так что, вполне возможно, секунд координации больше не будет, остчёт секундного времени станет “равномерным”, но зато сделают сразу час координации. Ну а что – час? К нему, предположительно, нужно будет вернуться через несколько веков (именно: см. Draft Resolution C). Так-то. Было бы кому возвращаться.
Комментировать »
Как я понимаю, большинство читателей этого блога (dxdt.blog) читают его через RSS-поток. На веб-сраницах трафик тоже есть, – и он заметно больше, – но там, реально, основная часть – это запросы разных ботов, в том числе, LLM-систем. Узел под старым адресом блога, который был в домене .RU, сейчас возвращает универсальный редирект (HTTP 301) на dxdt.blog. Это распространяется и на запросы к RSS-ленте.
И вот смотрю я в логи этого “редиректора” (то есть, на старом адресе dxdt.ru), а там всё ещё немало так GET-запросов именно на RSS-поток. Причём, если верить данным RSS-агрегаторов, которые приходят на старый адрес за RSS, там у них сотни подписчиков. Я вижу, что, после редиректа, эти же RSS-агрегаторы приходят и на dxdt.blog. С одной стороны, неплохо, что они следуют редиректу. Однако, с другой стороны, то, что эти сервисы всё ещё ходят через “редиректор”, означает, что его адрес не был вытеснен новым, а это уже плохо, потому что, как только dxdt.ru будет удалён из DNS, этот трафик, скорее всего, потеряется, а ленты в агрегаторах отломятся.
Да, я вполне понимаю логику массовых сервисов “RSS-читалок”, которую они тут применяют. Естественно, желание сохранять старый адрес, даже если там HTTP 301, вполне разумное: мало ли, что там случилось на целевом веб-узле – администратор мог сделать 301 ненамеренно, по ошибке. То есть, это здравое поведение. Идеальным было бы запоминать новый адрес, полученный через HTTP 301, но переходить на него (исключительно) только после того, как предыдущий адрес совсем исчез. Но не факт, что так сделано. Понятно, что пользователи могут переподписаться с новым адресом – но тут нужно действие от пользователя: лент у пользователя много, ожидать, что он тщательно следит за адресом каждой ленты – слишком самонадеянно.
В общем, это я вот к чему написал: сообщение на dxdt.blog – один из двух доступных мне способов проинформировать читателей о замене адреса. Поэтому напоминаю – я перенёс сайт, теперь вместо dxdt.RU стало dxdt.BLOG, если вы читаете через RSS (а это тоже правильно), то вот новый URL RSS-потока: https://dxdt.blog/feed/
Пока есть возможность, я постараюсь старый адрес сохранять с редиректом. Через какое-то время (когда дойдут руки исправить ссылки внутри сайта) я планирую на dxdt.ru выложить по URL RSS-потока отдельную запись, информирующую о том, что поток переехал на другой адрес. Опять же, это всё – если будет возможность: с доменами .RU происходит какая-то неразбериха, что там ожидать – понять я уже не могу.
Ещё раз новый адрес RSS-потока: https://dxdt.blog/feed/
Спасибо, что читаете.
Comments Off on RSS и старый адрес .RU
Вот уже два с половиной месяца на dxdt.blog используются короткоживущие TLS-сертификаты от Let’s Encrypt – серверный сертификат валиден 160 часов, новый сертификат, при штатной работе, выпускается каждые двое суток, а старый – отзывается со статусом Superseded. Поделюсь некоторым опытом.
Для короткоживущих сертификатов мониторинг необходим даже больше, чем для “обычных”. Потому что отслеживать нужно событие замены сертификата через каждые два дня: если сертификат не заменился, то “что-то пошло не так” и нужно срочно смотреть, что именно, ведь срок действия сертификата совсем небольшой. Многие типовые решения для мониторинга не приспособлены для короткоживущих сертификатов.
Серверные TLS-сертификаты данного УЦ и данного типа более не содержат имени в поле Subject. Это необходимо учитывать в мониторинге. (Обратите, кстати, внимание на этот момент – как ни странно, но мне до сих пор приходится сталкиваться со скриптами и схемами мониторинга, которые по старинке полагаются на значение Subject серверного сертификата при определении имени. Если в сертификате поле Subject пустое, такие скрипты не просто не работают, но часто вообще начинают действовать неверно – потому что пустое значение даёт интересные эффекты при попытках его обработки. Как переделать shell-скрипты, использующие OpenSSL, описано в одной из записок по теме.)
В остальном – работает неплохо. Кроме dxdt.blog, я нашёл применение для шестидневных сертификатов там, где нужен TLS-сертификат для IP-адреса. Так, у меня есть демонстрационный сайт под IP-адресом: https://185.39.19.199/ – там TLS-сертификат обновляется certbot со штатными настройками. Также я использую TLS-сертификаты для IP-адресов на некотором DNS-стенде, где такие сертификаты очень хорошо подходят для авторитативных серверов DNS (DNS over TLS: см., например, тестовый сервис для резолверов dns.1d.pw).
Комментировать »
Самое длинное задокументированное слово на древнегреческом, как считается, это вымышленное название кулинарного блюда из комедии Аристофана (название которой должно бы звучать на русском как “Экклезиастки”, но это другая тема). Слово содержит около 170 букв. Почему – “около”? Потому что количество букв зависит от прочтения и трактовок. Это слово полностью искусственное, даже если его выдумал Аристофан, но оно достаточно популярно, чтобы войти в словари. Вот я сфотографировал соответствующую статью на странице подлинного словаря Дворецкого:
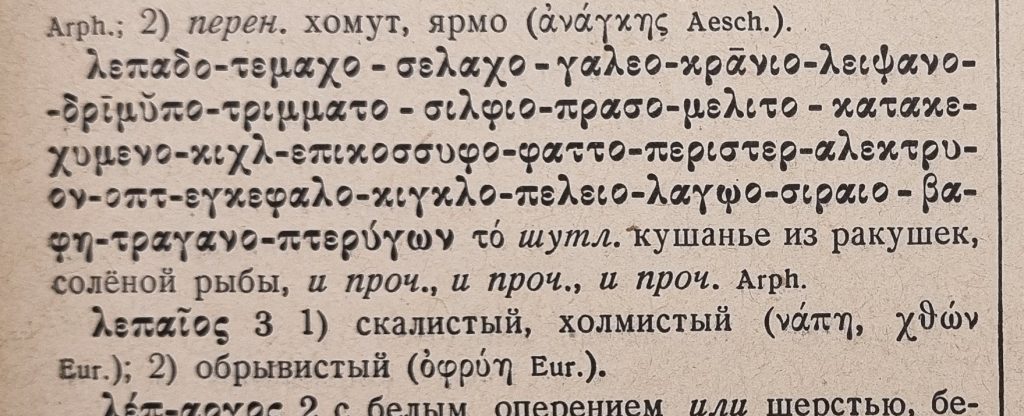
Как говорится: “и прочая, и прочая, и прочая”. В буквах эта версия выглядит, примерно, так:
λεπαδο-τεμαχο-σελαχο-γαλεο-κρᾱνιο-λειψανο-δρῑμ-ῠπο-τριμματο-σιλφιο-πρασο-μελιτο-κατακεχυ-μενο-κιχλ-επι-κοσσυφο-φαττο-περιστερ-αλεκτρυον-οπτ-εγκεφαλο-κιγκλο-πελειο-λαγῳο-σιραιο-βαφη-τραγανο-πτερύγων. (Но записывается без дефисов. Дефисы тут для упрощения отображения.)
Что это вообще такое? Строго говоря, это и не слово никакое, это некоторое составное существительное, которое древнегреческий позволяет сделать, в стиле “моллюсково-рыбо-цыплёночно-плавниковое-желе” ну и прочая, и прочие “запечён(н)ые мозги”. Некоторые составляющие этого слова в разные годы и в разных источниках читали по-разному, откуда, например, λεπαδο- против λοπαδο- в самом начале, и καραβο- против πρασο- (странно, конечно, но можно представить) в середине.
Вообще, это название иногда переводят в виде самостоятельного стиха, иногда – в виде такого же многобуквенного составного существительного, как и оригинал. Но, понятно, в сложном переводе тут смысла просто нет – данное лингвистическое построение ценно само по себе. А скан исходного манускрипта, чтобы был старше девяти веков хотя бы, да включал это слово, найти пока не удалось, поэтому перевод я тут и не привожу – не ясно, что там в исходнике.
Комментировать »
Я иногда говорю, что к JWT (веб-токену) нужно относиться так, как если бы это был “публичный документ”, что JWT мог быть “написан на заборе”. Речь тут всегда идёт о точке зрения сервера, использующего “внешние” JWT для внутренней аутентификации пользователей. Но всё равно этот момент вызывает у слушателей удивление: как так? ведь это же токен аутентификации, он позволяет получить доступ к сервису, его же нужно держать в секрете! Конечно, нужно держать в секрете, если вы клиент-пользователь и только что этот токен получили. Но если вы реализуете внешний, по отношению к провайдеру токенов, сервер, то можно ли расчитывать на то, что токен клиент “держал в секрете”? Можно ли рассчитывать на то, что получал токен именно тот клиент, который сейчас его предъявил? Правильный ответ: нет и нет, нельзя. Так что нужна совсем другая интерпретация, если вы на стороне сервера, а токен получили даже не от того, кто его выдал – токен вам принёс клиент, который, предположим, и “прочитал его на заборе”.
“Что мы знаем о лисе? Ничего. И то – не все”. Вспомним про JWT. JWT – это токены доступа (JSON Web Token), содержащие различные данные, имеющие цифровую подпись, и представленные JSON-структурой. В JWT может быть записано имя пользователя и его роль, задающая уровень доступа. Данные токена нередко не зашифрованы, а занесены в открытом виде, поэтому их легко прочитать, получив токен. Банальный способ применения JWT – носитель данных авторизации. Есть разновдности токенов по назначению, а перехват того или иного токена, в типовом режиме использования, становится равносилен перехвату роли, записанной в токене. Но эффект перехвата не всегда прямой и ограниченный. Например, при “удачном” стечении обстоятельств, если перехвачен токен “обновления” (refresh JWT), то перехвативший его может “обновить” чужую сессию и получить новые параметры доступа для чужого аккаунта. JWT сейчас едва ли не повсеместно используют в качестве носителя данных в процессах авторизации/аутентификации. Несмотря на то, что сам механизм допускает дополнительные каналы подтверждения подлинности токена сервером, его выдавшим, в подавляющем большинстве случаев – JWT используют напрямую: верят самому токену и только, и хорошо, если корректно проверяют подпись и срок действия.
Пусть токен подписан цифровой подписью. Предполагается, что секретный ключ от данной подписи принадлежит некоторому доверенному провайдеру токенов. Однако, чтобы сформировать доверие технически, можно начать верить в открытый ключ, связанный с провайдером токенов. Сам по себе JWT, что бы в нём ни было написано, доверия вызывать не должен. Правильно: ведь клиент-пользователь мог “прочитать его на заборе”.
Это как раз и означает, что для системы, которая проверяет доступы по токену, используя указанные внутри токена параметры (scope) и значение подписи, всё равно, как этот токен получен. Нельзя строить доверие только на способе получения токена, а тем более, на том, что токен принёс клиент, назвавшийся каким-то там именем.
То есть, буквально, доверие внутри системы, которая проверяет данный токен, образуется потому, что токен содержит валидную подпись от дверенного ключа, а не потому, что токен был получен каким-то “защищённым” образом. Например, с точки зрения этой системы – данный токен вообще можно считать публичным документом, сколь бы парадоксальным это ни казалось. (Ещё раз, данные внутри полей токена могут быть дополнительно зашифрованы (JWE), а чтобы их прочитать – нужно знать подходящий ключ. Но это дополнительная мера.)
Почему это всё может казаться странным? Прежде всего потому, что, в массовых сценариях веба, JWT разрешает доступ некоторому пользователю к некоторой онлайн-системе и разрешает использование некоторых функций. Соответственно, если пользователь свой авторизационный токен потерял, а кто-то этот токен – нашёл (“прочитал на заборе”), то этот “кто-то” может получить и доступ пользователя к целевой системе (полный аналог “авторизационной куки”). От действий пользователя этот доступ уже не зависит. Поэтому, конечно, пользователь должен держать свой токен в секрете. Это очевидно. Возникает ли тут противоречие? “Публичный документ”, который нужно держать в секрете? Как это? Но обратите внимание, что тут нет никаких механизмов дополнительного подтверждения для пользователя: пользователь где-то получил токен; вероятно, там он вводил пароль или ещё как-то авторизовался, но теперь токен действует непосредственно – если внутри токена, в открытом виде, написано, что это пользователь Имярек, значит, в доверяющей системе пользователь с данным токеном станет Имяреком. То есть, противоречия нет. А вся хитрость в том, что это просто так принято: считать JWT секретным и привязанным к пользователю, но без реальных проверок. Проверки возможны – об этом в конце записки.
Важный момент, про который нельзя забывать: от пользователя, авторизующегося при помощи JWT в базовой схеме, даже не требуется доказательство владения секретным ключом от подписи в токене. Считается, что ключ есть у сервиса, который выпускает токен. Соответственно, если подходить строго формально, то и авторизация тут предоставляется ключу сервиса, не пользователю. То есть, всякий может прочитать значения внутри токена (если он не зашифрован) и внешний сервис (не пользователь!) имеет полный контроль над ключом, позволяющим создавать доверенные токены, в том числе, с заданным значением полей. Это ли не “публичный документ”, при прочих равных?
Заметьте, что так как обычный JWT самодостаточен, утащить его у пользователя может и тот сервис, на котором пользователь пытается JWT применить. Другими словами: пользователь получает JWT на одном сервисе, но сам протокол подразумевает, что пользователь потом предъявляет этот токен произвольным другим сервисам, которые токен видят и могут использовать в произвольных целях. То есть, опять возникают признаки “публичного документа”.
Но если интерепртировать JWT как публичный, то, получается, и доступ предоставить можно только тот же, что получает произвольный, неавторизованный пользователь? В идеале – именно так и должно быть (и см. про расширения протокола ниже). Однако на практике – это радикально уменьшает степень полезности JWT. Да, такие “определённо публичные” JWT всё ещё можно использовать как некий инструмент подтверждения происхождения данных, например, в качестве доверенного файла конфигурации: ведь изменить параметры, не зная секретного ключа, не получится. Но от JWT ожидают некоторого прозрачного способа аутентификации “по цепочке”: то есть, какой-то другой сервис пользователя проверил, выпустил подтверждение, отдал его пользователю, и теперь это подтверждение принимается на другом сервисе как эквивалент локальной аутентификации. Удобно. Но не всегда правильно.
Вообще, история с дополнительным ограничением применимости JWT весьма важная. Например, RFC 9449 как раз описывает дополнительный механизм, который позволяет привязать JWT, выданный внешним сервисом, к открытому ключу, секретную часть которого контролирует пользователь, предъявивший JWT. При использовании JWT пользователь предъявляет и доказательство владения собственным секретным ключом. В такой схеме уже не получится использовать только лишь подписанный внешним сервисом JWT. Нужно ещё знать пользовательский секретный ключ. И это как раз полный и верный ответ на трактовку JWT как публичного документа: да, JWT – публичный, но чтобы применить его на сервисе – нужно доказать знание пользовательсткого секретного ключа, поэтому-то в этой схеме “просто прочитать JWT на заборе” уже не достаточно.
Комментировать »
Вновь пишут про успехи ИИ/LLM-систем “олимпиадного уровня”, на этот раз – про набор из задач Международной лингвистической олимпиады (IOL), где LLM-система Claude Opus 4.8 показывает “результат уровня золотой медали”.
Странно всё это.
Я некоторое время использую Claude Opus 5 Max, которая, вроде как, должна быть получше. Cправедливости ради, необходимо отметить, что вот программный код, – при компактной задаче и наличии подробнейшего пошагового описания того, что и как должна делать программа, – оно генерирует неплохой (пусть и не всегда, но – почти всегда неплохой; возможно, если доступ не отберут, я как-нибудь поделюсь впечатлениями). Однако вот языковая логика (не языка программирования, а естественная) – нередко хромает. На все три ноги из двух.
Так, недавно эта система выдала мне заведомую “дихотомию”, но с третьим вариантом. Да. Буквально:
если вы знаете пароль – тогда, [blah blah blah, текст про этот вариант];
если вы не знаете пароль – тогда, [blah blah blah, текст про вариант, когда пароль не знаем];
если ни то, ни другое (neither) – [blah blah blah, произвольный текст, который, понятно, не может относиться к поставленной задаче, где мы либо знаем пароль, либо не знаем пароль].
Но, оказывается, уровень “золотой медали” по языковым задачам был у прошлой модели. Как говорится: “что-то тут не так”. Продолжаем наблюдение.
Комментарии (2) »
 Новый
